跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序
地图列表
不限标签115开源34AI Agent33Python23提示词工程13Claude Code13TypeScript12LLM11Markdown10MIT10React9知识管理8AI图像生成8

项目搜索结果

共 115 个项目

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

内容创作主题配图

Creao 电商视觉设计系统

用结构化 Prompt 将 AI 变成 6 人设计团队,自动生成电商视觉方案

Creao 电商视觉设计系统是由 Berryxia.AI 开源的一套 AI 驱动的电商视觉设计 Prompt 工程体系。它不是传统软件或框架,而是一套结构化的系统提示词,通过模拟 6 个专业角色的协同工作,为任何产品类别生成完整的电商视觉设计包。系统输入仅需产品名称、类别、核心特性、目标用户、价格区间 5 个字段,输出 7 个核心设计模块,包括主视觉海报、卖点卡片、细节特写、场景卡片、规格说明、物流保障和行动召唤。其核心思想包括角色分工、模块化输出、信息层级驱动、场景化叙事、数据驱动优化和可扩展的品类适配。系统支持淘宝、京东、拼多多、小红书、抖音等多平台适配,并提供 A/B 测试框架。输出为文字方案,需配合设计工具或 AI 生图工具落地。

电商视觉设计多角色协同开源
09.08
opendataloader-pdf README 配图
数据与分析GitHub 项目

opendataloader-pdf

开源 PDF 解析与无障碍标注引擎,本地优先、AI 增强

OpenDataLoader PDF 是由韩国 Hancom 开发的 PDF 解析引擎,能将 PDF 转换为 AI 可消费的结构化数据(Markdown、JSON、HTML),同时是全球首个开源端到端 PDF 无障碍自动标注工具。它采用“本地确定性解析为主,AI 混合增强为辅”的核心思想:简单页面由本地 Java 引擎快速处理,复杂页面(如无边框表格、扫描件、公式、图表)路由到自托管的 AI 后端增强,全程数据不出机器。引擎提供阅读顺序识别(XY-Cut++)、边界框坐标、表格抽取、OCR(80+ 语言)、公式提取(LaTeX)、图表描述等功能,并内置 AI 安全过滤机制。项目采用 Apache-2.0 许可证,提供 Python、Node.js、Java SDK 及 CLI,支持 LangChain 集成。报告指出其基准测试成绩为开源第一(Hybrid 模式总分 0.907),但基准由 Hancom 内部测试,缺乏第三方独立验证。

第 1 页第 2 页第 3 页第 4 页第 5 页
表格抽取公式提取无障碍标注
09.08
Browser Harness README 配图
AI 智能体GitHub 项目

Browser Harness

一个让 LLM Agent 通过 Unix Socket 直连用户 Chrome 的自愈式浏览器控制框架

Browser Harness 是由 browser-use 团队开发的一个自愈式浏览器控制框架,总计约 592 行 Python 代码,直接基于 Chrome DevTools Protocol(CDP)构建。它让 LLM Agent 能够通过一个 Unix Socket 连接到用户已运行的 Chrome 浏览器,实现完全自由地完成任何浏览器任务。其核心定义是:最简单、最轻量的自愈式浏览器控制装置——Agent 在任务执行过程中发现缺少什么功能,就当场写出来补上,无需重启、无需框架更新。该项目旨在解决 LLM Agent 如何以最少的前置代码、最大的灵活性控制真实浏览器的问题。传统方案要么依赖重量级框架(如 Playwright、Selenium),要么把所有交互逻辑预先编码。Browser Harness 反其道而行,只提供一个极薄的 CDP 桥接层(daemon + helpers),剩下的能力由 Agent 在任务执行中即时编写。

浏览器自动化自愈式AI Agent
09.08
AI 智能体主题配图

逸尘开源Skills + 社区精选Skills

开源21个Claude Code/Codex Skills,覆盖微信数据解析、记忆系统与多模型协作

该收藏整理自X用户@genngdaJ(逸尘)的热门帖子,一次性开源了自用的8个Claude Code/Codex Skills,并推荐了多位社区大佬的优秀Skills。Skill是Claude Code/Codex的扩展能力模块,一段预先写好的指令(SKILL.md)加可选的脚本和Agent,让AI Agent获得特定领域的专业能力。帖子精选的8个Skills包括:全网搜索与归档、Agent记忆系统、微信本地数据解析、企业微信聊天解析、企业微信云端操作、公众号文章批量抓取、ChatGPT网页调研、X文章草稿上传。仓库实际包含21个Skills,涵盖视频转写、剪映对接、小红书/抖音采集、社交收藏导出等更多能力。核心设计原则是安全第一(只读+授权)、本地优先(数据不出Mac)、无副写(不自动发布/下载)、碰撞安全(不覆盖文件)。

安全设计本地优先多模型协作
09.08
yetone 的 GitHub 头像yetone/native-feel-skill
AI 智能体GitHub 项目

Native Feel Skill - 跨平台桌面应用原生体验架构

一套让 WebView 渲染的 UI 无法被用户分辨为原生应用的 AI Agent 技能包

Native Feel Skill 是一个 AI Agent 技能包,由开发者 yetone 创建,将 Raycast 2.0 的跨平台桌面应用架构经验提炼为可复用的结构化领域知识。它包含 8 条架构准则、四层架构方案(原生外壳 → 系统 WebView → Node 后端 → Rust 内核)、WebKit/WebView2 生存指南、75 项上线检查清单、IPC 契约设计指南、内存真相手册及 Raycast Beta 逆向证据。该技能包主要解决跨平台桌面开发中开发效率与原生性能不可兼得的问题,通过精确定义共享与原生边界,在 WebView 渲染表面画线,上方共享 React/TS 代码,下方使用原生 Swift/C#,让用户无法分辨是否为原生应用。安装到 Claude Code、Cursor 等兼容 AI Agent 后,讨论跨平台桌面应用架构时自动激活,提供架构建议、问题诊断和优化方案。

技能包架构跨平台桌面
09.08
知识管理主题配图

LLM Wiki — 用 LLM 构建持久化个人知识库

让 LLM 成为知识库的编译器和维护者,实现知识的持续积累与复利增长

LLM Wiki 是 Karpathy 于 2026 年 4 月提出的一种用 LLM 构建和维护个人知识库的方法论。其核心主张是不再把 LLM 当作临时问答工具,而是让它成为知识库的编译器和维护者,像程序员维护代码库一样,持续读取源材料、写入 Wiki 页面、更新交叉引用、标记矛盾。该方法论横跨个人知识管理、LLM 应用范式和知识编译三个领域,旨在解决传统 RAG 模式没有知识积累、无法发现矛盾、无法跨文档综合、查询结果无法沉淀以及人类维护负担过重等痛点。其核心思想是让 LLM 成为知识库的编译器和维护者,而非临时检索引擎。底层基于三层架构:Raw Sources(原始源材料)、The Wiki(知识库)和 The Schema(配置规范),并通过 Ingest(摄入)、Query(查询)、Lint(健康检查)三个核心操作实现知识的增量编译和持续维护。该方法论适合长期深度研究、个人知识管理等场景,但存在 Token 消耗高、冷启动成本高、幻觉风险等局限。

知识编译知识管理Git
09.08
crafter-station 的 GitHub 头像crafter-station/petdex
开发工具GitHub 项目

Petdex

面向 OpenAI Codex CLI 的动画宠物公共画廊平台

Petdex 是一个面向 OpenAI Codex CLI 的动画宠物公共画廊平台,由 crafter-station 组织维护。它解决了 Codex 宠物散落在 GitHub、Reddit 等各处,缺乏统一浏览、预览和安装入口的问题。平台提供公共画廊,支持按类型、颜色、风格分类浏览,每个宠物可预览所有动画状态。用户可通过 `npx petdex install <name>` 一行命令安装宠物。宠物由社区创作和提交,平台提供自动审核(OpenAI LLM)与人工审核双重机制。此外,平台支持合集(Collections)、排行榜、个人图鉴以及社区宠物请求匹配功能。技术栈为 Next.js 15 + TypeScript + Bun + Drizzle ORM + Neon Postgres + Cloudflare R2 + Clerk 认证,采用 MIT 开源协议。截至 2026 年 5 月,平台已收录 1146+ 个社区提交的宠物。

BunClerkCloudflare R2
09.08
Magic Resume README 配图
内容创作GitHub 项目

Magic Resume

开源在线 AI 简历编辑器,所见即所得,数据本地存储

Magic Resume 是一款开源的在线 AI 简历编辑器,由开发者 Siyue 创建并维护。它提供所见即所得的编辑体验,左侧编辑内容,右侧实时预览最终效果。所有简历数据存储在浏览器 localStorage,不上传服务器,从根本上解决隐私问题。内置 AI 辅助写作,支持 Gemini、DeepSeek、豆包等多个大模型,可进行内容润色、语法检查和简历导入。基于 TanStack Start、Tiptap v3、Zustand 等现代技术栈构建,支持多套模板和深色模式。PDF 导出时自动调整字号和间距,确保简历恰好一页。采用 Apache 2.0 开源协议,个人使用免费,商业使用需单独授权。支持 Docker 一键部署,无需数据库和后端。

简历编辑器开源AI辅助
09.08
fireworks-tech-graph README 配图
开发工具GitHub 项目

fireworks-tech-graph

用自然语言描述系统,几秒钟生成可嵌入文档的 SVG+PNG 技术图表

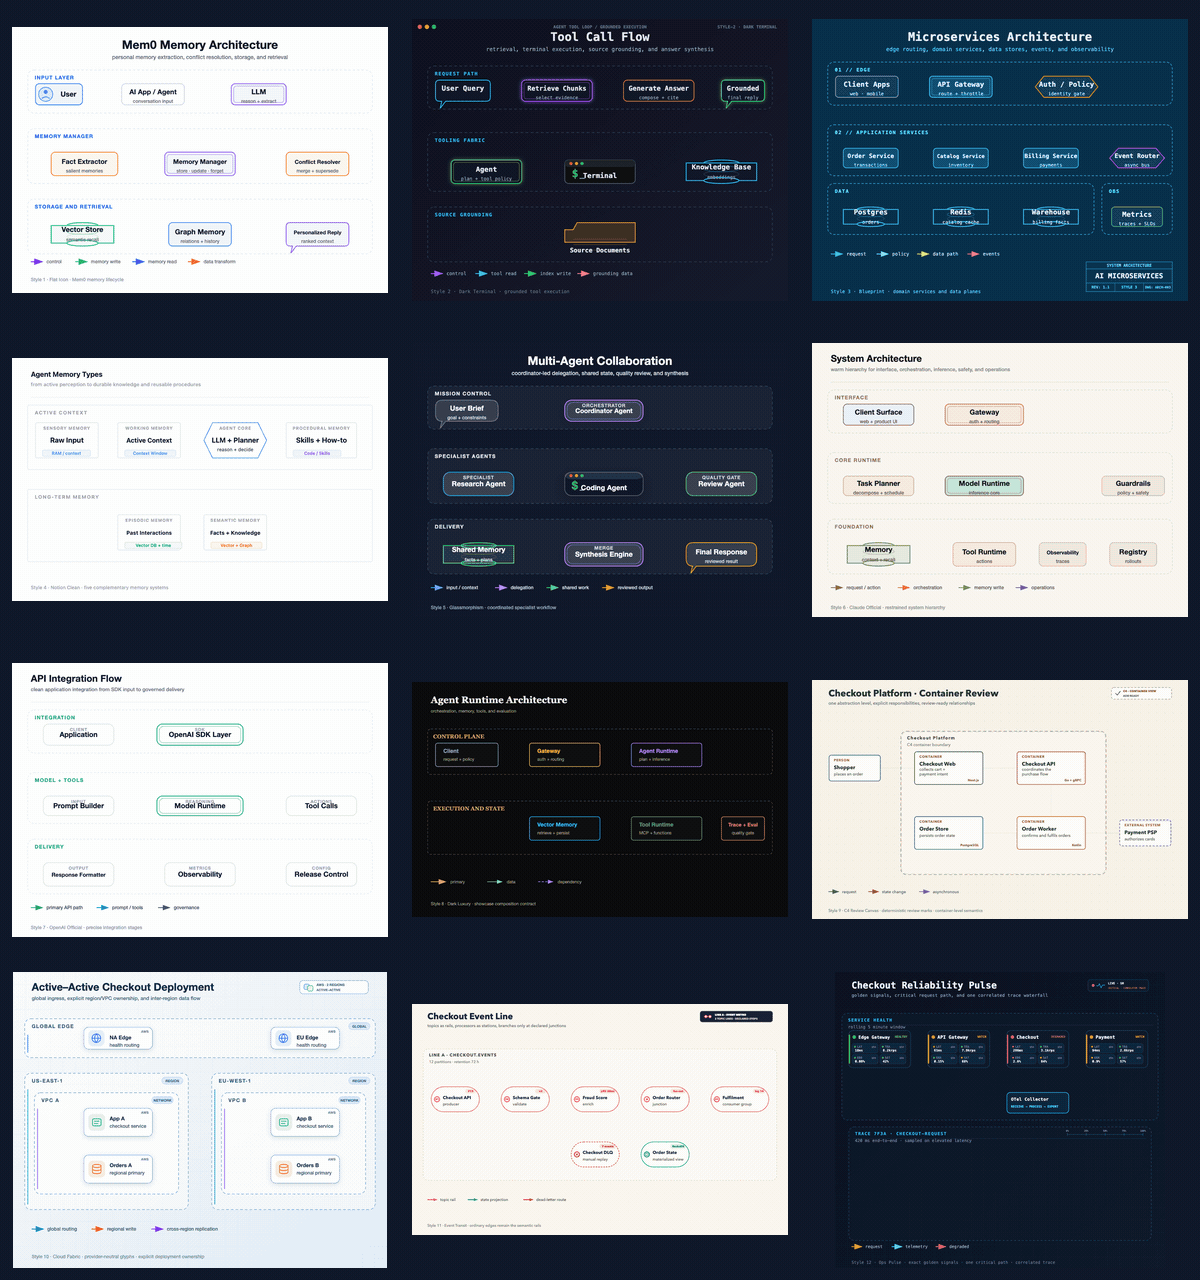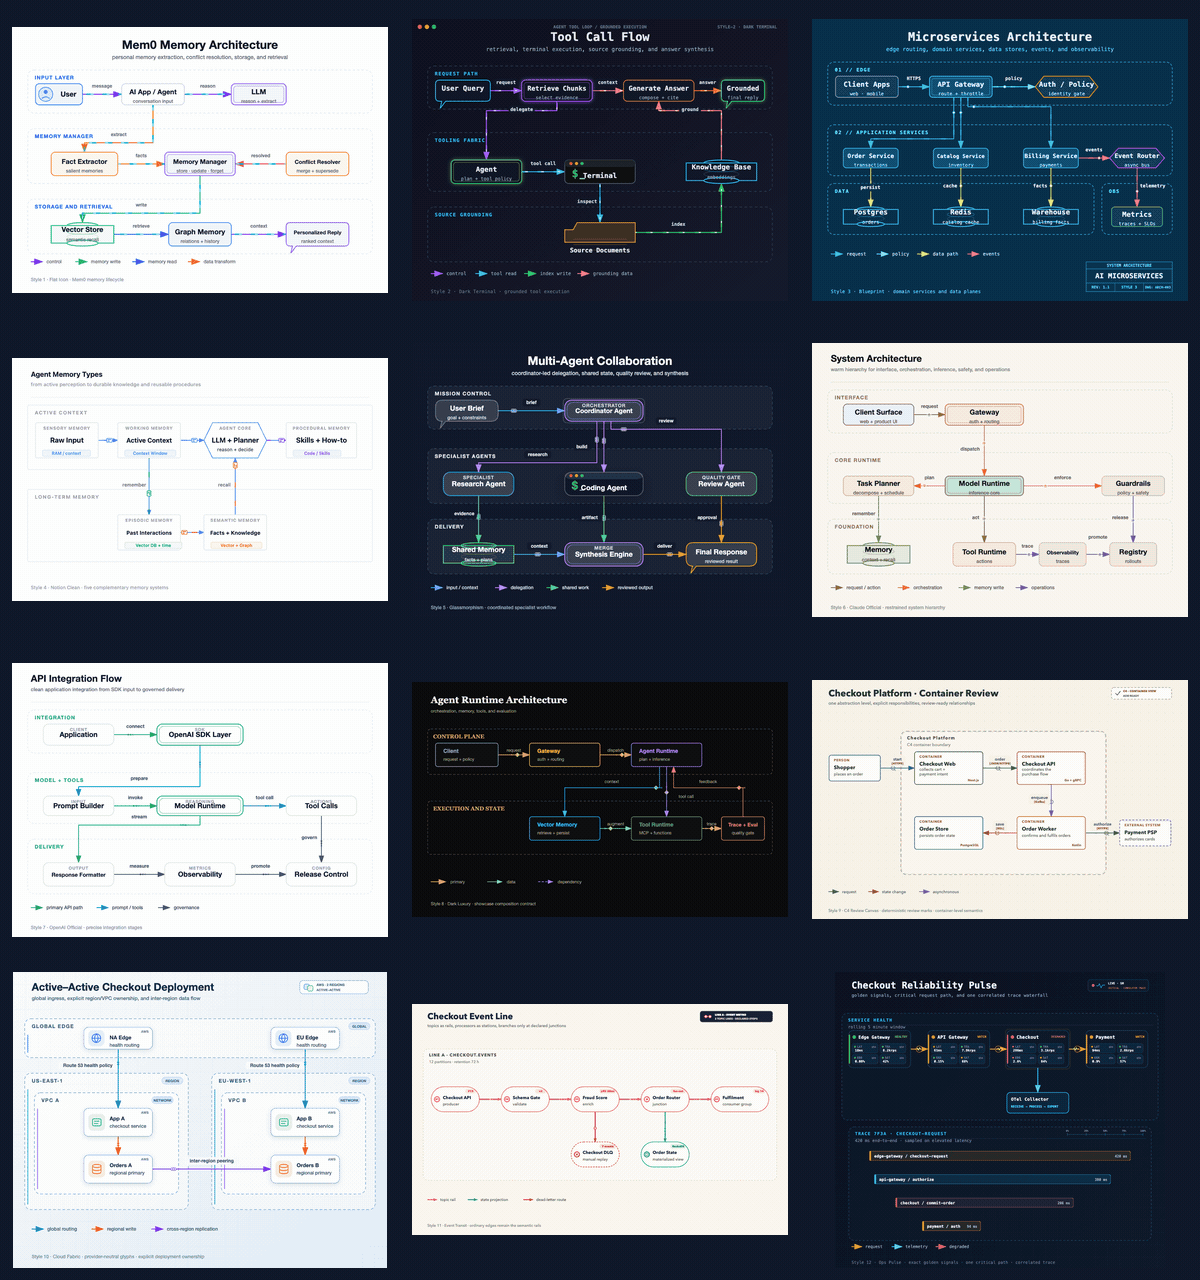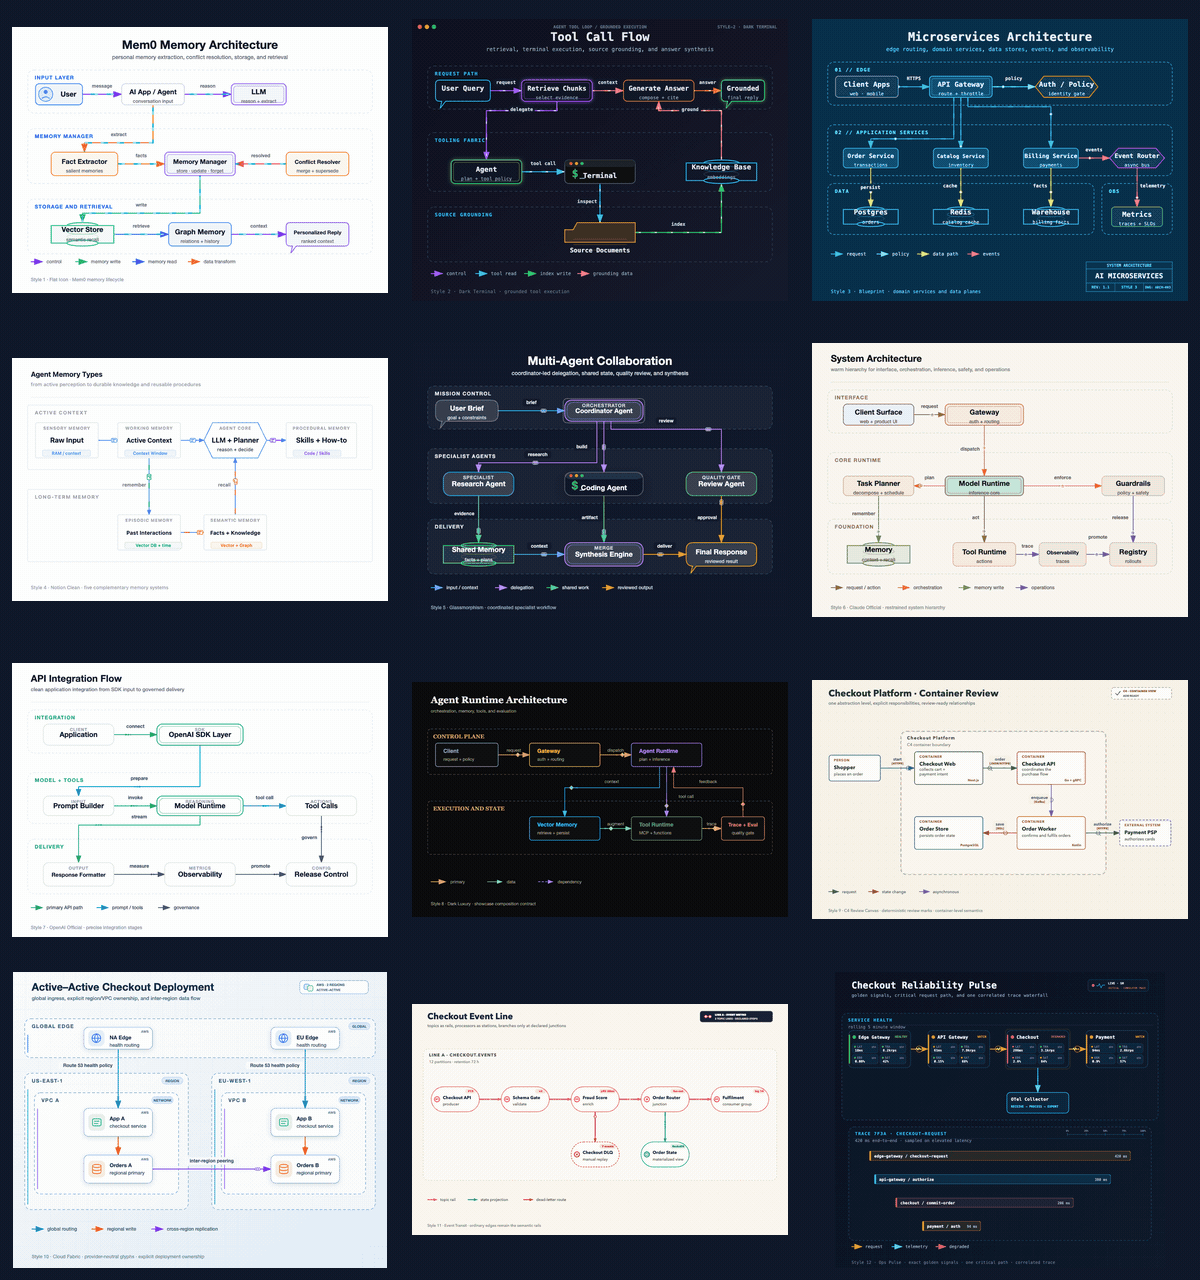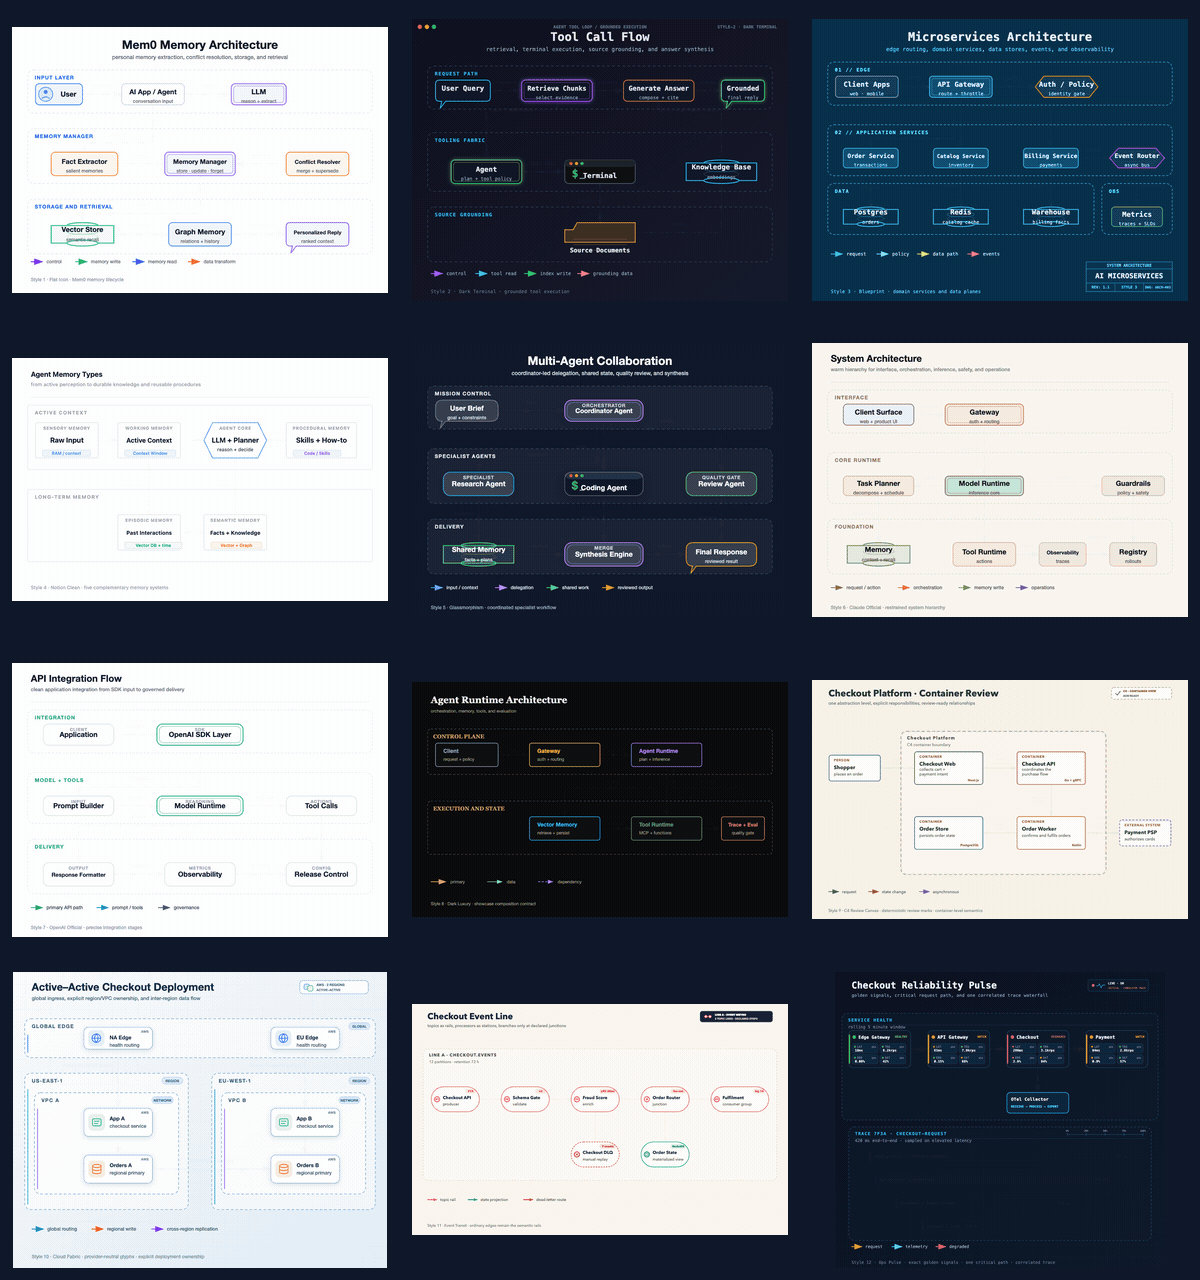
Fireworks Tech Graph 是一个专为 Claude Code 设计的开源 Skill,能够将自然语言描述直接转换为生产级质量的 SVG + PNG 技术图表。它支持 8 种图表类型、5 种视觉风格,并内置了深厚的 AI/Agent 领域知识(RAG、Agentic Search、Mem0、Multi-Agent、Tool Call 等)。核心解决的问题是让开发者和技术写作者不用学习任何图表 DSL(如 Mermaid 语法、PlantUML、Graphviz DOT),也不用打开 draw.io 等可视化编辑器,只需要用自然语言描述系统,就能获得出版级的技术图表。它本质上是一套注入到 Claude Code 中的专业绘图知识和规则体系,包含 9 步固定工作流、语义形状系统、语义箭头系统、5 套完整的视觉设计系统、40+ 产品图标库以及 AI/Agent 领域的 7+ 内置架构模式。输出为可编辑的 SVG 文件和 1920px 高清 PNG 文件,完全离线使用,不依赖外部 API 或 CDN。

技术图表开源自然语言生成
09.08
openai 的 GitHub 头像openai/privacy-filter
开发工具GitHub 项目

OpenAI Privacy Filter

OpenAI 开源的本地化 PII 检测与脱敏模型,支持 128K 长文本与浏览器端运行

OpenAI Privacy Filter 是 OpenAI 于 2026 年 4 月 17 日开源的双向 Token 分类模型,专注于文本中个人可识别信息(PII)的检测与脱敏,属于 NLP 安全/隐私合规技术体系。其核心定位是为企业级数据清洗流水线提供一个可本地部署、高速、上下文感知且可调优的 PII 检测模型。模型采用自回归预训练加双向分类微调的方式,总参数量 1.5B,但通过稀疏 MoE 架构,每个 Token 仅激活 50M 参数,可在浏览器和笔记本上运行。模型支持 128,000 tokens 的上下文窗口,使用带状注意力将计算复杂度从 O(n²) 降至 O(n×w)。它可检测账号、私人地址、私人邮箱、人名、电话号码、私人 URL、私人日期等 8 类 PII,并通过约束 Viterbi 解码保证标签序列连贯。模型采用 Apache 2.0 许可证,支持 PyTorch、ONNX、Transformers.js 等多种部署格式。

本地部署数据脱敏隐私合规
09.08
ahang008 的 GitHub 头像ahang008/ah-xhs-cover-title
内容创作GitHub 项目

ah-xhs-cover-title

短视频封面标题生成器,基于85条爆款公式进行可追溯路由匹配

ah-xhs-cover-title 是一款短视频封面标题生成器,由开发者 ahang008(阿航)于 2026 年 4 月 22 日开源发布,以 Claude Code Skill 形式运行。用户输入文章、选题或核心观点后,系统自动从 85 条经过验证的爆款封面公式中进行路由匹配,生成标题和封面三行文案。其核心是双层分类体系(8 种钩子手法 × 6 条内容赛道)和三层路由决策机制(识别赛道、匹配钩子、锁定拆法),每条输出都标注钩子代号和案例编号,实现可追溯。工具支持自然语言反馈迭代(如“再来几条”“换个方向”),并配套四种封面三行拆法模板。项目采用 MIT 协议,即开即用,无需训练。

案例库标题生成短视频
09.08
内容创作主题配图

Seedance 2.0 提示词工程

用镜头语言导演 AI 视频:Seedance 2.0 提示词工程方法

Seedance 2.0 是字节跳动推出的 AI 视频生成模型,支持文字、图片、视频和音轨等多模态输入,在单次推理中生成音画同步的短视频。本条目整理了其提示词工程方法,核心是将“感受描述”翻译为“执行序列”,通过五层公式(主体、动作、镜头、风格、约束)构建提示词,并利用时间编码和参考文件实现精细控制。报告指出,主体描述需具体到年龄、发型、服装等属性;动作应分解为具体执行序列;镜头每代只放一个主运动;风格优先写光线和质感;约束词用于减少抖动、变形等 AI 痕迹。此外,时间编码支持按秒调度画面,参考文件(最多 9 图、3 视频、3 音轨)可提升一致性。报告还介绍了单变量迭代优化方法,并列举了 UGC、产品广告、短片等应用场景。

多模态内容创作视频生成
09.08
其他项目主题配图

一人电商 GitHub 工作流(changedetection.io + PicPilot + Medusa + n8n + Chatwoot)

用5个开源工具串联选品到客服,构建可自托管的一人电商全链路工作流

这是一套基于5个开源项目组合而成的一人电商全链路工作流,覆盖从选品到客服转化的完整电商运营链路。它不是一个单独的技术框架,而是通过将5个成熟的开源工具串联起来,构建一支"虚拟电商团队"。该工作流属于开源电商工具链体系,不绑定任何单一平台,所有组件都可以自托管,数据完全掌控在自己手中。它通过 changedetection.io 解决选品研究,PicPilot 处理素材生成,Medusa 搭建无头电商后端,n8n 实现工作流自动化,Chatwoot 提供全渠道客服。核心思想是用开源工具替代团队角色,用自动化工作流替代人工协调,让一个人具备完整电商运营能力。报告指出其适合有基础技术能力、重视数据自主权、追求高度定制化的个人或小型团队,但不适合完全没有技术背景、只求快速上线的纯运营型卖家。

电商工作流自动化开源
09.08
TrendRadar README 配图
AI 智能体GitHub 项目

TrendRadar

AI 驱动的多平台热点聚合与智能推送工具

TrendRadar 是一款 AI 驱动的舆情监控与热点聚合工具,由开发者 sansan0 于 2025 年 4 月创建。项目定位为面向信息过载时代的一站式热点助手,核心能力包括一键聚合 35+ 平台实时热点(如抖音、B 站、知乎、微博、头条、财联社、华尔街见闻等),通过 AI 智能筛选、翻译和深度分析,生成趋势预测、情感洞察、跨平台关联等简报,并支持 10+ 智能推送渠道(企业微信、微信、飞书、钉钉、Telegram、邮件、Slack 等)。项目采用时间线智能调度,针对早高峰、晚上、周末等不同时段配置不同推送策略。技术栈包括 Python、GitHub Actions、GitHub Pages、Docker 和 MCP Server,开源协议为 GPL-3.0。项目支持 MCP 架构,可接入 AI Agent 生态,实现自然语言对话分析。

热点聚合信息推送舆情监控
09.08
PDFMathTranslate README 配图
开发工具GitHub 项目

PDFMathTranslate

开源 PDF 科学文档翻译工具,翻译全文并保留公式、图表与排版。

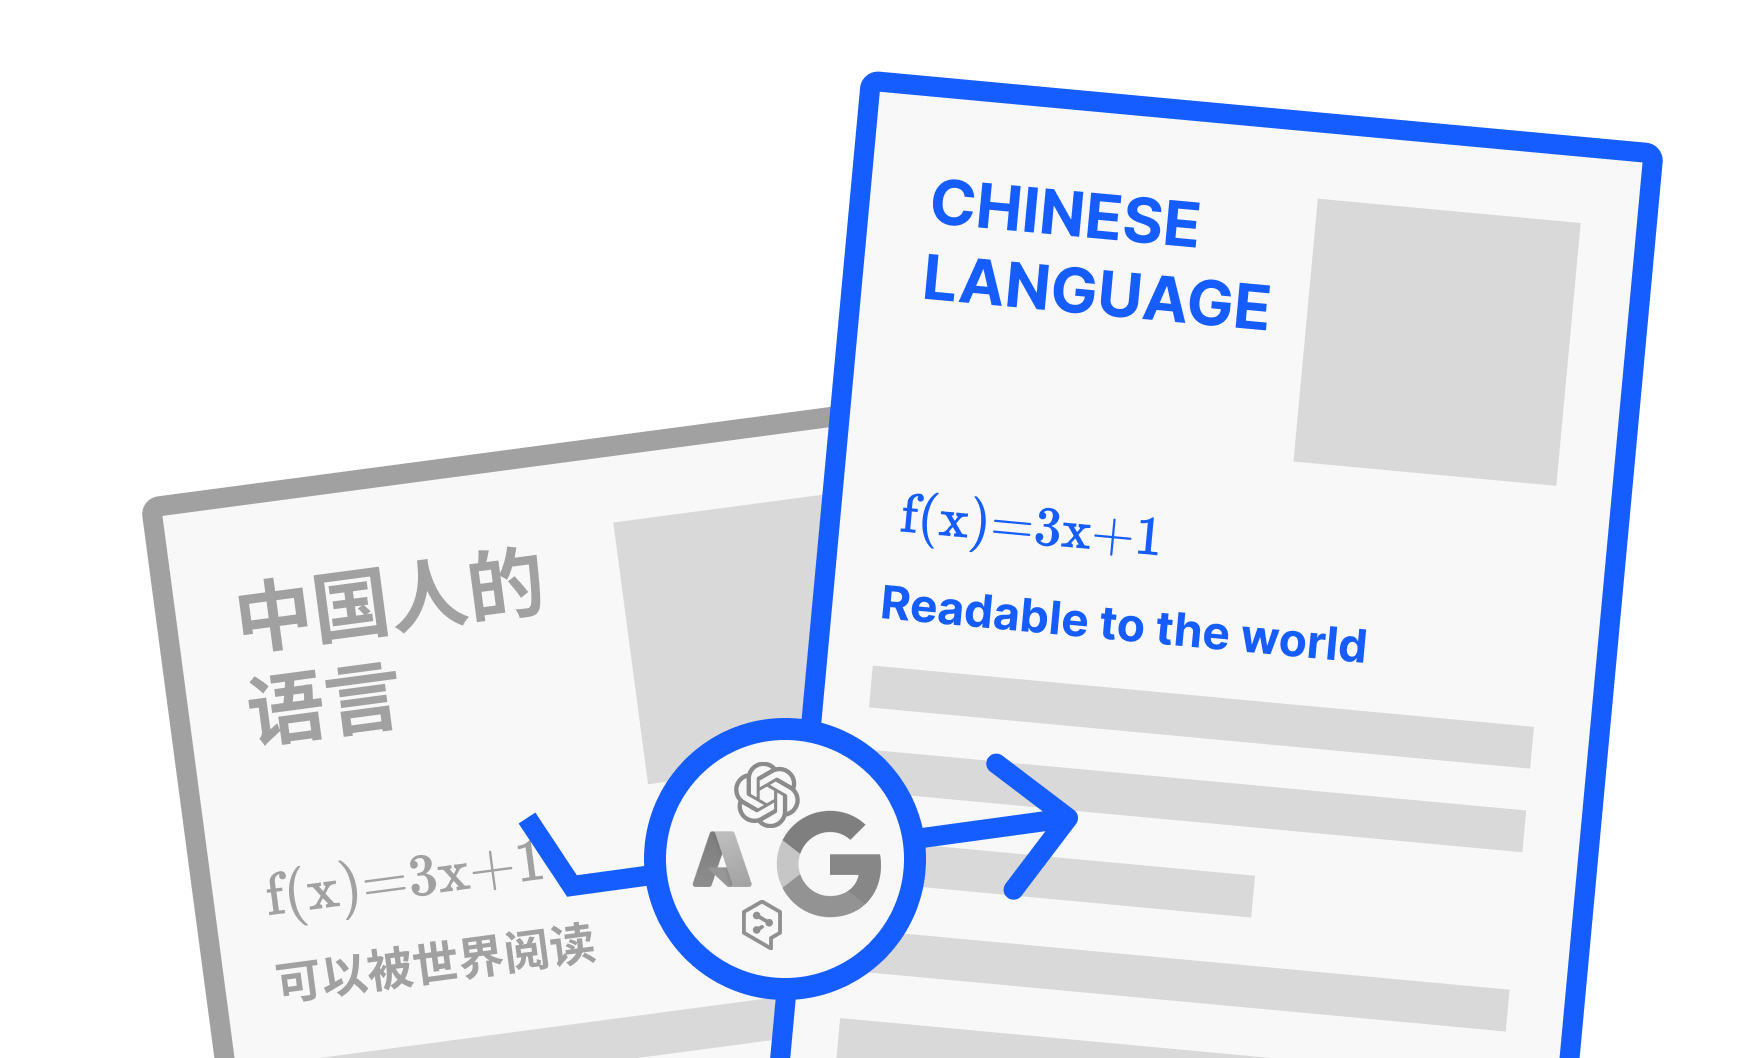
PDFMathTranslate(命令行工具名 pdf2zh)是一个开源的 PDF 科学文档翻译工具,其核心能力是在翻译 PDF 全文的同时,完整保留原始排版、数学公式、图表、目录和批注。它通过 PDF 解析、元素分类、文本翻译、原位回填四个阶段处理文档,使用 DocLayout-YOLO 模型识别并跳过公式区域,避免公式被翻译引擎误读。翻译引擎可插拔,支持 Google、DeepL、OpenAI、Ollama 等十余种后端,并支持 CLI、GUI、Docker、MCP Server、Zotero 插件等多种部署形态。工具同时生成纯译文版和双语对照版,满足不同阅读需求。项目以 AGPL-3.0 许可证开源,论文被 EMNLP 2025 录用。

机器翻译开源文档智能
09.08
伯乐 Skill / ai-news-radar README 配图
AI 智能体GitHub 项目

伯乐 Skill / ai-news-radar

AI 信息源智能筛选系统,先判断再接入

伯乐 Skill(Scout Skill)是基于开源项目 ai-news-radar 构建的 AI 信息源智能筛选与新闻雷达系统,由 LearnPrompt 创始人卡尔的AI沃茨开发,2026 年 5 月发布 v0.4.0。其核心定位不是又一个新闻聚合站,而是帮助用户从一堆信源里选出千里马的 AI 信息源筛选系统。它解决 AI 从业者追踪行业动态时的信息淹没、原始来源丢失、接入方式差异大、个性化需求无法满足、缺乏健康评估机制以及 Agent 自动化维护门槛高等痛点。核心设计思想是“先判断,再接入”,在信息源层面做第一轮判断,区分一手源与聚合源,并尊重每个源的原生接入方式。系统支持九类信源,内置 22 个默认信息源,通过六阶段 Pipeline 完成信源分类、抓取、去重、过滤、健康统计和静态站点生成。核心流程不依赖大模型 API,也不需要服务器,运行在 GitHub Actions 和 GitHub Pages 上,每 30 分钟自动更新。

静态站点生成开源信息源评估
09.08
AI-CanvasPro README 配图
内容创作GitHub 项目

AI-CanvasPro

基于节点的 AI 多模态画布编辑器,通过可视化连线编排文本、图像、视频与音频生成

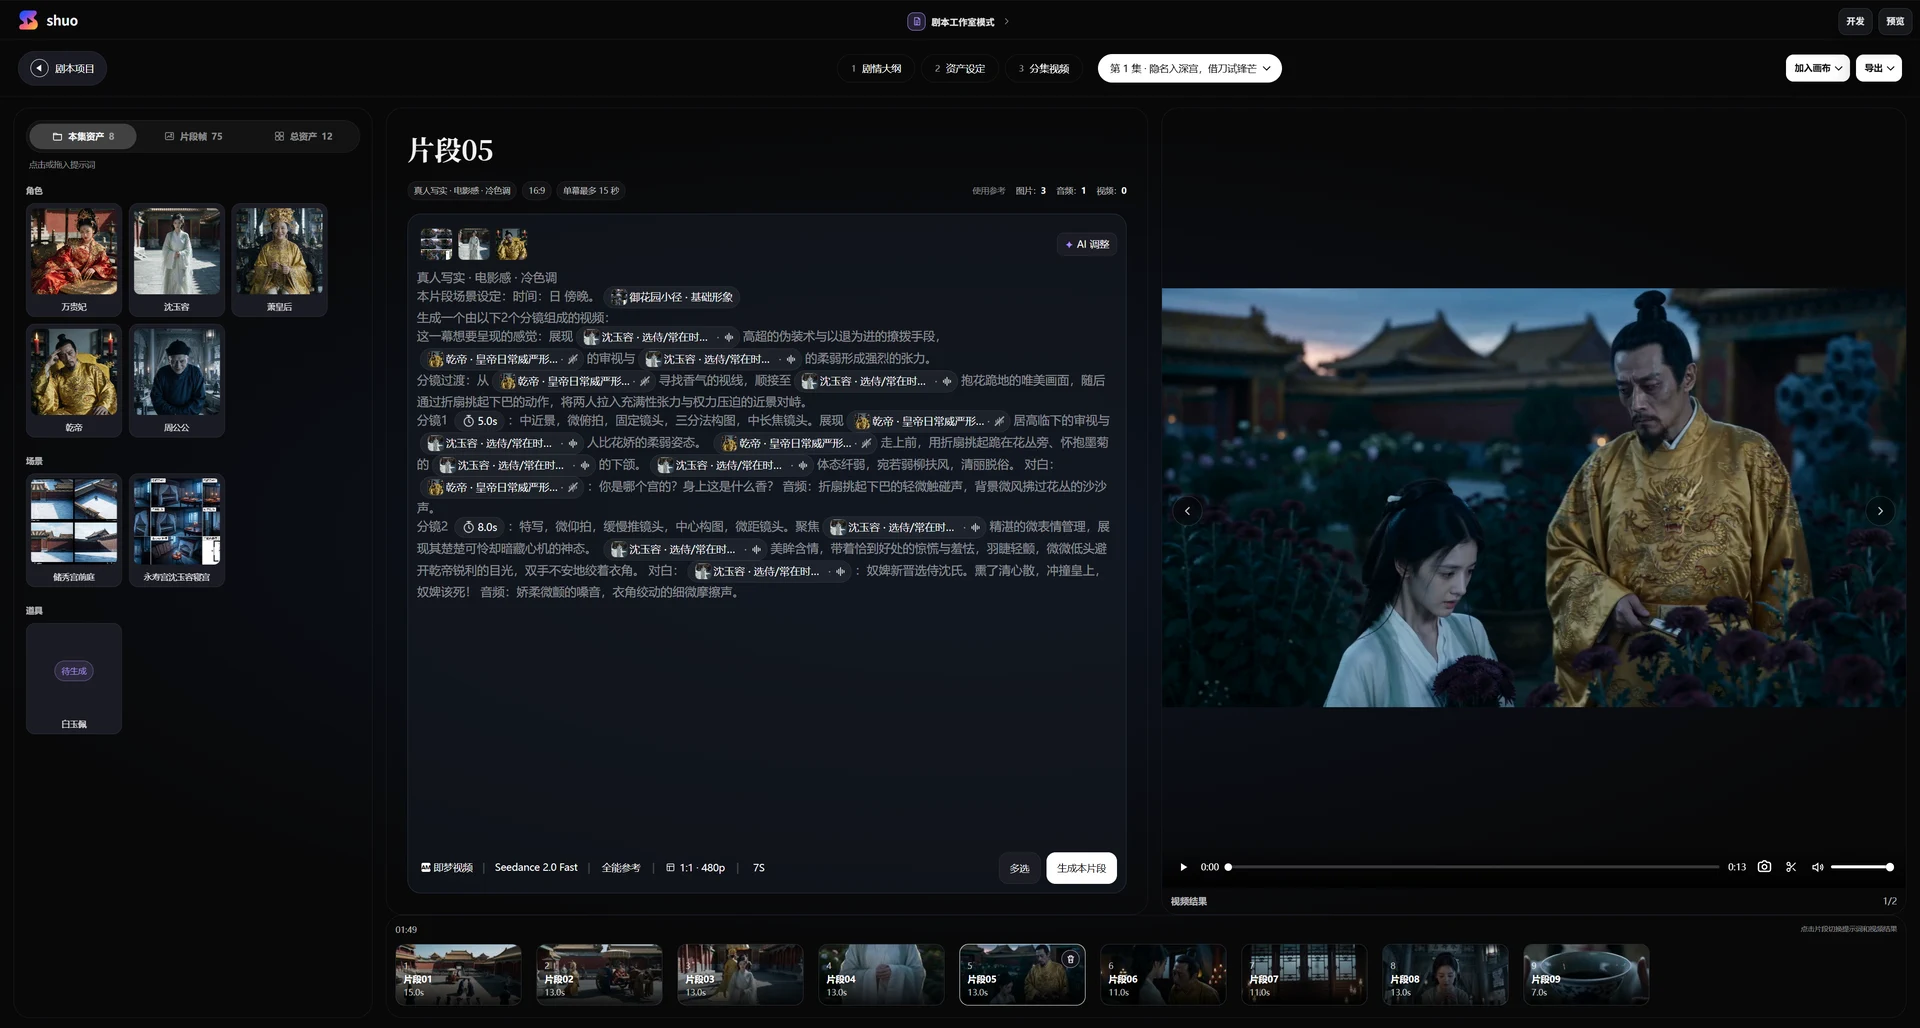
AI-CanvasPro 是一款基于节点的 AI 多模态画布编辑器,由独立开发者阿硕(ashuoAI)打造,采用纯原生 HTML/CSS/JS 前端与 Python 后端,支持 Windows、macOS 与 Web 平台。它通过无限画布上的可视化节点连线,让用户组合文本、图像、视频、音频等 AI 能力,实现多模态内容的一站式创作。项目定位为 ComfyUI 的“轻量中文替代”,中文原生支持,无需本地 GPU,通过 API 调用即梦、RunningHub、PPIO、GRSAI 及 OpenAI 兼容接口等云端模型。核心机制包括连线数据流、@引用跨节点嵌入、多供应商适配、资产与工作流复用,以及遮罩重绘、抠图、高清放大等图像编辑工具链。项目采用 Source Available 许可证,禁止商业使用。

本地部署画布编辑器节点式工作流
09.08
内容创作主题配图

AI小红书九宫格图文生成提示词工程

用LLM生成结构化提示词,再交给图像模型产出可切割发布的小红书九宫格大图

这是一套利用大语言模型自动生成高质量图片提示词,再交给AI图像生成工具产出可直接发布的小红书九宫格内容的工作流方法。核心不在于让AI直接画图,而在于让AI先设计完整的图文方案,包括视觉风格、排版结构、每格内容和配色方案,然后一次性生成一张可切割的九宫格大图。该方法由程序员Austin在2026年4月公开分享,帖子获得58赞、7转发、76条评论和4600+浏览。它属于AI辅助内容创作领域,是方法论、工作流与提示词模板的组合,不依赖特定平台,只要有LLM和图像生成工具就能使用。报告指出,传统流程制作一组九宫格可能需要2-4小时,而用AI工作流可以压缩到15-30分钟。

工作流九宫格提示词工程
09.08
AI 智能体主题配图

Claude Code 源码深度分析

深入解析 Claude Code 的工程体系:从动态提示词编排到工具治理与多 Agent 协作

本报告基于对 Claude Code 源码的深度分析,揭示了其作为 AI 编程助手的核心工程体系。报告指出,Claude Code 的价值不仅在于提示词,更在于一整套将行为制度、工具治理、Agent 分工、上下文经济学和生命周期管理连成闭环的系统。其动态 System Prompt 编排将静态“宪法”与动态“当期政策”分离,并通过缓存友好边界优化成本。工具调用经过完整的治理流水线,包括输入校验、权限检查、风险预判和 Hook 拦截。系统内置多个专职子 Agent,如 Explore、Plan、Verification,实现角色分离,避免利益冲突。此外,报告还介绍了 Skill、Plugin、MCP 三套扩展机制,以及上下文经济学中的缓存复用、按需加载等策略。报告也指出了其学习曲线陡峭、成本较高、依赖 Anthropic API 等局限性。

多Agent调度工具治理上下文管理
09.08
内容创作主题配图

md2wechat

面向微信公众号的 Markdown 转 HTML 排版与全流程创作 CLI 工具

md2wechat 是一款专为微信公众号设计的 Markdown 转 HTML 排版及全流程创作 CLI 工具,由开发者 geekjourneyx 创建,GitHub 2.1k+ Stars。其定位是“AI 时代的公众号创作工作台”,覆盖从写作、去 AI 痕迹、排版、AI 配图到推送草稿箱的完整流程。工具采用 Go 1.26+ 实现,提供 40+ 专业主题(Minimal / Focus / Elegant / Bold 四大系列)和 43 个结构化 `:::block` 高级排版模块。架构上分为 AI 模式(免费,生成 prompt 由 LLM 执行,输出不确定)和 API 模式(专业服务,确定性输出,需付费)。md2wechat 为 Agent 集成设计了完整的发现协议,原生兼容 Claude Code、Codex、OpenClaw。许可证为 BUSL-1.1,个人/学习/非商用免费,商用需授权,2030-01-01 后自动转为 Apache 2.0。

内容创作排版微信公众号
09.08
Guizang PPT Skill README 配图
AI 智能体GitHub 项目

Guizang PPT Skill

将十年设计经验压缩为规则文件,让 AI 按杂志级排版生成单文件网页 PPT

Guizang PPT Skill(magazine-web-ppt)是由设计师歸藏(op7418)开源的一个 Claude Code / AI Agent Skill,用于生成单文件 HTML 横向翻页网页 PPT,视觉基调定位为“电子杂志 × 电子墨水”。它不是一个 PPT 编辑器,而是一套“人 × AI 协作做 PPT”的接口,把十年设计经验压缩成一个 SKILL.md 规则文件,让 AI 按照专业杂志排版规则自动生成网页幻灯片。项目发布于 2026-04-24,采用 MIT 协议,语言为 HTML 100%,拥有 396 Stars 和 60 Forks。核心工作流包括 6 问需求澄清、大纲与叙事弧规划、拷贝模板并选主题色、类名预检与主题节奏规划、挑选布局并填充内容、Checklist 自检。产物为单文件 index.html,浏览器直接打开,零依赖。

单文件应用开源杂志排版
09.08
AI 智能体主题配图

AI Agent 技能工具

面向 AI Agent 的影视解说自动化与互联网信息获取技能工具

本收藏条目涵盖两个面向 AI Agent 的技能工具:Narrator AI CLI Skill 与 Agent Reach。Narrator AI CLI Skill 是专为 AI Agent 设计的视频解说自动化技能文件,对应 CLI 客户端 narrator-ai-cli,封装了 Narrator AI 开放平台的完整 API,支持 Claude Code、OpenClaw、Windsurf 等主流 AI Agent 平台。其核心能力是用一句自然语言指令,自动完成从脚本生成到成片输出的全流程影视解说视频生产,内置 93 部电影素材库、146 首 BGM、63 种配音音色(覆盖 11 种语言)、90+ 解说模板,提供「改编解说」和「原创解说」两条工作路径。Agent Reach 是一个开源的 AI Agent 互联网能力脚手架,由 Panniantong 开发,作为一键安装器和配置管理器,将 15+ 个平台的内容读取能力(如 Twitter、Reddit、YouTube、B站、小红书、GitHub、微信公众号、抖音、LinkedIn、微博、V2EX、雪球、RSS 等)集成到任何 AI Agent 中,核心价值是零 API 费用、零配置门槛,所有底层工具均为开源免费的 CLI 工具,通过本地 Cookie 和抓取方式访问平台内容,数据只留在本地。

脚手架视频解说信息获取
09.08
内容创作主题配图

GPT-Image-2 地景档案模型提示词

一套将地标建筑转化为博物馆展陈感档案模型视觉图的六层参数化提示词方法论

「地景档案模型 / Landscape Archive Model」是 @MrLarus 基于 OpenAI ChatGPT-Image-2.0 设计的一套地标建筑提示词方法论,将长城、珠峰、外滩、珠江等知名地标浓缩成具有博物馆展陈感的档案级实体模型视觉图。其核心是「参数化分层控制」,将提示词拆解为基础设定、画面结构、细节要求、说明系统、构图镜头、材质光影六个独立可调的控制层。该方法内置主题类型路由机制,可覆盖自然地貌、城市空间、混合景观三类主题;并遵循三层色彩纪律(主色调 70-80%、辅助色 15-25%、点缀色 3-5%),强调低饱和、克制的档案感。核心视觉概念是「三维生长」——立体主体从二维地图底板中自然生长出来,而非简单叠加。该方法天然支持系列化生成,固定基础参数只换主题即可产出风格统一的地标图集。

参数化模板地标可视化视觉风格控制
09.08
Hermes Agent 记忆系统 README 配图
AI 智能体GitHub 项目

Hermes Agent 记忆系统

开源 AI Agent 框架 Hermes Agent 内置的多层记忆架构,以缓存优先和冷热分离为核心设计。

Hermes Agent 记忆系统是开源 AI Agent 框架 Hermes Agent(由 Nous Research 开发)内置的多层记忆架构,由四套协同工作的记忆子系统组成。第一层为固化提示词记忆,将高频关键信息存入 MEMORY.md 和 USER.md 文件,合计约 1,300 Token,会话期间固化不变。第二层为会话搜索回溯,历史对话存储在 SQLite 数据库中,通过 FTS5 全文搜索按需检索,并使用辅助模型进行摘要。第三层为技能系统,用于记住如何做事的程序记忆,技能文件存储在 ~/.hermes/skills/ 目录。第四层为可选的 Honcho 用户建模,用于跨会话、跨平台的深层用户画像。该系统的核心设计思想是缓存优先,保持系统提示词前缀稳定以最大化利用 Prompt Caching,同时采用冷热分离策略,只保存用户偏好、环境事实、错误修正、稳定规范和学到的技能五类高价值信息。

分层记忆缓存优化记忆系统
09.08