项目概览
LLM Wiki 是 Karpathy 于 2026 年 4 月提出的一种用 LLM 构建和维护个人知识库的方法论。其核心主张是不再把 LLM 当作临时问答工具,而是让它成为知识库的编译器和维护者,像程序员维护代码库一样,持续读取源材料、写入 Wiki 页面、更新交叉引用、标记矛盾。该方法论横跨个人知识管理、LLM 应用范式和知识编译三个领域,旨在解决传统 RAG 模式没有知识积累、无法发现矛盾、无法跨文档综合、查询结果无法沉淀以及人类维护负担过重等痛点。其核心思想是让 LLM 成为知识库的编译器和维护者,而非临时检索引擎。底层基于三层架构:Raw Sources(原始源材料)、The Wiki(知识库)和 The Schema(配置规范),并通过 Ingest(摄入)、Query(查询)、Lint(健康检查)三个核心操作实现知识的增量编译和持续维护。该方法论适合长期深度研究、个人知识管理等场景,但存在 Token 消耗高、冷启动成本高、幻觉风险等局限。
解决什么问题
传统 LLM 与文档的交互模式(如 RAG、NotebookLM、ChatGPT 文件上传)存在根本缺陷:没有知识积累。每次提问,LLM 都要重新从原始文档中检索和推导,知识没有被“编译”和“积累”。具体痛点包括:RAG 每次查询都是从零开始,无法发现阅读第 20 篇文章与第 3 篇的矛盾;RAG 的检索粒度是“文档片段”,无法跨文档综合;查询获得的好答案会随对话结束而消失;传统 Wiki 的维护成本随规模指数增长,人类无法承受。LLM Wiki 解决的就是这些问题,让知识“编译一次、持续更新、复利增长”。
工作方式
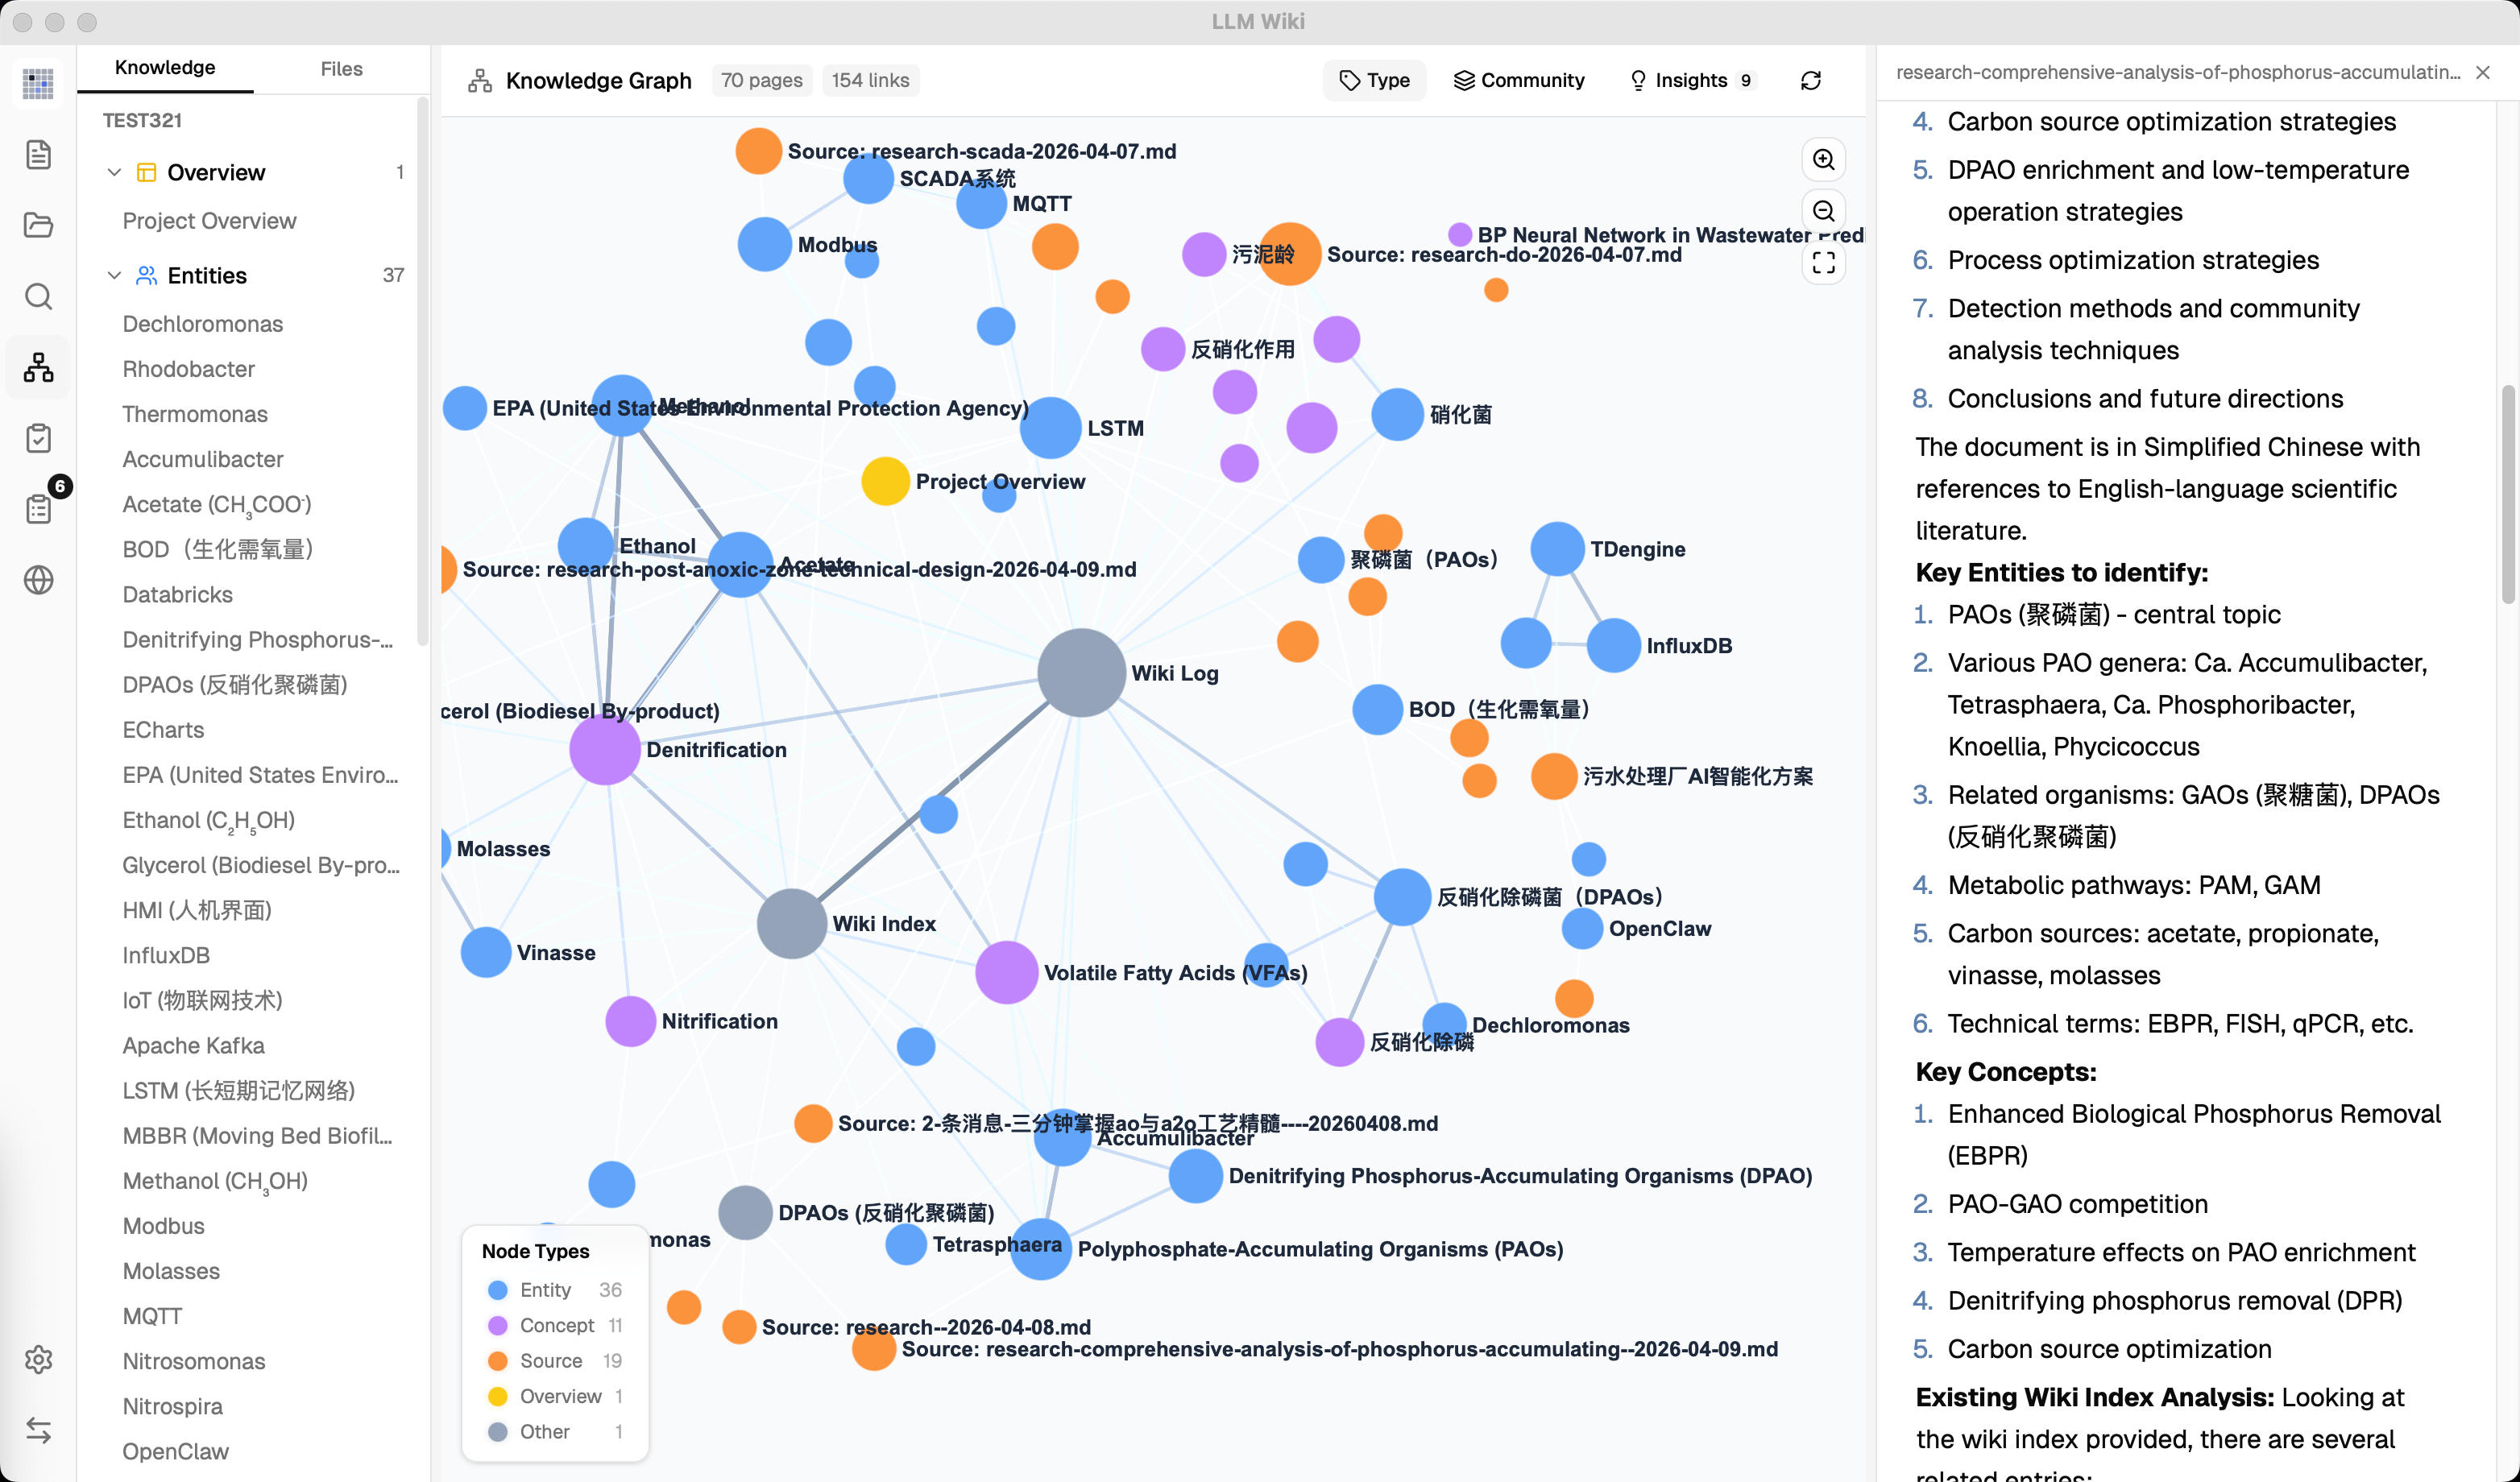
LLM Wiki 的底层工作基于三层分离的架构:第一层是 Raw Sources(原始源材料),即用户精心策划的源文档集合,不可变,作为事实的最终仲裁;第二层是 The Wiki(知识库),由 LLM 生成的 Markdown 文件目录,包括摘要页、实体页、概念页、对比页、总览等,是知识的编译产物;第三层是 The Schema(配置/规范),如 CLAUDE.md 或 AGENTS.md,告诉 LLM Wiki 的结构、约定和工作流。核心操作包括:Ingest(摄入)——LLM 读取新源材料,创建摘要页,更新相关实体页和概念页,更新 index.md 和 log.md;Query(查询)——LLM 通过 index.md 搜索相关页面,综合回答,有价值的回答可回写为 Wiki 新页面;Lint(健康检查)——定期检查页面间矛盾、过时声明、孤立页面、缺失交叉引用等。
核心能力
- 知识复利增长:每次摄入和查询都让 Wiki 更丰富
- 主动矛盾发现:摄入新信息时主动检查并标记矛盾
- 零维护成本(相对人类):LLM 不厌倦、不遗忘交叉引用
- 结果沉淀:有价值的查询结果回写到 Wiki,不随对话消失
- 极低技术门槛:中等规模下 index.md + LLM 即可,无需 RAG 基础设施
- 完全可定制:Schema 由用户和 LLM 共同演进
- Git 原生:Wiki 是 Markdown 文件的 Git 仓库,免费获得版本历史
使用前需要了解
- AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
- 适合场景:长期深度研究(数周/数月)、需要跨文档综合的复杂知识领域、个人知识管理(目标追踪、读书笔记、学习笔记)、团队/企业内部知识库、竞品分析、尽职调查、旅行规划。不适合场景:一次性问答(RAG 更高效)、需要实时数据的场景(如新闻摘要)、不愿意投入时间建立 Schema 的人、源材料极少(< 10 篇)的场景。局限包括:Token 消耗高,摄入一个源材料可能涉及 10-15 个页面的更新;冷启动成本高,需要时间建立初始 Schema 和协作习惯;存在幻觉风险,需要人类审核;知识衰减问题未解决,旧信息可能过时;图片处理不便;规模天花板约在中等规模(~100 源),更大规模需要额外基础设施;依赖特定 LLM 能力(如 Claude Code、Codex);实时性不足。