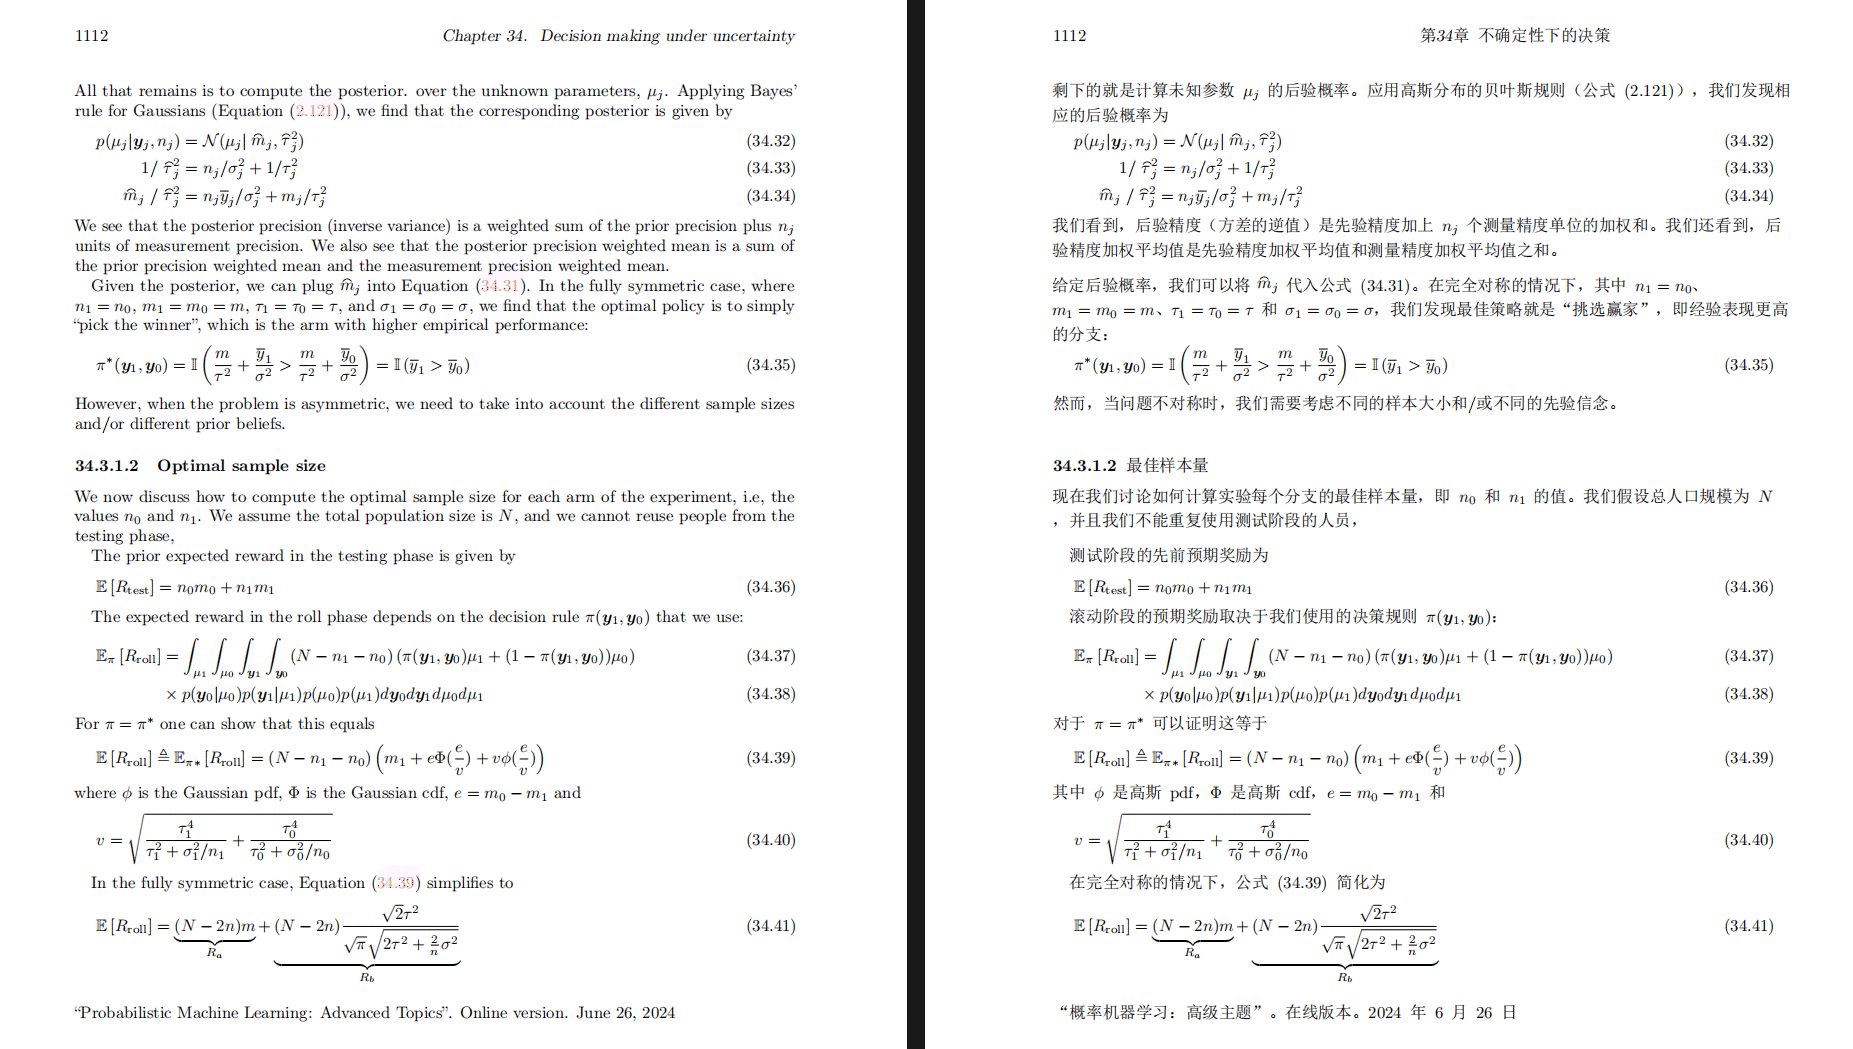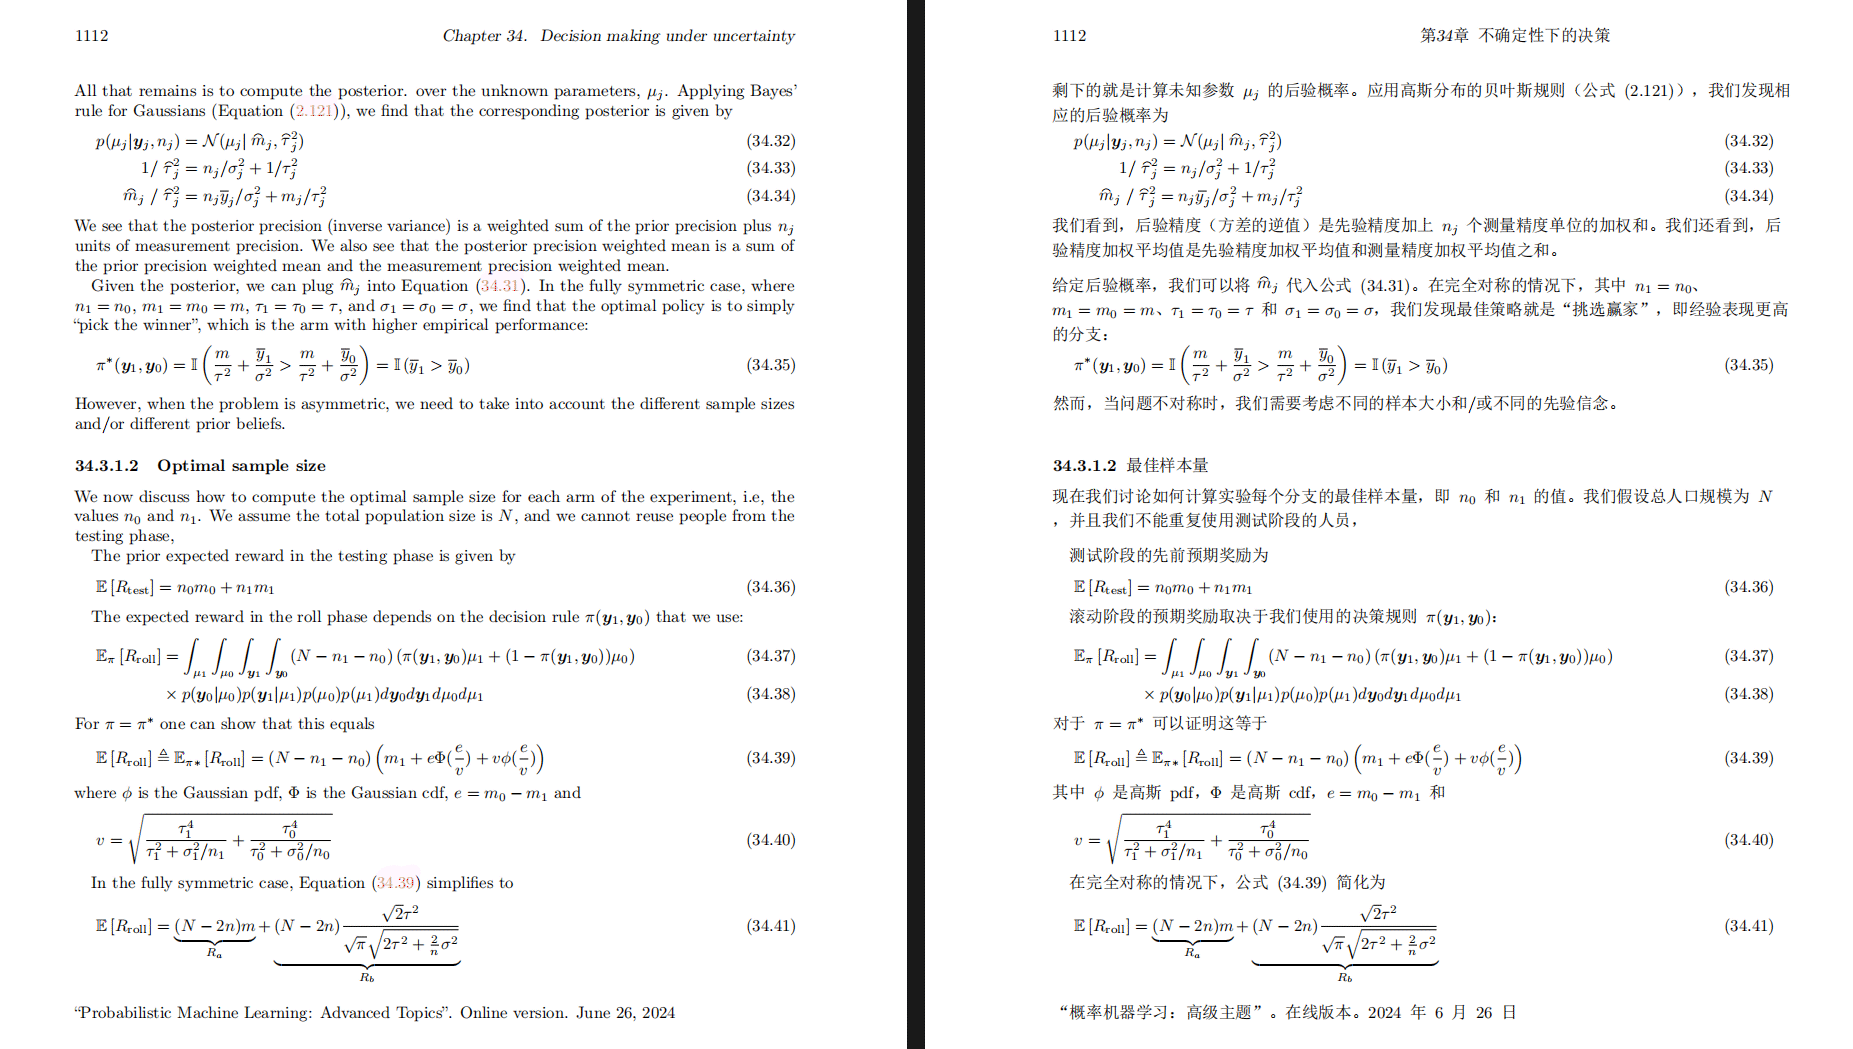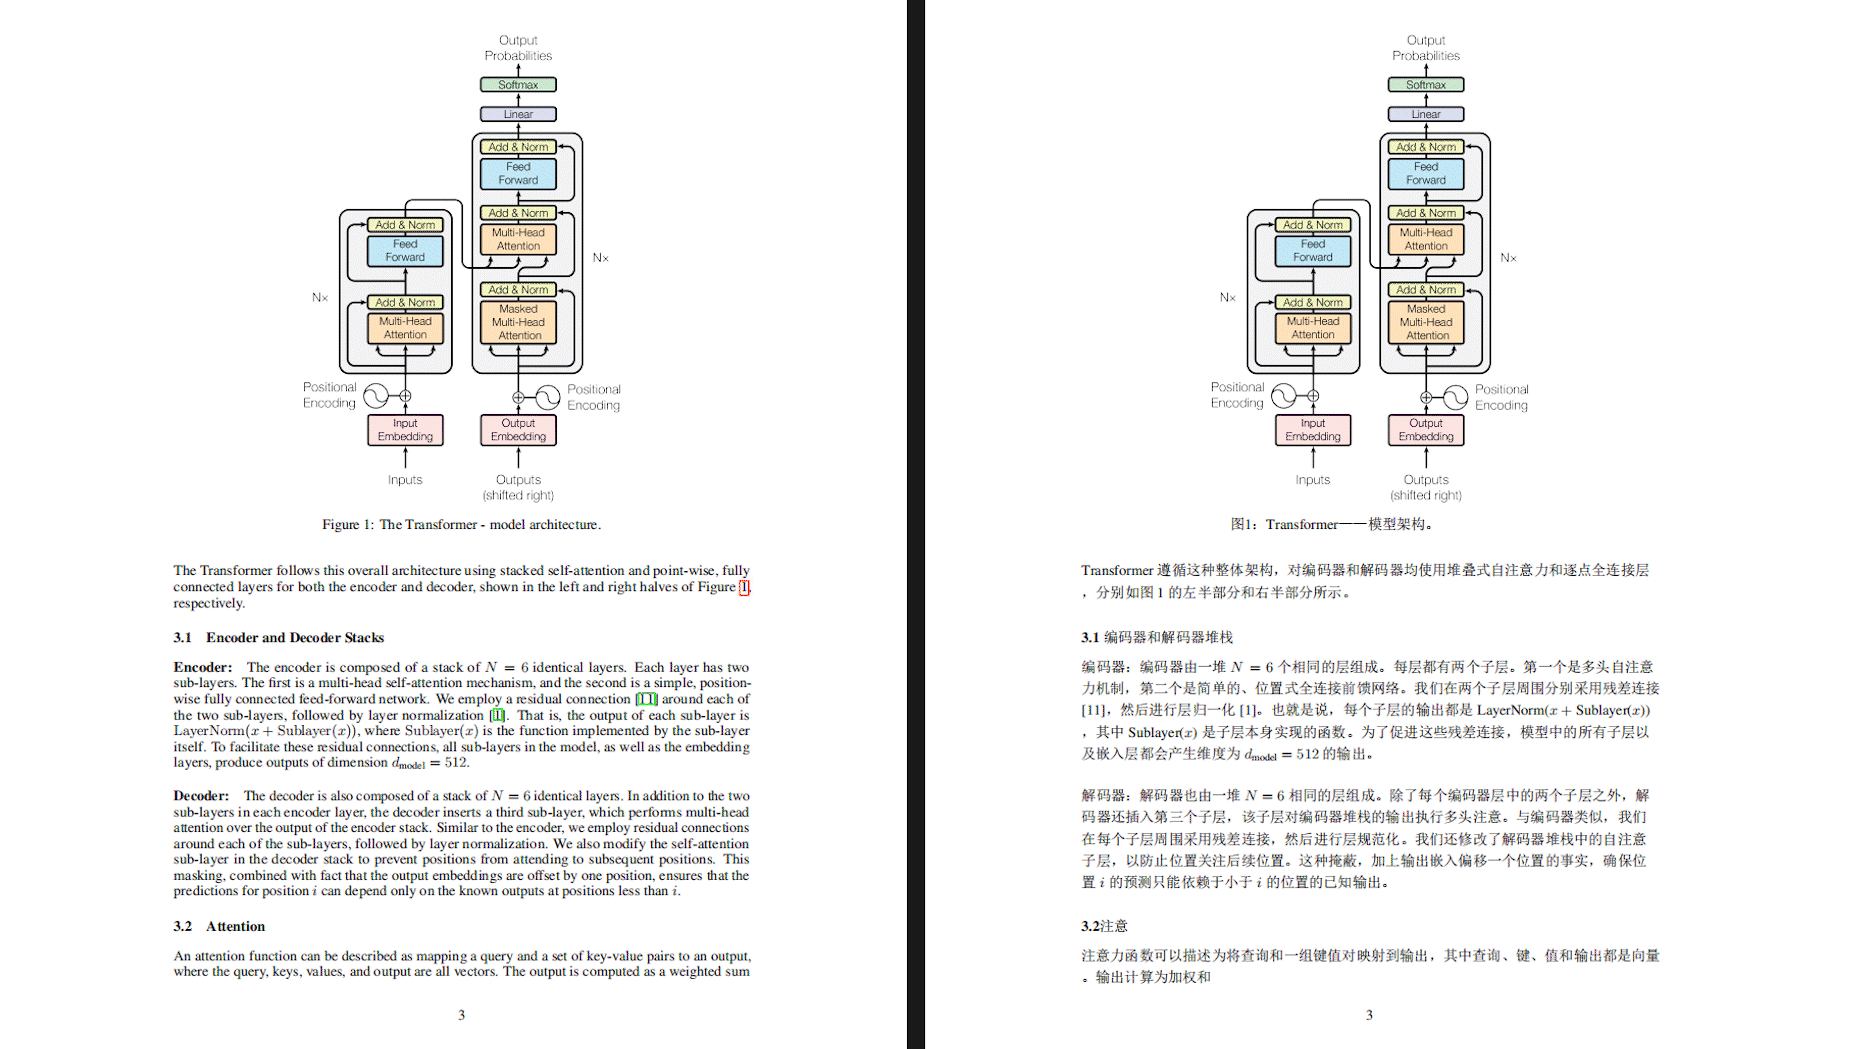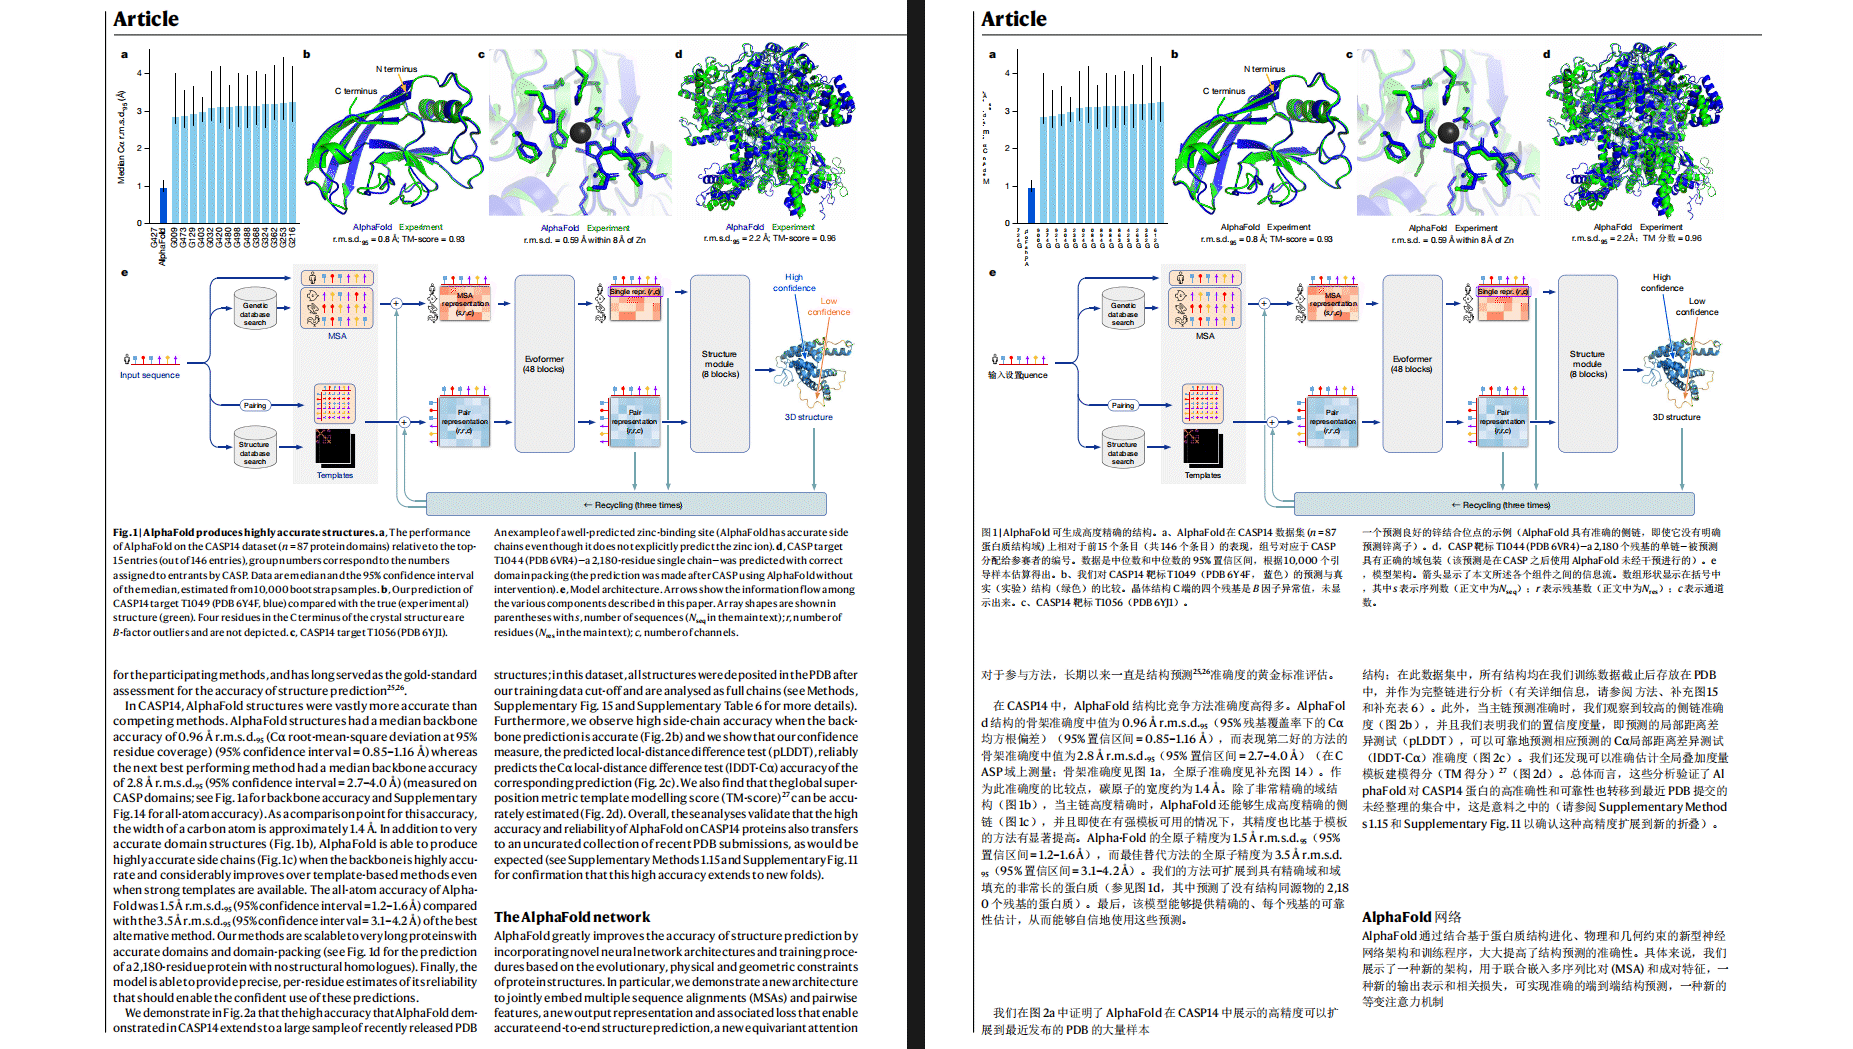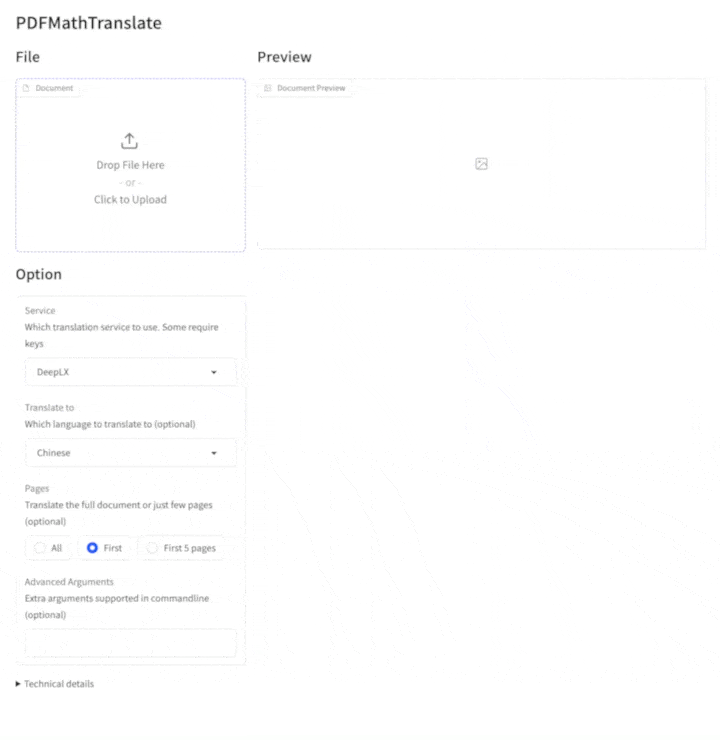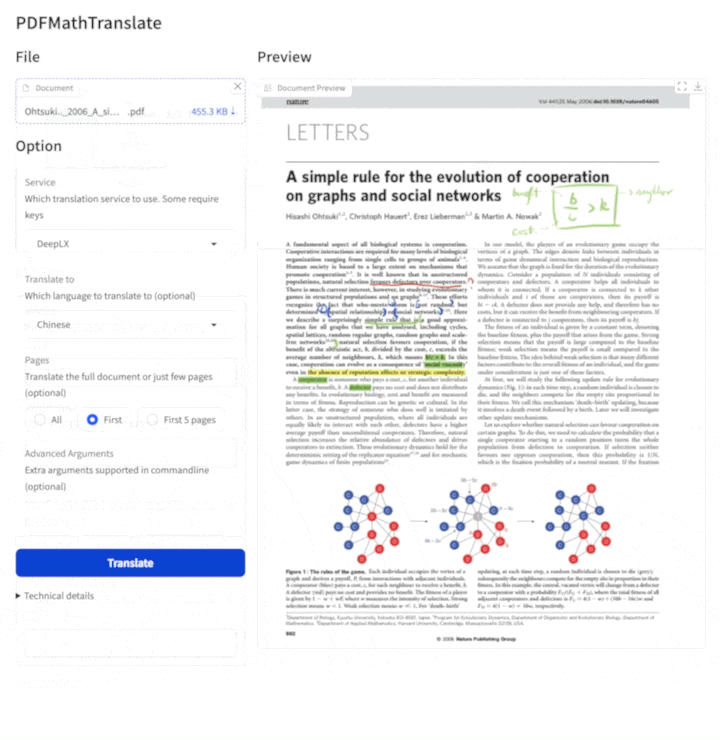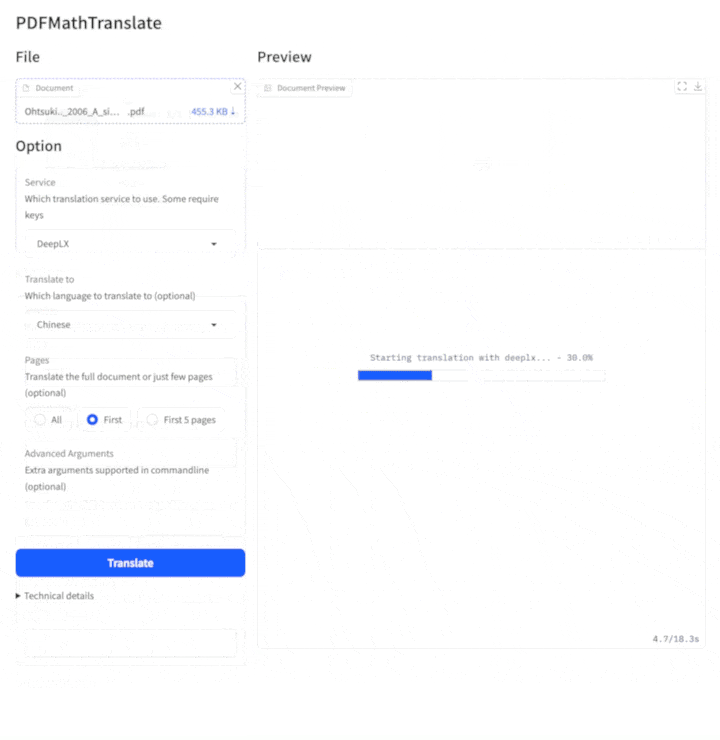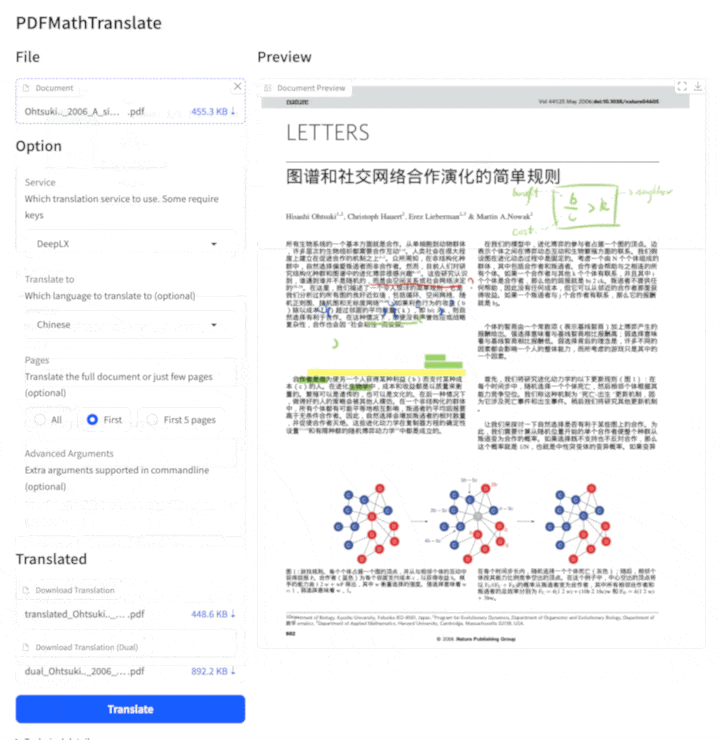
项目概览
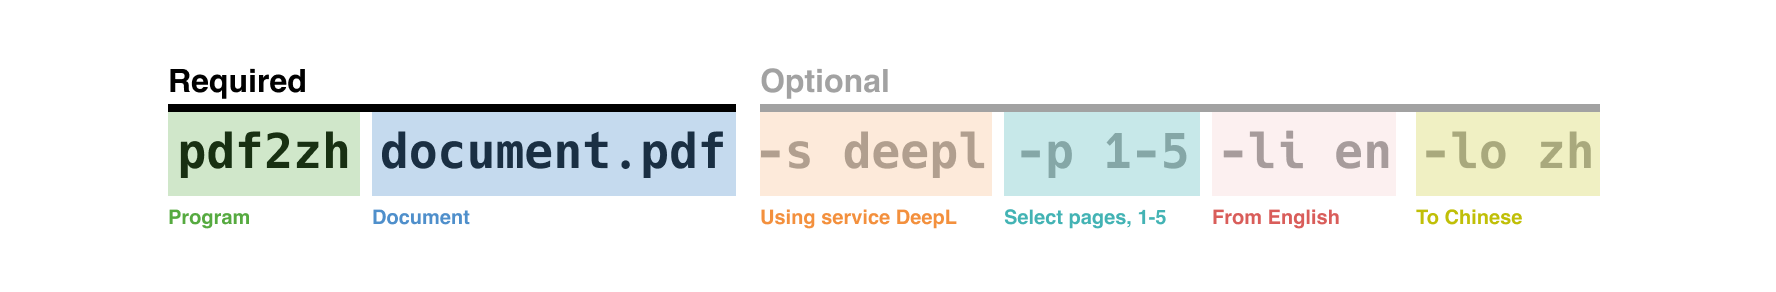
PDFMathTranslate(命令行工具名 pdf2zh)是一个开源的 PDF 科学文档翻译工具,其核心能力是在翻译 PDF 全文的同时,完整保留原始排版、数学公式、图表、目录和批注。它通过 PDF 解析、元素分类、文本翻译、原位回填四个阶段处理文档,使用 DocLayout-YOLO 模型识别并跳过公式区域,避免公式被翻译引擎误读。翻译引擎可插拔,支持 Google、DeepL、OpenAI、Ollama 等十余种后端,并支持 CLI、GUI、Docker、MCP Server、Zotero 插件等多种部署形态。工具同时生成纯译文版和双语对照版,满足不同阅读需求。项目以 AGPL-3.0 许可证开源,论文被 EMNLP 2025 录用。
解决什么问题
在 PDFMathTranslate 出现之前,翻译英文学术论文存在多种痛点。复制粘贴到翻译工具会导致公式变成乱码、图表丢失、参考文献格式混乱,一份 20 页的论文可能需要 2-3 小时。上传到在线翻译平台会破坏公式、将多栏排版压成单栏、表格错位、页码和目录失效。使用 OCR 工具先转文字再翻译,对数学公式的识别准确率很低,公式被文本化后不可逆地丢失了 LaTeX 结构信息。报告归纳了五大结构性痛点:公式破坏、排版丢失、图表错位、批量低效、隐私风险。PDF 本质是排版指令集而非结构化文档,解析难、分离难、重组难、字体难,这是问题难以解决的根本原因。
工作方式
PDFMathTranslate 的核心思想是不破坏 PDF 的内部结构,只替换其中的文本内容,让公式、图表、排版全部原地不动。处理管线分为四个阶段:第一阶段使用 PdfMiner.six 和 PyMuPDF 解析 PDF 结构,提取文本块的坐标、字体、字号信息;第二阶段使用 DocLayout-YOLO(ONNX 推理)对页面进行元素级分类,区分正文、标题、数学公式、图、表格、页眉页脚、脚注、目录;第三阶段通过多线程批量调用翻译 API,支持缓存机制和自定义提示词;第四阶段使用 PyMuPDF 在原始 PDF 中精确替换文本,嵌入目标语言字体并微调坐标。翻译能力完全外包给第三方 API,工具本身只负责解析、分发、回填的管线。
核心能力
- 公式保护:YOLO 检测并跳过公式区域,避免公式被翻译引擎误读
- 排版高度还原:原位替换策略,不重新生成 PDF
- 翻译引擎可插拔:支持 Google、DeepL、OpenAI、Ollama、Claude、Azure 等十余种后端
- 双模式输出:同时生成纯译文版(-mono.pdf)和双语对照版(-dual.pdf)
- 多形态部署:CLI、GUI(Gradio)、Docker、MCP Server、Zotero 插件、HTTP API
- 批量处理:支持目录级批量翻译和多线程并行
- 离线能力:通过 Ollama 本地模型实现完全离线翻译
- 渐进式处理:支持部分翻译、缓存复用
- 完全开源:AGPL-3.0 许可证
使用前需要了解
- AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
- 报告明确指出了该工具的局限性。扫描版 PDF 需要先 OCR 处理,工具本身的 OCR 能力有限。对手写数学公式的识别准确率较低。极复杂排版(多栏、浮动图、脚注、侧边栏)偶尔会出现错位。工具不改进翻译质量,翻译质量取决于所选 API。超过 100 页的 PDF 翻译时间较长。v2.0 实验版内核未经过大规模验证,官方建议稳定使用场景继续使用 v1.9.x。安装需要 Python 3.11-3.12 环境,对非技术用户不友好。首次使用需下载约 100MB 的 ONNX 模型。不建议用于需要出版级翻译质量的场景、以图片为主的 PDF 内容、对翻译速度有极高要求的实时场景。