跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签39提示词工程12开源8AI图像生成8内容创作5图像生成5Python5React5信息图4FFmpeg4GPT-Image 24TypeScript4多模态3

项目搜索结果

找到 39 个项目

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

HyperFrames 提示词工程 README Logoheygen-com/hyperframes
内容创作GitHub 项目

HyperFrames 提示词工程

用自然语言指挥 AI Agent 编写 HTML 视频的声明式合成框架

HyperFrames 是由 HeyGen 开源的一款 HTML-to-Video 渲染框架,核心理念是“Write HTML. Render video. Built for agents”。它让 AI Agent(如 Claude Code、Cursor、Codex)能够用纯 HTML + GSAP 动画来“编写”视频,再通过无头浏览器确定性渲染为 MP4/WebM 视频文件。框架不是视频编辑器,而是声明式视频合成框架,用户写 HTML,输出视频。其设计哲学是 Agent-First,通过三个 Slash Command(/hyperframes、/hyperframes-cli、/gsap)将框架知识注入 Agent 上下文,并通过自然语言词汇表(如“smooth”、“bouncy”、“dramatic”)直接映射到 GSAP easing 函数,实现意图到代码的精准映射。框架支持冷启动(从零描述)和暖启动(喂素材转化)两种 Prompt 形态,并强调小步精准修改的迭代原则。

开源视频合成提示词工程
09.08
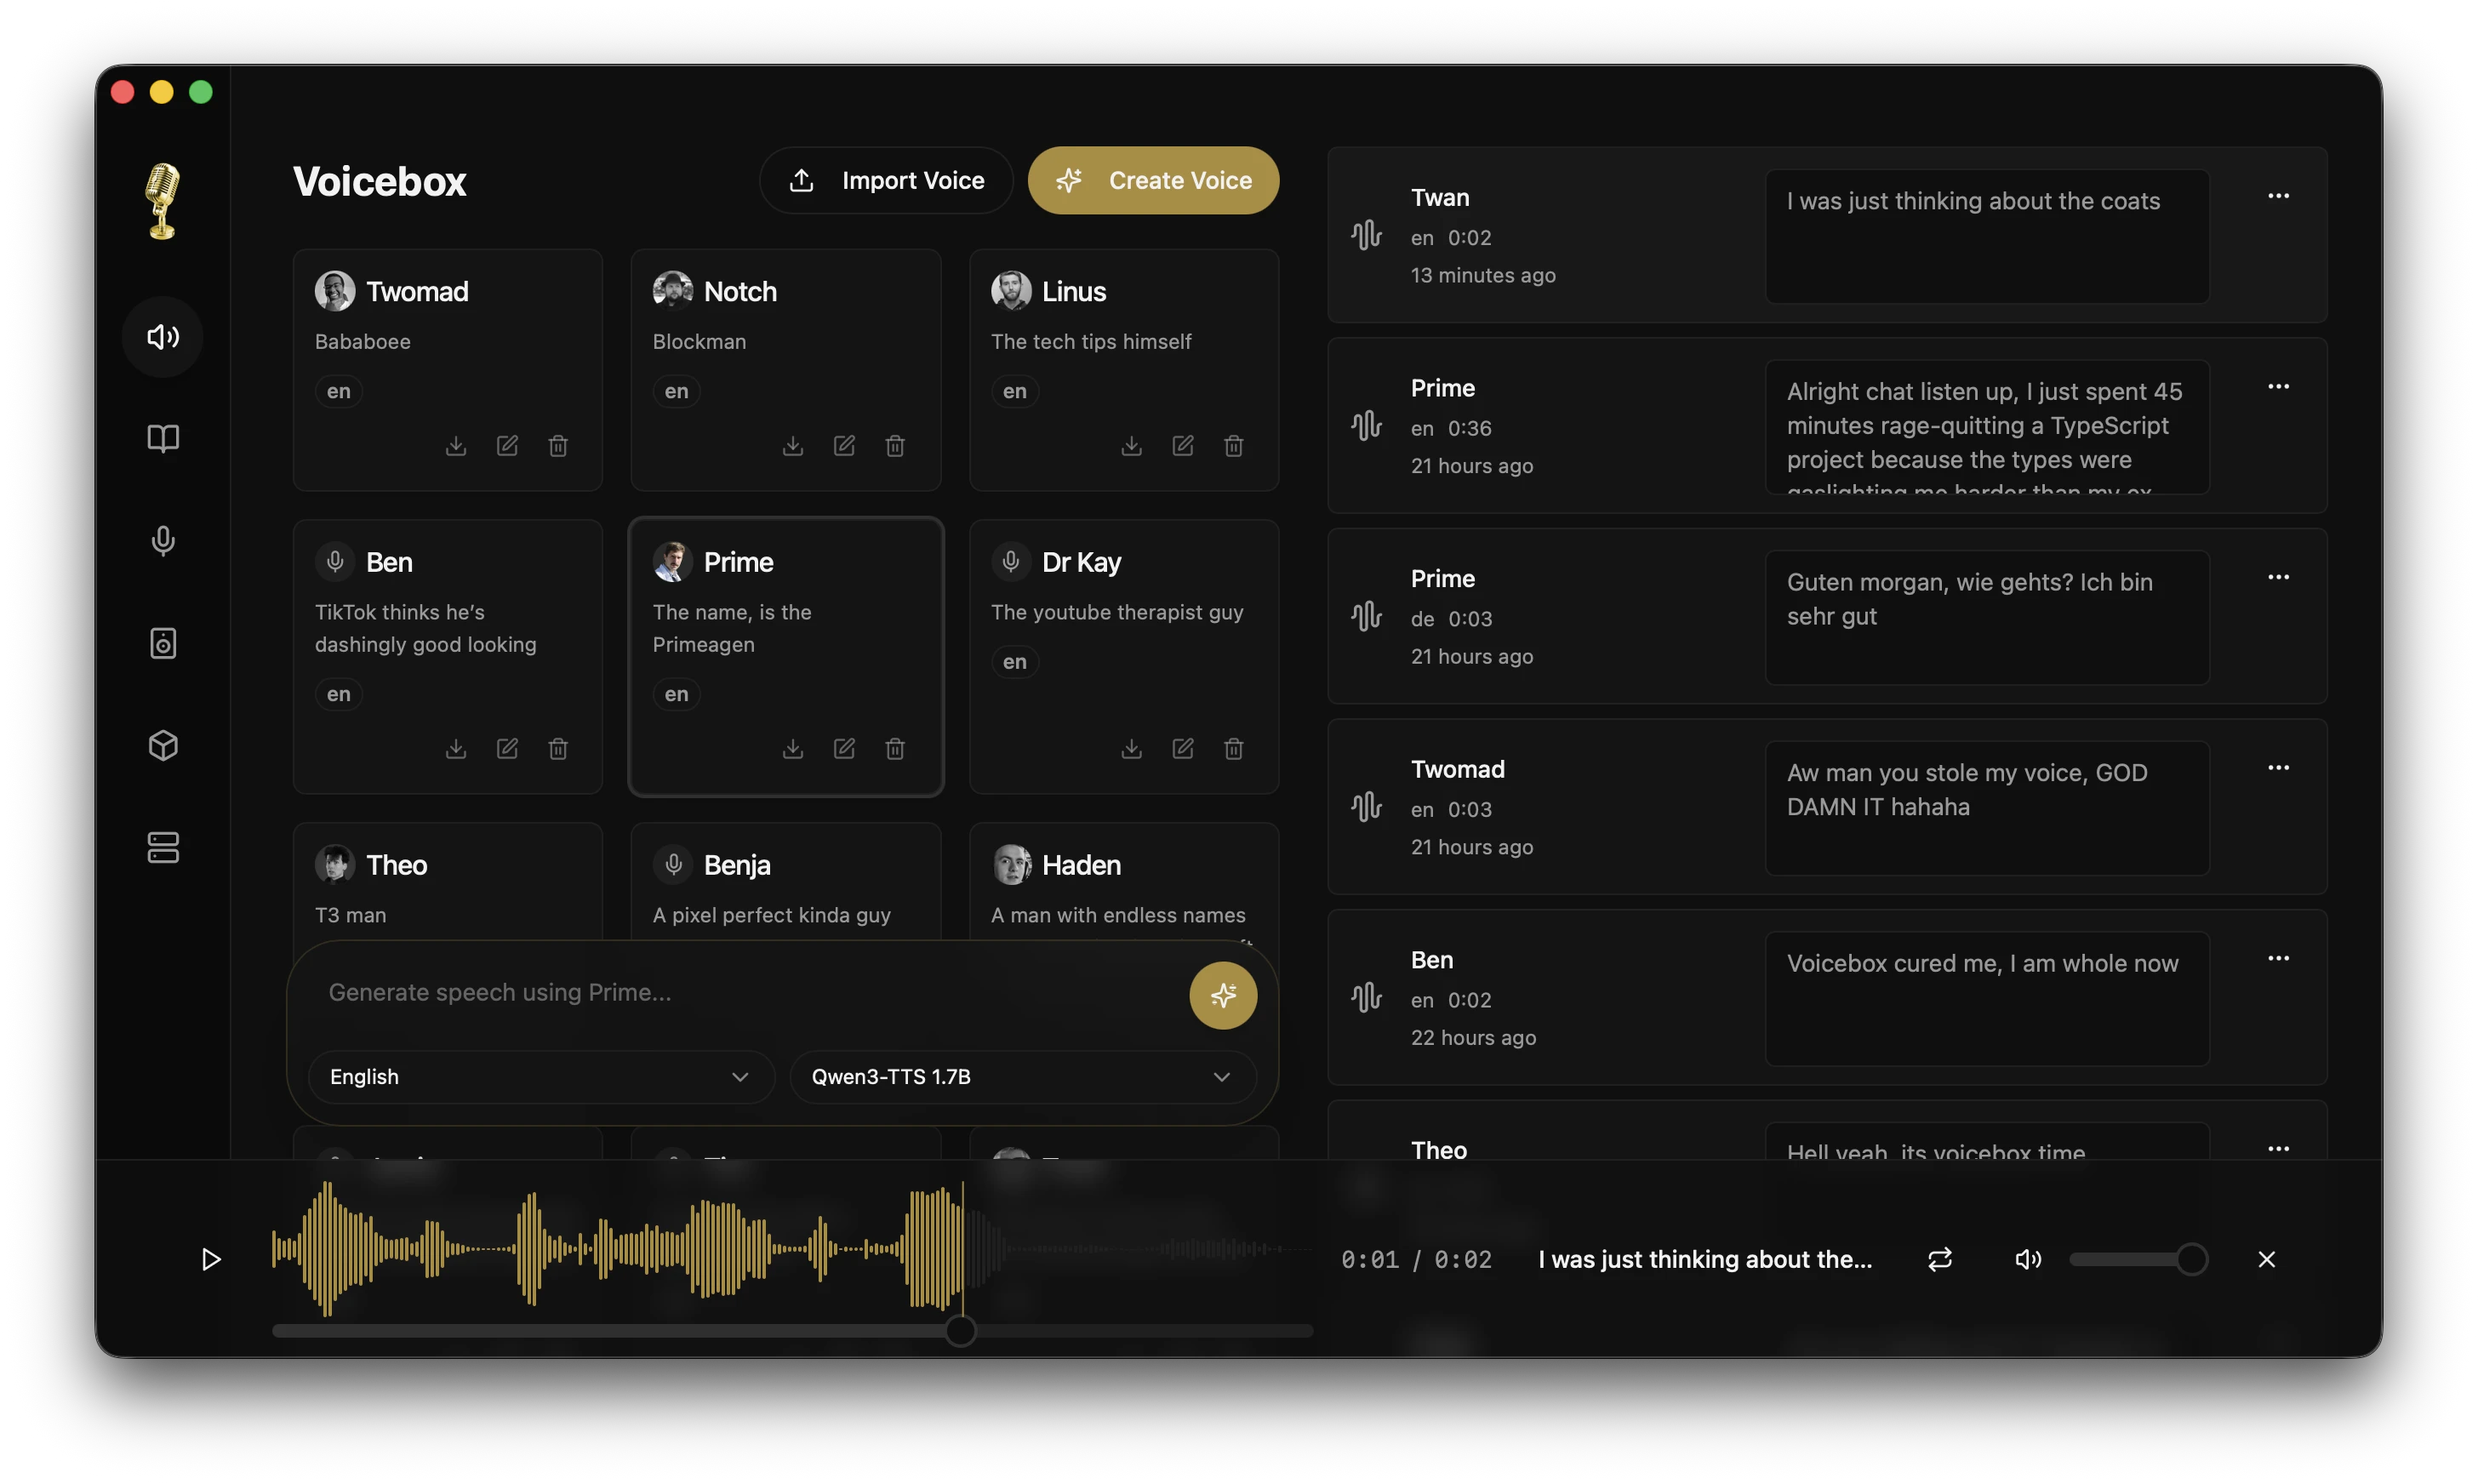
Voicebox README 配图
内容创作GitHub 项目

Voicebox

本地优先的开源语音合成工作站,集成多引擎声音克隆、情感标签、后处理音效与多轨编辑

Voicebox 是由 Jamie Pine 开发的开源语音合成工作室,定位为 ElevenLabs 的免费本地替代方案。它是一个完整的桌面应用,集声音克隆、语音生成、后处理特效、多轨编辑于一体,所有模型和数据完全在本地运行。项目采用 Tauri (Rust) 桌面框架,前端使用 React + TypeScript,后端为 Python (FastAPI),音效处理由 Spotify pedalboard 驱动。内置 5 个 TTS 引擎,支持 23 种语言,最大文本长度 50,000 字符,并提供完整 REST API 供外部集成。核心能力包括多引擎声音克隆、情感表达控制(如 [laugh]、[sigh] 等副语言学标签)、8 种后处理音效、多轨时间轴编辑(Stories Editor)以及长文本自动分段与交叉淡入淡出拼接。项目采用 MIT 协议完全开源,支持 CUDA、ROCm、MLX、DirectML、XPU 及 CPU 等多种 GPU 后端。

第 1 页第 2 页
本地优先声音克隆FastAPI
09.08
内容创作主题配图

GPT-Image 2 品牌包装系统提示词

一套通过约2000字模块化提示词,为任意品牌与品类生成品牌提案级包装系统展示图的方法论。

这是一套专为 ChatGPT Image 2.0 设计的品牌包装系统展示图提示词工程方法论,由 @MrLarus 实战验证。其核心是一套约 2000 字的中文提示词模板,用户只需替换【品牌名称】和【品牌类目】两个变量,即可生成包含手提袋、礼盒、单品盒、瓶罐容器、标签贴纸、产品本体等多种包装载体,且所有元素共享统一品牌视觉识别系统的展示海报。该方法论通过十层模块化控制架构,分别约束画幅、品牌系统完整性、品类适配、元素数量、视觉一致性、配色机制、构图、视觉风格、光影和最终效果。其核心设计思想包括系统感优先、受控发散配色、克制即高级、品类驱动、提案感优先和三段式构图。报告显示,该方法已在美妆、轻食、烘焙、茶饮四个不同品类品牌上生成高质量输出。该方法论适用于品牌提案、电商视觉升级、创业团队 MVP 视觉、设计灵感探索和设计教育等场景,但报告也明确指出其局限,包括品牌深度不足、Logo 真实性有限、输出为位图不可直接用于印刷、存在版权风险以及品类覆盖有限。

模板化品牌包装设计品牌视觉系统
09.08
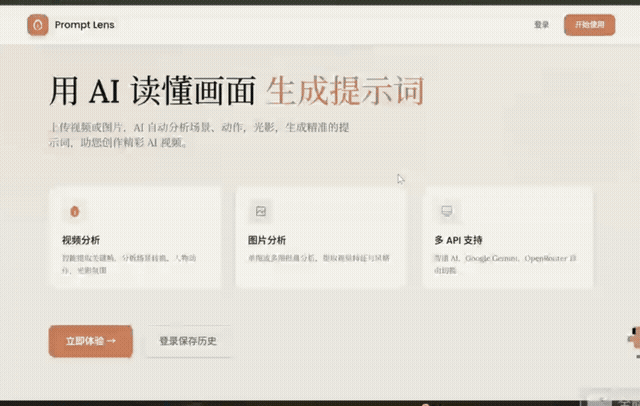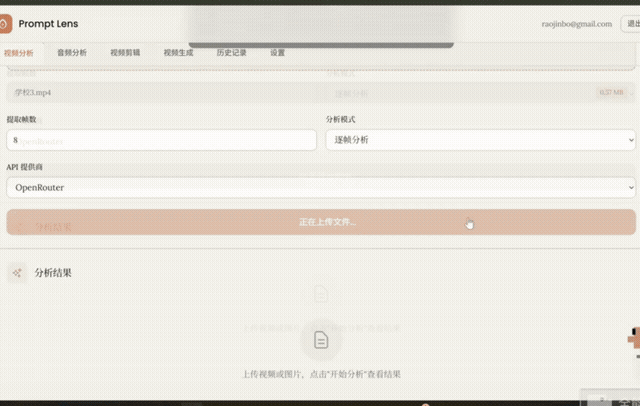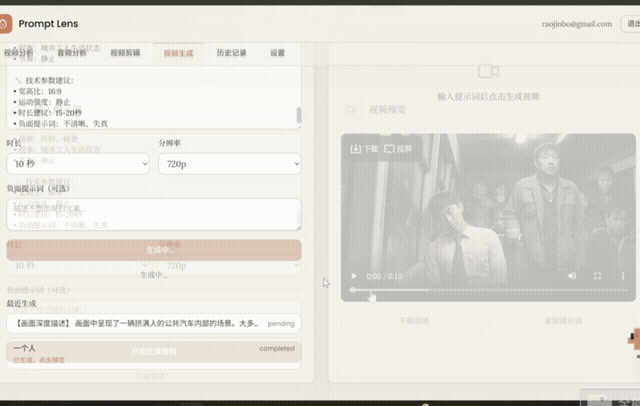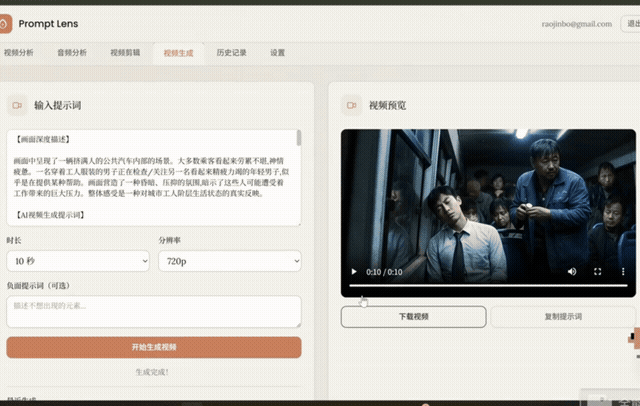
PromptLens README 配图
内容创作GitHub 项目

PromptLens

开源 AI 视频提示词反推分析工具,自动提取关键帧并生成结构化提示词

PromptLens 是一款开源的 AI 视频提示词反推分析工具,提供完整的 Web 应用体验。其核心能力是上传 AI 生成的视频或图片,自动提取关键帧,通过多模态大模型(如智谱 GLM-4V、Google Gemini、OpenRouter)分析画面内容,反向推导出可能使用的提示词,并输出结构化的、可直接复用的英文提示词。项目采用 Next.js 15 + React 19 全栈技术,使用 Supabase PostgreSQL 存储数据,Cloudflare R2 存储媒体文件,FFmpeg 进行视频帧提取,支持 better-auth 的 Google/GitHub 登录。除画面分析外,还支持通过 AssemblyAI 进行音频识别,提取视频中的语音旁白和台词。项目以 MIT 许可证开源,代码透明,可自由修改和商用。

多模态大模型开源提示词反推
09.08
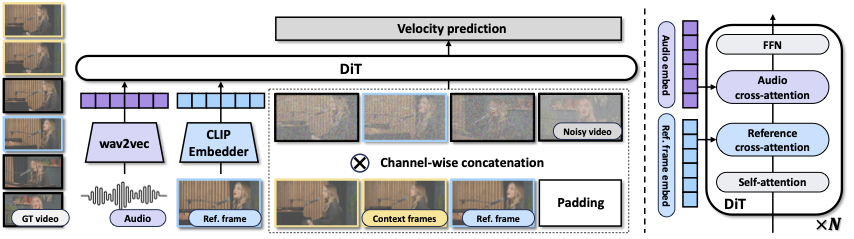
InfiniteTalk README 配图
内容创作GitHub 项目

InfiniteTalk

音频驱动的无限长说话视频生成框架

InfiniteTalk 是美团 MeiGen-AI 团队于 2025 年 8 月开源的音频驱动无限长说话视频生成框架,全称 "Audio-driven Video Generation for Sparse-Frame Video Dubbing"。它提出了一种新型视频配音范式——"稀疏帧视频配音",通过保留原始视频的关键参考帧,在维持身份信息、标志性手势和摄像机轨迹的同时,对全身运动进行音频同步的编辑。给定一段源视频和目标音频,可生成与音频精确口型同步、头部/身体/表情联动的全新视频;给定一张人物图片和音频,可从零生成无限长的说话人视频。支持 480P 和 720P 分辨率,默认最大 1000 帧/40 秒,可流式扩展。底层基于扩散模型构建,使用 Wan2.1-I2V-14B 作为视频生成基座,音频编码器采用 Wav2Vec2。项目以 Apache-2.0 许可证开源。

扩散模型流式生成视频配音
09.08
内容创作主题配图

GPT-image2 社区提示词合集

社区实战验证的 GPT-image2 提示词速查手册

本合集基于社区创作者在 X 平台发布的「GPT-image2 最强玩法合集」,系统整理了 15 类经过社区实测的提示词场景,涵盖日历设计、代码海报、Logo 生成、书法复制、试卷生成、架构图绘制、UI 仿真、直播切片、MV 制作等。报告指出,GPT-image2 的核心突破在于原生文字渲染(中英日韩)和 UI 截图级逼真度,用户只需一句话中文提示词即可出图,无需学习复杂参数。合集还介绍了 URL 输入、多轮对话迭代、跨工具联动(如与 Seedance2 配合生成视频)等能力。报告同时说明,该文档是《GPT-image2 深度技术指南》的实战补充篇,侧重社区玩法而非模型原理与 API 工程。

内容管线提示词图像生成
09.08
开发工具主题配图

Mintlify

AI 原生的现代化文档平台,以 Docs-as-Code 理念简化文档创建与维护

Mintlify 是一个现代化的 AI 原生文档平台,帮助工程团队创建、管理和发布美观的文档站点。它采用 Docs-as-Code(文档即代码)理念,用 MDX(Markdown + JSX)编写内容,通过 Git 管理版本,自动构建部署。平台提供内容创作、结构组织、API 文档、AI 原生、部署托管和优化分析等核心能力。它解决了传统文档方案搭建成本高、API 文档难做、内容维护难、缺乏 AI 能力、发现性差等痛点。Mintlify 的流程是连接 GitHub、写 MDX、自动部署、AI 辅助维护,周期短且后续几乎零运维。其设计原则包括 Docs-as-Code、约定优于配置、AI 原生、托管平台和 MDX 超级 Markdown。平台支持 OpenAPI 3.0/3.1 自动生成 API 文档和交互式 Playground,内置 AI Assistant 问答和 AI Agent 自动维护,并提供 MCP Server 集成。

文档平台自动部署AI 原生
09.08
内容创作主题配图

AI短视频全流程自动化工具链

从创意到发布的全流程自动化短视频生产工具链

AI短视频全流程自动化工具链是一组开源项目按“生成→剪辑→翻译→发布”顺序串联形成的工作流体系,利用大语言模型、语音识别、语音合成、机器翻译和浏览器自动化等技术,将短视频内容创作的全生命周期从“人工逐环节操作”升级为“一键自动化流水线”。工具链由四个核心项目组成:MoneyPrinterTurbo负责视频生成,FunClip负责智能视频剪辑,KrillinAI负责视频翻译配音,social-auto-upload负责多平台一键发布。它属于“AI辅助内容创作”技术体系,核心价值是把一个短视频从“创意到上线”的全流程压缩到分钟级别,并且一个人就能完成传统需要文案、剪辑师、翻译、运营四个人协作的工作。传统短视频制作周期通常需要1-3天,该工具链可大幅缩短制作时间。

短视频浏览器自动化自动化
09.08
内容创作主题配图

GPT IMAGE2 角色设计卡 Prompt 工程

从单张角色图自动生成官方设定级角色设计卡的 Prompt 工程方法

本收藏聚焦于 GPT IMAGE2(gpt-image-1.5)在角色设计卡(Character Sheet)场景下的 Prompt 工程方法论。核心能力是从单张角色图片自动生成包含三视图、表情变化、装备分解、色板和世界观设定的专业级角色设定图。传统制作需资深设计师 1-3 个工作日,而该方法可在约 10 秒内完成,成本约 $0.05-0.10/张。其原理基于 VQ Token 与 Text Token 的统一空间,使模型能同时理解图像与文字指令,保持多视图一致性并自动推理世界观。标准 Prompt 包含锚定指令、质量锚词、结构要求和风格约束。实际使用通常需要 1-3 轮迭代优化,中/日/英三种语言 Prompt 均有效。该方法适用于游戏角色概念设计、漫画设定集、VTuber 形象、TRPG 角色卡及 IP 授权资料等场景,但存在细节可能出错、文字渲染有限、风格依赖原图等局限。

多视图生成角色设计色板提取
09.08
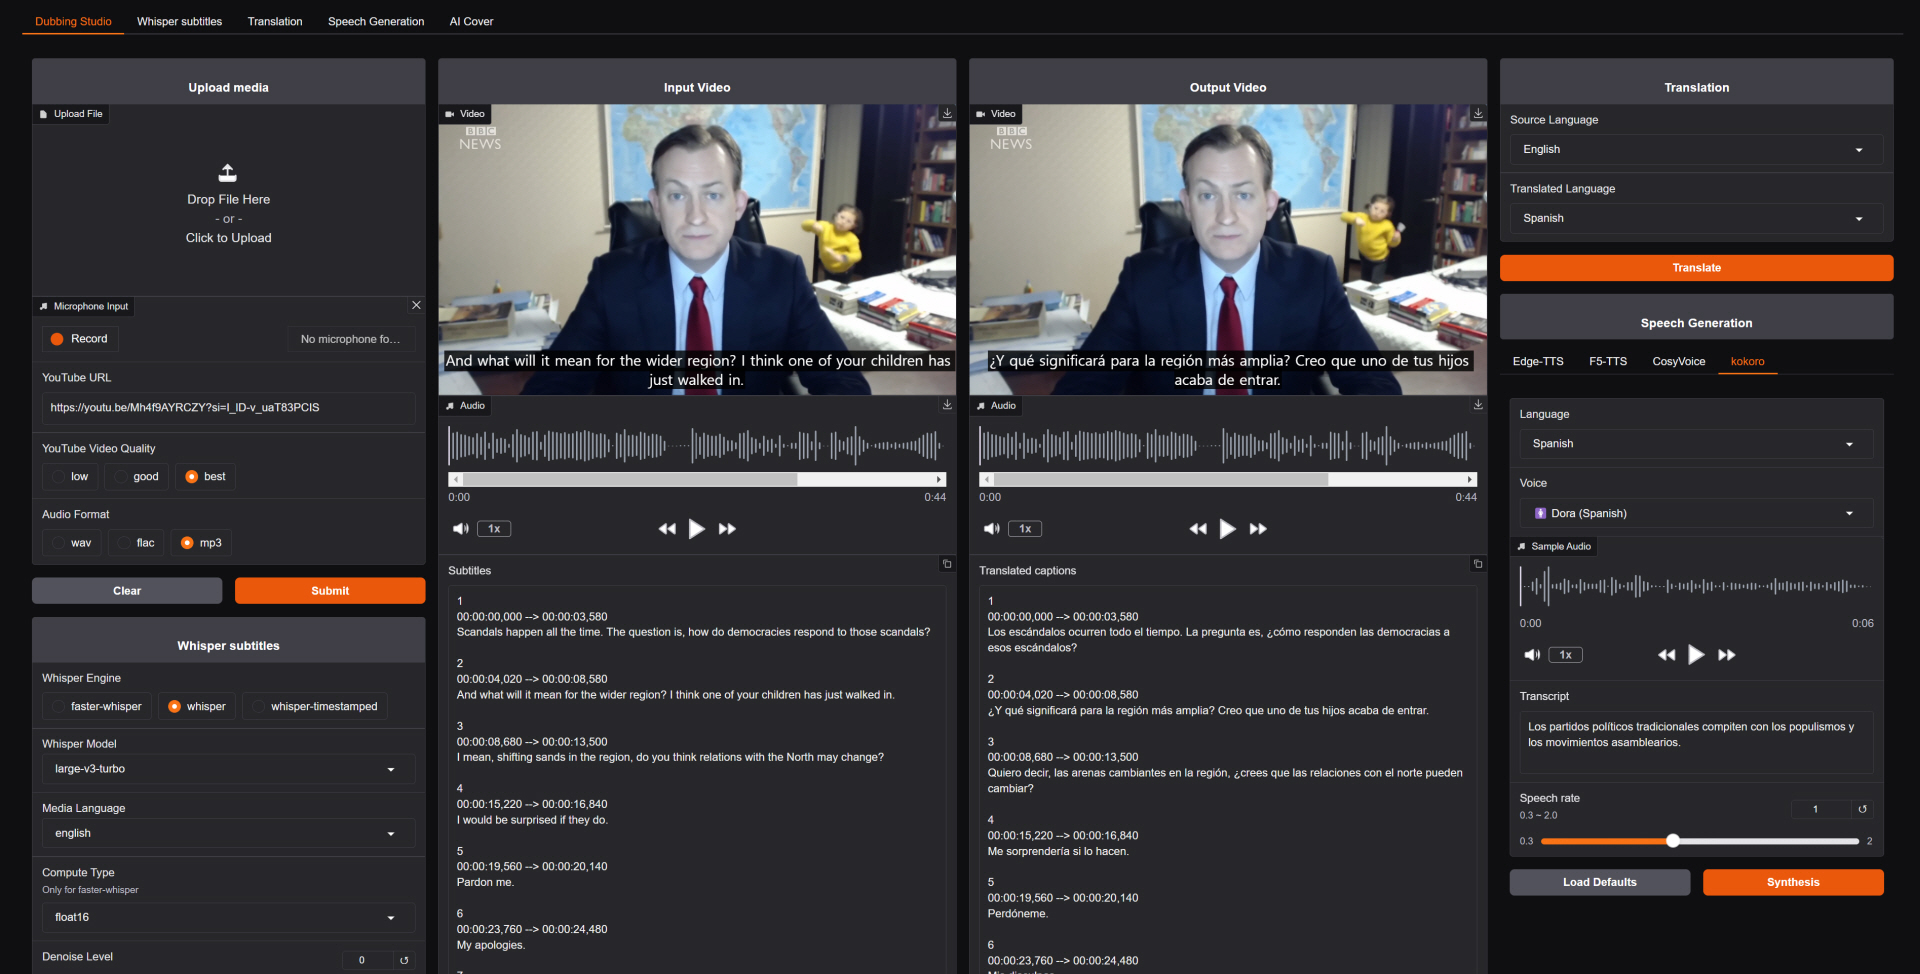
Voice-Pro README 配图
内容创作GitHub 项目

Voice-Pro

一站式 AI 语音工作台,从视频下载到多语言配音全流程自动化

Voice-Pro 是一款面向创作者和开发者的 AI 音频全流程处理工具,由韩国创业公司 ABUS 开发,基于 Gradio WebUI 构建。它将视频下载、音频分离、语音识别、多语言翻译、文本转语音(TTS)和零样本声音克隆集成到一个统一的 Web 界面中,定位为 ElevenLabs 的开源替代方案。核心价值在于将传统需要 5-8 个工具配合的流程(下载、分离、识别、翻译、配音、字幕)串联成一条自动化管道,用户只需输入视频链接,即可获得多语言配音视频和字幕。工具支持四种 Whisper 变体用于语音识别,三种零样本声音克隆引擎(F5-TTS、E2-TTS、CosyVoice),以及 Edge-TTS、kokoro 等多语言 TTS。完全开源免费,本地运行,数据不出机器。需要 NVIDIA GPU(最低 4GB 显存,推荐 8GB+),首次部署需下载模型,耗时较长。

开源声音克隆视频配音
09.08
内容创作主题配图

AI形象照接单级模板提示词

一套分层锁定的AI生图提示词架构,将专业摄影参数硬性锁定,仅开放客户定制区,实现标准化接单交付。

AI形象照接单级模板提示词是一套结构化的AI生图提示词工程方法论,旨在将Midjourney、Flux、GPT Image等AI图像生成工具的输出质量从“塑料感”提升到商业影楼级写真水准,并实现标准化接单交付。其本质是分层锁死的提示词架构:将摄影参数(镜头、光位、胶片质感)硬性锁定,仅暴露客户定制区(动作、穿搭、修饰)作为可变变量。用户只需复制模板、填入客户需求、让LLM生成最终提示词,并配合客户原始照片垫图出图。该方法论解决了传统AI生图的六大痛点,包括“塑料微商味”、非标交付、摄影知识门槛、客户需求翻译困难、效率低下和AI发散不可控。核心思想是“锁定底层参数,只动客户变量”,通过三层分离架构(客户定制层、项目设定层、摄影锁定层)实现。报告还提供了五套风格模板(影楼级黑白写真、王家卫复古港风、法式冷金油画感、美漫赛博硬核风、时装型录Lookbook),以及标准接单出图流程、工具环境、常见问题排查和优缺点分析。

接单变现模板化商业摄影
09.08
内容创作主题配图

GPT-Image科学百科图解提示词

一套通过结构化提示词让AI自动生成百科级科学信息图的方法论

这是一套专为GPT-Image等多模态图像生成模型设计的高密度信息图提示词工程体系,通过结构化的视觉布局指令,让AI自动生成类似DK百科全书风格的专业科学图解。它并非软件或工具,而是一套提示词工程方法论,核心成果物是“单图即百科”的信息图:中央主体以逼真3D效果“跃出画面”,周围环绕6-8个知识模块,通过引导线、箭头、标注形成完整的知识网络。该体系解决了传统AI图像生成在知识密集型场景下的信息密度不足、布局不可控、文字渲染差、学科覆盖窄、专业度低等问题。其核心思想包括“太阳系布局”、战略性留白、引导线编织知识网络、中文书法体与手写注释的双层文字系统、三大领域模板化以及3:4竖版画幅与复古纸张质感。提示词结构拆解为7个控制层:角色定义、任务描述、领域选择、风格定义、视觉要求、模块结构、主题注入。用户只需修改主题名即可生成不同物种或人物的信息图。报告还提供了标准使用流程、批量生产流程、与竞品的对比、真实应用场景、工程落地步骤、优缺点与局限、常见误区及学习路径。

多模态AI科学教育内容创作
09.08
内容创作主题配图

GPT-Image 2 博物标本解剖风格提示词

用博物学视角与卡拉瓦乔光影,把食物变成博物馆级解剖标本的提示词技术

本项目是一套面向 GPT-Image 2 的提示词技术,由知识猫图解(@GeekCatX)创作,核心思路是以博物学大师发现野外标本的方式解剖食物,将剖开、展开、固定的处理步骤与博物馆珍贵藏品的展示框架结合,并以卡拉瓦乔为《国家地理》掌镜时的戏剧性明暗对比作为光影方向。提示词强调每个内部结构以自身材质真相发光,通过“截面锋利得近乎暴力、内部美丽得近乎神圣”的对立制造视觉张力。报告指出,该提示词约 80 字,适用于水果、坚果、蔬菜等内部结构丰富的对象,也可扩展至矿物、植物等非食物对象;其传播力在社交媒体上得到验证(原帖 274 转发、244 评论)。报告同时说明其局限:风格偏暗调侧光、仅适合可解剖展示的对象、大量使用可能引发审美疲劳,且部分食物或处理方式可能触发内容审核。

博物学卡拉瓦乔光影内容创作
09.08
内容创作主题配图

GPT-Image 2 技术蓝图信息图提示词

在真实产品照片上叠加工业级技术蓝图标注,一句话生成设计手册风格信息图

该收藏记录了一种利用 GPT-Image 2 模型生成产品技术解剖图的提示词技术,由 Bitturing 分享。其核心是在真实产品照片上叠加技术蓝图风格的标注层,包括白线、箭头、尺寸、标签以及零件、材料、尺寸和功能的小型示意图,并配有左上角写有"OBJECT"的草图框和 1:1 维度标注,呈现出类似工业设计手册的专业感。该技术旨在解决传统产品技术展示中摄影与设计分离、专业门槛高、效率低下和风格一致性难保证等问题。报告指出,该技术适用于电子产品、机械产品、运动装备、汽车等对象,其中内部结构复杂的产品效果最好。报告同时提醒,AI 生成的尺寸标注可能不准确,仅供参考,正式使用需人工核实。

技术蓝图内容创作提示词
09.08
ArcReel README 配图
内容创作GitHub 项目

ArcReel

AI Agent 驱动的开源小说视频生成工作台

ArcReel 是一个开源的 AI 视频生成工作台,由 AI Agent 全程驱动,能够将小说文本自动转化为完整的短视频。其完整工作流为:小说 → 角色/场景/道具设计 → 剧本 → 分镜图 → 视频片段 → 最终成片。它本身不训练模型,而是通过统一的抽象层集成 Google Gemini、火山方舟、xAI Grok、OpenAI 等多个 AI 供应商,用 Agent 智能体协调完成从文本到视频的端到端生产流程。项目采用 React 19、Python 3.12+ / FastAPI、Claude Agent SDK 等技术栈,支持 SQLite 与 PostgreSQL 数据库,可通过 Docker 一键部署。ArcReel 旨在解决 AI 视频生成中角色一致性、场景连贯性、分镜拆分、多供应商调度与任务编排等工程问题,将传统人工串联多个 AI 工具的制作流程,转变为 Agent 自动编排与人工确认相结合的标准化流水线。

多模态生成Agent编排AI视频生成
09.08
内容创作主题配图

OpenNana 提示词图库

中文原生的 AI 图像提示词视觉化图库,收录 104+ 条精选案例覆盖多种主流模型

OpenNana 是一个 AI 图片提示词分享平台,核心产品是提示词图库,目前已收录 104+ 条精选提示词案例,覆盖 Nano Banana Pro、GPT Image-2(ChatGPT)、Grok、Seedance 2.0 等主流 AI 图像/视频生成模型。平台定位为 AI 图像创作者的灵感库和提示词参考站,提供浏览、搜索、收藏高质量提示词的功能。核心能力包括多模型覆盖、分类筛选(按模型、媒体类型、标签)、视觉化展示(每条提示词配有生成效果图)以及一站式体验(提供 AI 生图、AI 生视频、生成记录等工具)。平台采用三维分类体系:模型、媒体类型、标签,便于用户快速定位目标提示词。设计原则包括视觉优先、多模型平等、标签化组织、创作者溯源、平台一体化和持续更新。平台还内置 AI 生图工具,用户可一键生成图片。

视觉化展示提示词图库中文原生
09.08
内容创作主题配图

GPT-Image 2 实操案例与提示词工程指南

一份基于实操案例整理的 GPT-Image 2 提示词工程指南,覆盖 13 类应用场景与模板化用法。

本指南基于一份实操报告整理,围绕 OpenAI 于 2026 年 4 月推出的图像生成模型 GPT-Image 2 展开。报告指出,该模型并非传统文生图工具,而是集成了意图理解、知识补全、设计规划与精准渲染的 Agent 系统。指南重点介绍了其四大核心亮点:高质量中文渲染、自动补全缺失信息、支持极简提示词以及可对话式追问微调。内容主体为 13 个实操案例,覆盖图鉴拆解、古文书法、科普百科、电商详情、试卷生成、旅游攻略、人物关系图、密集中文排版等场景,每个案例均提供了对应的提示词模板与通用性说明。此外,指南还对比了 GPT-Image 2 与 Midjourney、DALL-E 3、Stable Diffusion 等工具的差异,并总结了优缺点、常见误区与学习路径。报告同时指出其局限,如不适合像素级精确排版、无法本地部署或批量调用,以及存在伦理风险。

提示词工程图像生成信息图
09.08
CosyVoice README 配图
内容创作GitHub 项目

CosyVoice

多语种语音生成模型,支持3秒声音克隆与流式合成

CosyVoice 是阿里巴巴达摩院 FunAudioLLM 团队开发的多语种大语音生成模型,提供推理、训练和部署的全栈能力。其核心能力包括仅需 3 秒参考音频即可实现零样本声音克隆,覆盖 9 种常见语言和 18 种以上中文方言,并支持跨语种克隆。模型采用 LLM 生成语义 Token 与 Flow Matching 渲染声波的双阶段架构,CosyVoice 2.0 起支持双向流式合成,延迟低至 150ms。CosyVoice 3.0 引入多任务 Tokenizer 和可微分奖励模型后训练,训练数据扩展至 100 万小时。项目采用 Apache-2.0 许可证,支持本地部署,提供 Docker、FastAPI、gRPC、vLLM、TensorRT-LLM 等多种部署方式。

多语种流式合成深度学习
09.08
内容创作主题配图

YouMind GPT Image 2 提示词库

社区驱动的 GPT Image 2 提示词策展平台,提供已验证提示词与多语言支持

YouMind GPT Image 2 提示词库是一个由 YouMind 团队维护的社区驱动型 AI 图像提示词集合平台,覆盖 OpenAI GPT Image 2 模型。截至 2026 年 4 月 21 日,平台已收录 725+ 条提示词,并以每日更新的速度持续增长。平台提供 Web Gallery 和 GitHub 开源仓库两种使用方式,支持 16 种语言版本,采用 CC BY 4.0 开源协议。核心功能包括瀑布流布局、全文搜索、分类筛选、AI 一键生成以及社区投稿系统。平台从用途、风格、主体三个维度对提示词进行分类,共 44+ 个类别。此外,部分提示词支持 Raycast Snippets 集成,便于用户模板化使用。平台通过 GitHub Actions 每 12 小时自动同步更新,确保内容时效性。

多语言开源社区驱动
09.08
AI Animation README 配图
内容创作GitHub 项目

AI Animation

用 Prompt 模板驱动 AI 生成 HTML 动画的示例与模板集合

AI Animation 是一个由 Unclecheng 开发的 AI Prompt 模板集合项目,专注于用 AI 生成炫酷的 HTML 动画网页。项目包含分类整理的 Prompt 模板、多种预置 HTML 动画示例(技术可视化、PPT 模板、3D 效果等),配合 Trae、Claude、GPT-4o 等 AI 工具使用。项目定位为 AI 辅助内容创作与教育可视化,目标用户包括教育者、内容创作者和技术博主。核心能力包括技术概念可视化、PPT 风格模板、3D 效果演示、UI 参考重构以及纯前端零依赖实现。所有动画示例基于 HTML5、CSS3 和原生 JavaScript,不依赖任何外部库。项目提供 40+ 个预置 HTML 动画文件,涵盖网络协议、AI/ML 概念、PPT 模板等类别,可直接在浏览器中打开使用。项目采用 MIT 协议,但明确仅限学习研究,禁止商业用途。

3D 效果纯前端教育可视化
09.08
内容创作主题配图

GPT-image2(OpenAI 图像生成模型)

OpenAI 第二代原生图像生成模型,以 Transformer 端到端架构实现印刷级文字渲染与 UI 仿真。

GPT-image2 是 OpenAI 推出的第二代原生图像生成模型,模型 ID 为 gpt-image-1.5,属于 GPT 多模态模型家族中专门负责图像输出的成员。与 DALL·E 系列不同,它不是独立的扩散模型,而是直接嵌入在 GPT 推理架构中的图像生成能力,用同一个 Transformer 做文本理解和图像输出。该模型解决的核心问题是让 AI 生成的图片不再“一眼假”,在文字渲染、UI 仿真、细节精度、多语言支持等方面实现了跨越式提升。其核心优势包括:文字渲染达到印刷级精度,能精确模拟 App 界面、网页截图、后台管理面板,支持中文等多语言原生理解,并支持对话式迭代修改。模型通过 Responses API 和 Chat Completions API 接入,适合海报、UI 截图、试卷、书法、架构图等精确性场景。其局限包括成本较高(标准输入每张 8 美元)、生成速度较慢、审美需精细 Prompt 控制、无本地部署选项。

多模态图像生成文字渲染
09.08
Huobao Drama 火宝短剧 README 配图
内容创作GitHub 项目

Huobao Drama 火宝短剧

一站式 AI 短剧自动化生产平台,从剧本到成片全流程编排

Huobao Drama(火宝短剧)是由南京 AI 火宝团队开发的一站式 AI 短剧自动化生产平台,实现从剧本生成、角色设计、分镜制作到视频合成的全流程自动化。项目以 TypeScript 全栈构建,后端采用 Hono + Drizzle ORM + Mastra AI Agent 框架,前端使用 Nuxt 3 + Vue 3,数据库选用 SQLite。其核心价值在于将短剧制作拆解为剧本改写、角色提取、分镜拆解、音色分配、提示词生成五步流水线,每一步由专门的 AI Agent 负责,通过结构化数据在步骤间传递上下文。平台不依赖单一厂商,通过多厂商适配层(OpenAI、Gemini、MiniMax、火山引擎、阿里、Chatfire)实现图片、视频、TTS 的灵活切换。最终视频合成依赖 FFmpeg,支持 Docker 单镜像部署。项目采用 CC BY-NC-SA 4.0 许可证,禁止商业用途。

自动化生产AI短剧Drizzle ORM
09.08
内容创作主题配图

AI短剧开源工作流

用LLM、文生图、文生视频与TTS串联成自动化流水线,实现从剧本到成片的批量短剧生产

AI短剧开源工作流是一类利用大语言模型(LLM)、AI图像生成、AI视频生成、TTS语音合成等技术,实现从剧本或小说文本到完整短剧视频全自动化生产的开源工具链。其核心思想是将影视生产的每个环节模型化,用LLM做编剧和导演、用文生图做美术、用文生视频做摄影、用TTS做配音,再通过Agent工作流将所有环节串联成一条自动化流水线。报告覆盖三个代表性开源项目:moyin-creator(魔因漫创)为桌面端生产级工具,深度绑定Seedance 2.0,采用6层身份锚点保证角色一致性;waoowaoo为Web端工业级AI影视平台,专攻网文转视频;huobao-drama(火宝短剧)为极简一站式平台,内置5个Mastra AI Agent,支持一句话生成完整短剧。这些项目覆盖了剧本解析、角色生成、场景生成、分镜制作、视频生成、配音合成、成片导出的核心链路,旨在将传统短剧3-6个月的生产周期压缩到数小时甚至数分钟。

工作流角色一致性开源
09.08
内容创作主题配图

GPT-Image 2 极简几何海报提示词

一段结构化提示词,让 AI 为任意产品快速生成极简几何装置风的商业级产品海报。

这是一套基于 ChatGPT Image 2.0 的提示词设计方法论,属于 AI 图像生成领域的 Prompt Engineering 范畴。其核心是通过一段精心设计的结构化提示词,让 AI 为任意产品一次性生成极简几何装置风的产品海报,达到商业级品牌 KV 级别的视觉效果。该方法旨在解决商业产品海报制作中“质量-成本-速度”的不可能三角,通过一段提示词加一张产品图,在几十秒内产出品牌级海报。提示词支持双模式输入:提供产品图时保留其核心外观特征与配色;仅输入产品名时,则自动生成符合产品定位的外观与包装设计。其底层依赖 OpenAI 的 GPT-Image 2.0 多模态图像生成模型,但提示词的设计逻辑可迁移至其他图像生成模型。

产品海报批量生产商业设计
09.08