项目概览
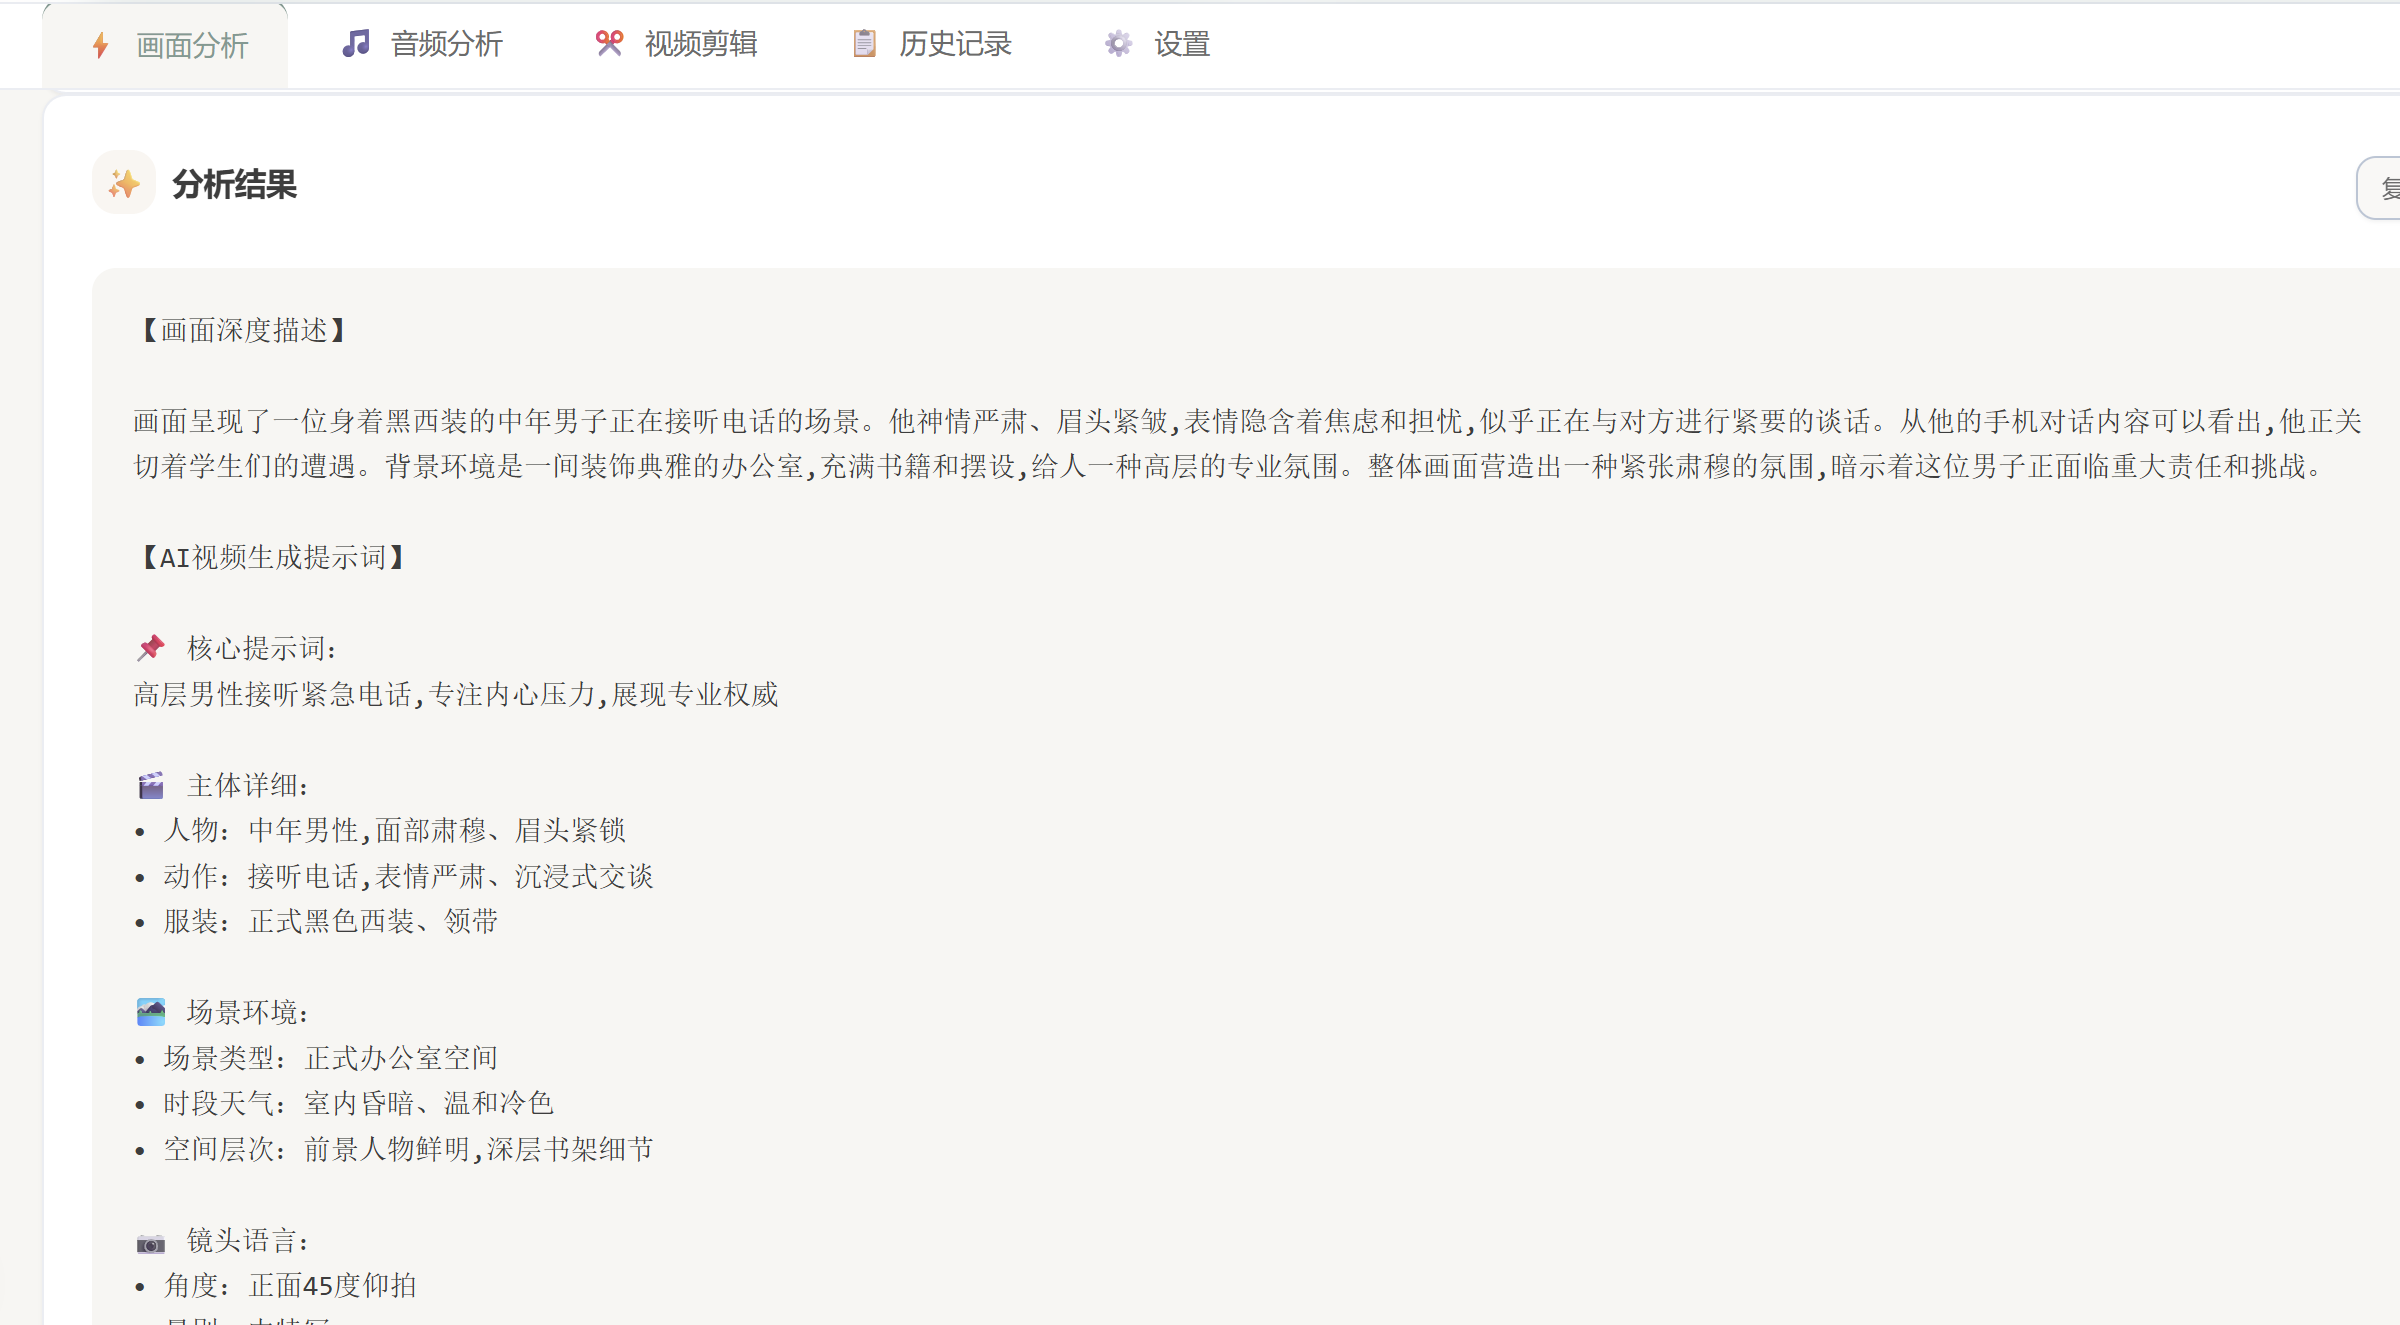
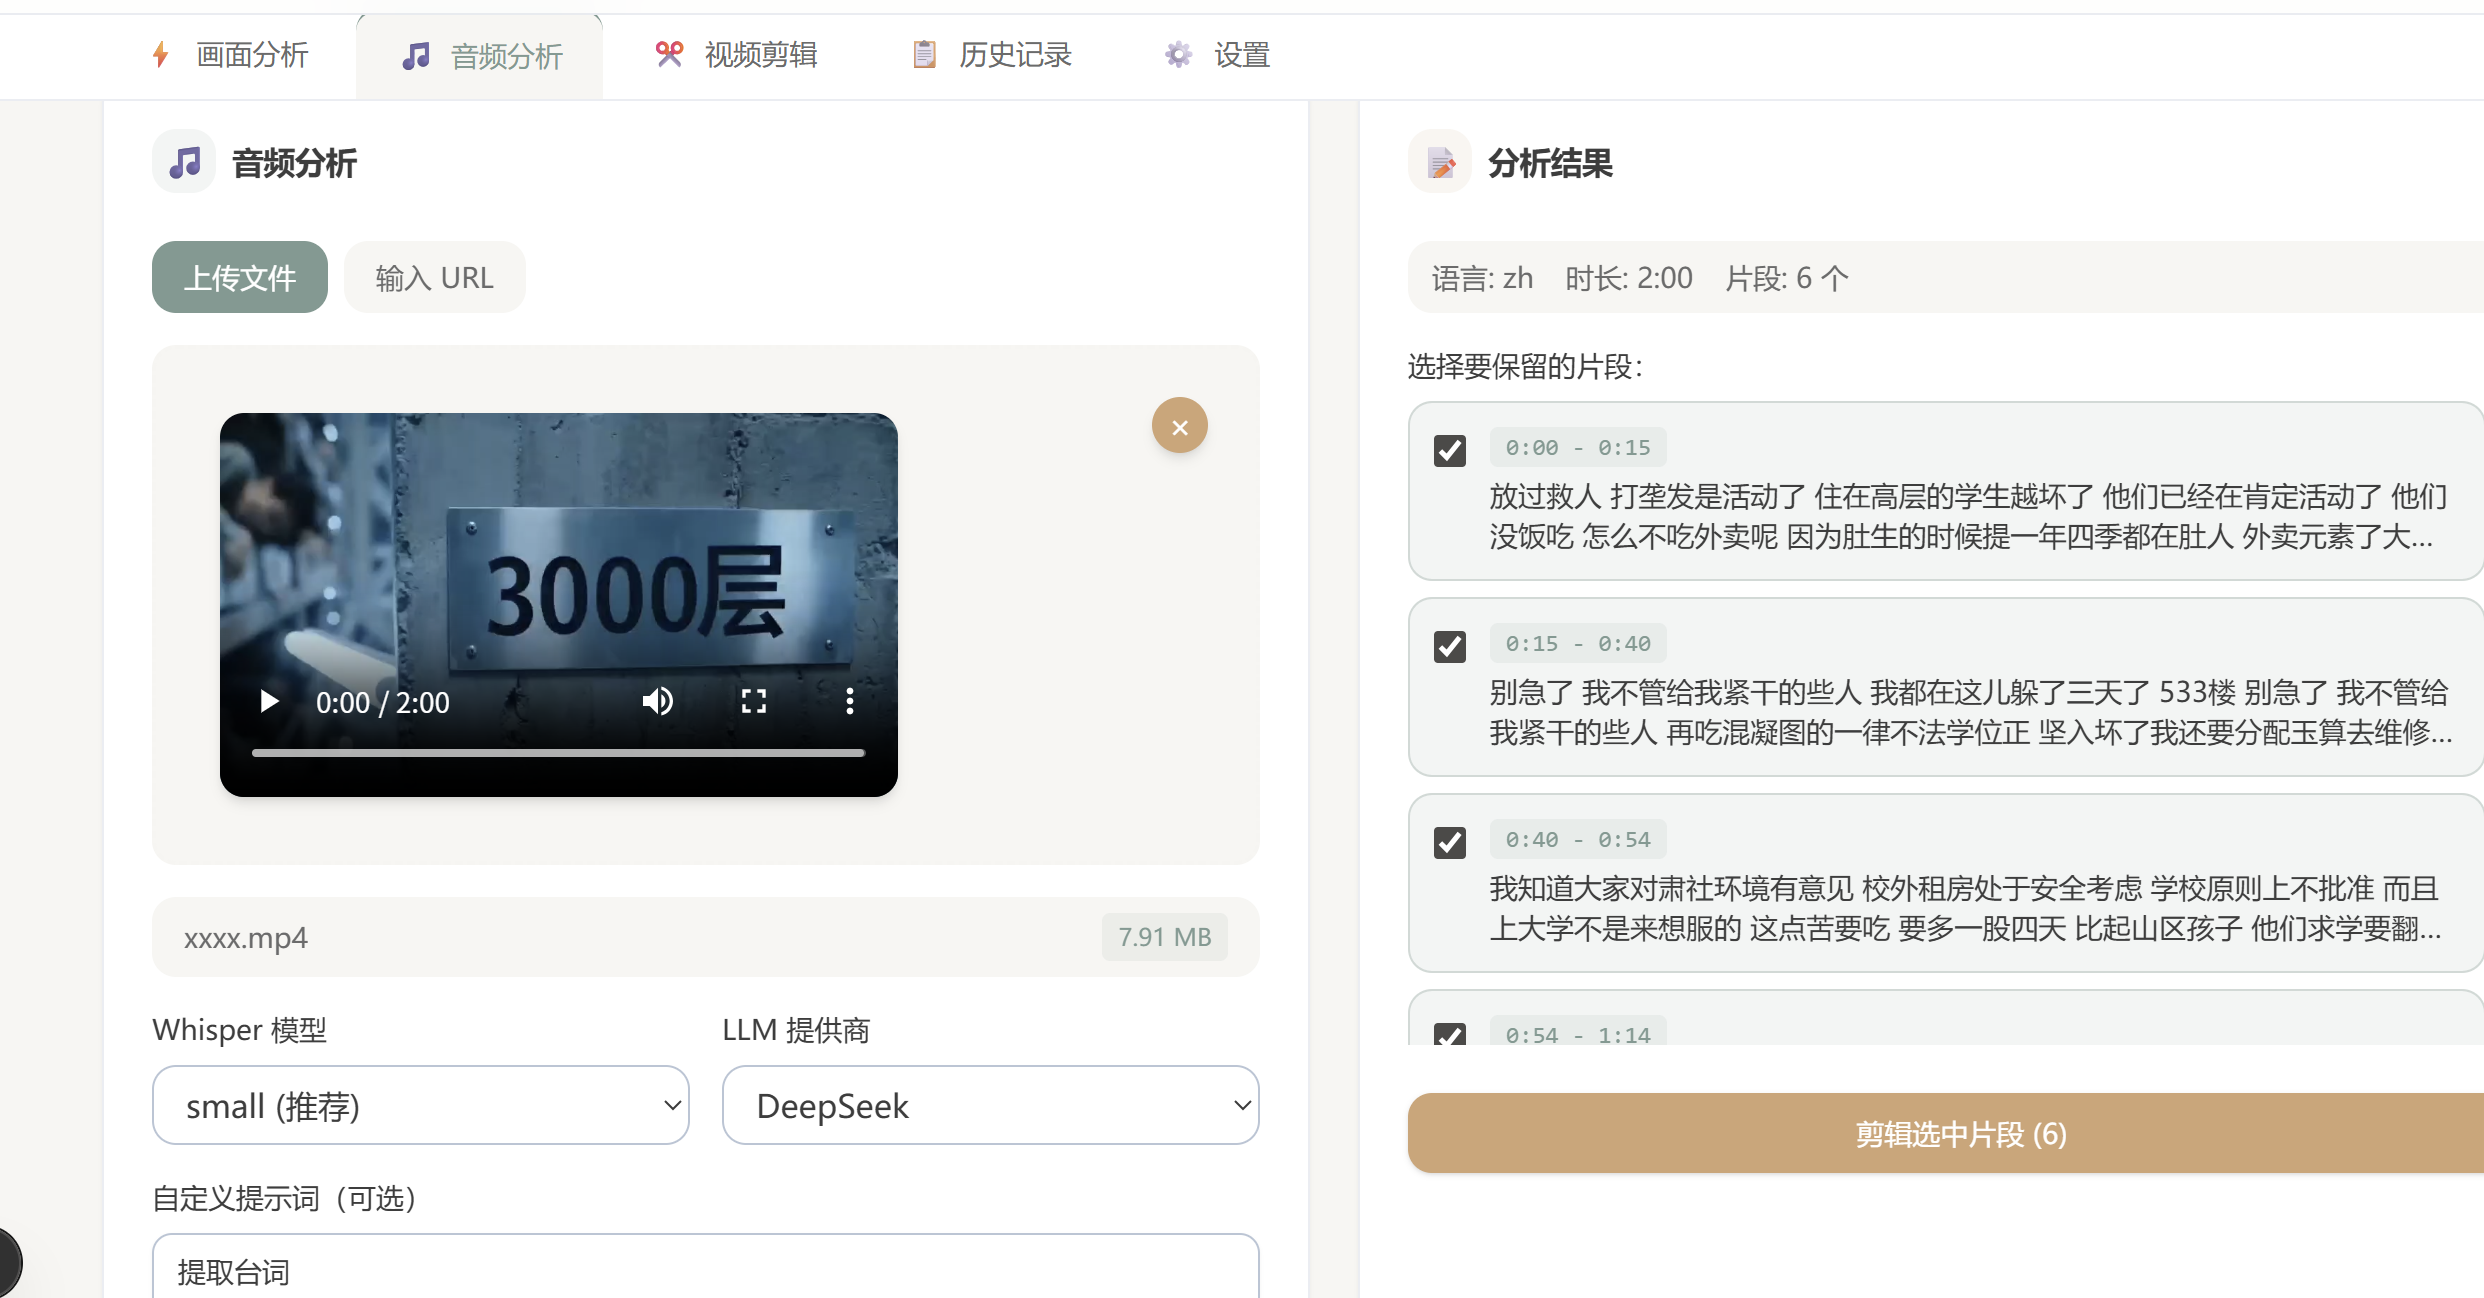
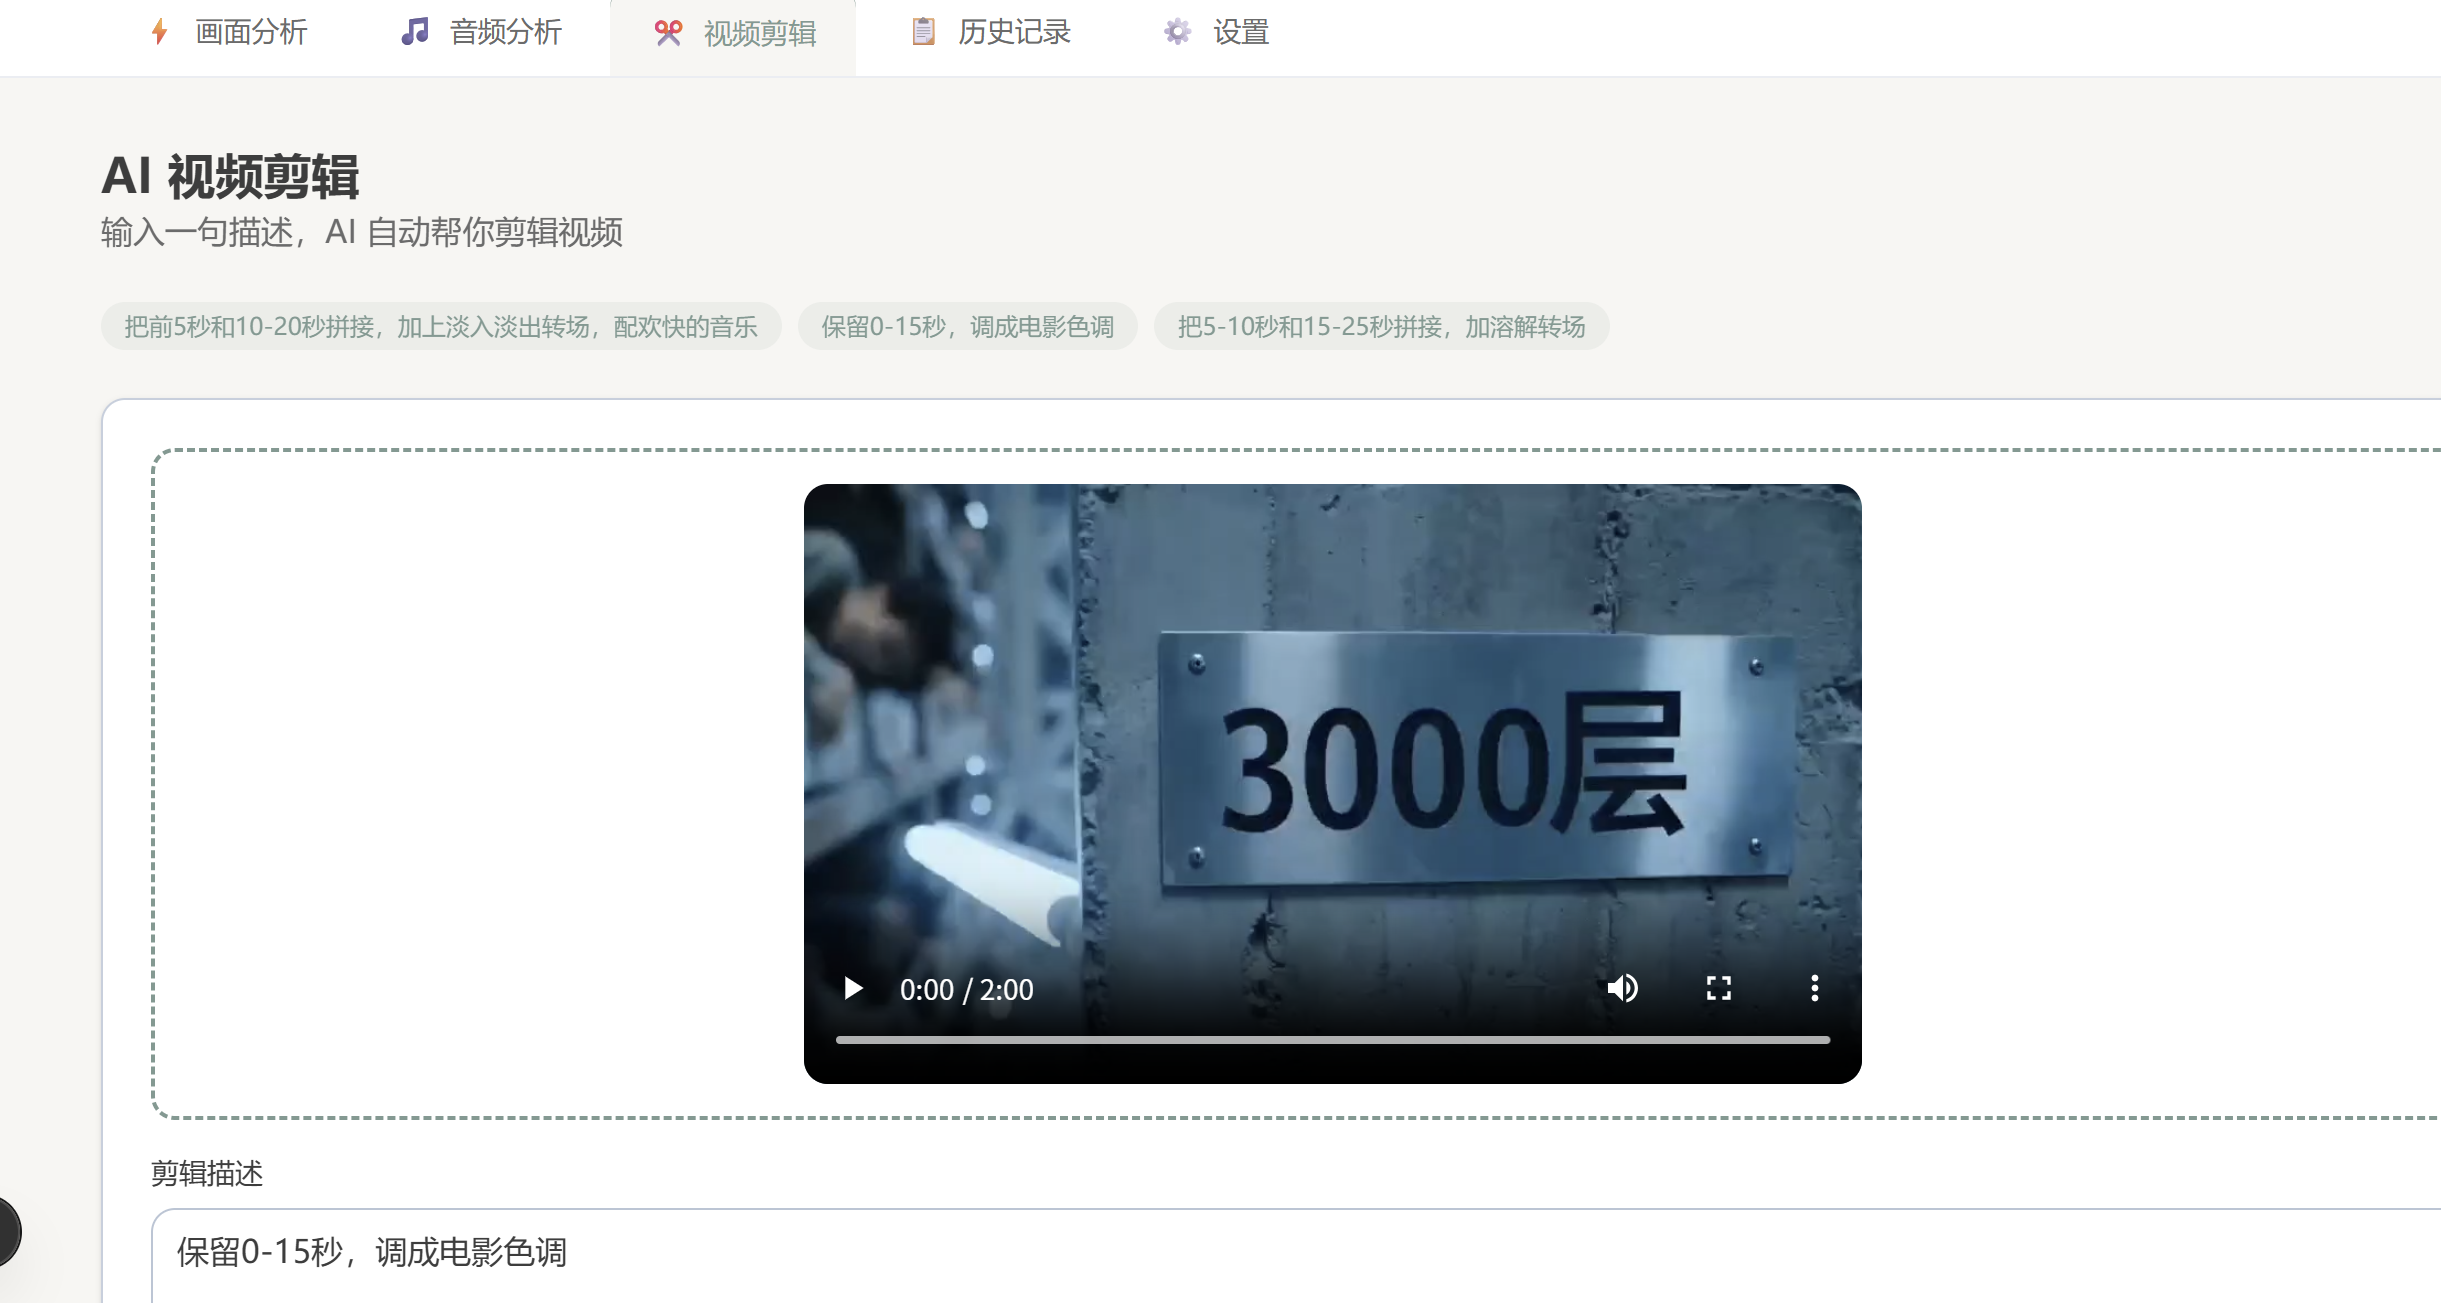
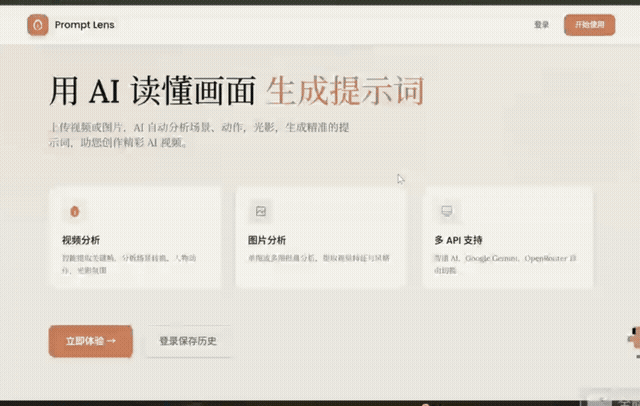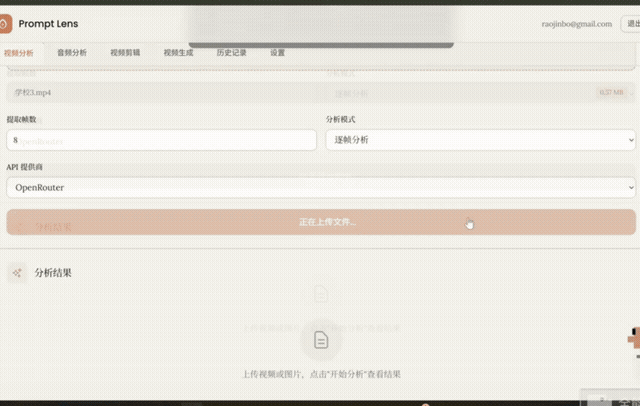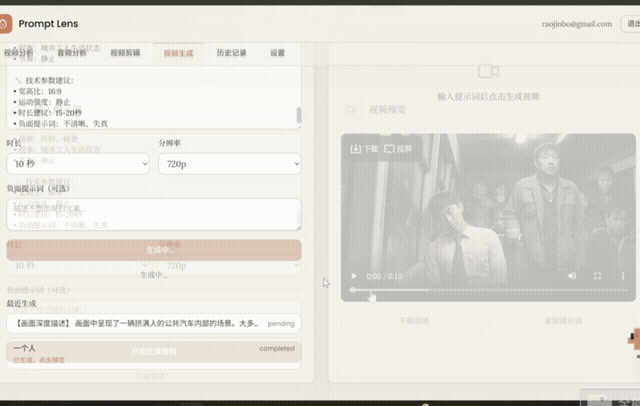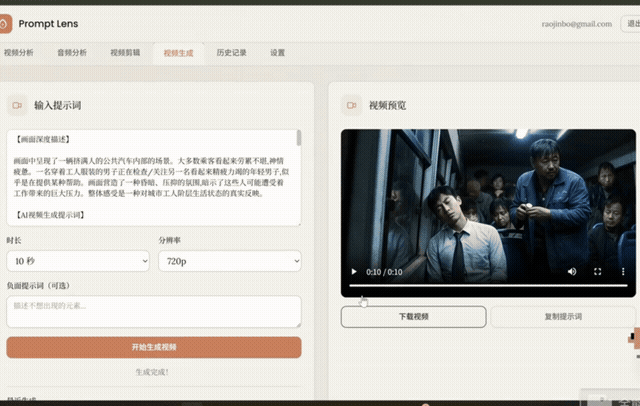
PromptLens 是一款开源的 AI 视频提示词反推分析工具,提供完整的 Web 应用体验。其核心能力是上传 AI 生成的视频或图片,自动提取关键帧,通过多模态大模型(如智谱 GLM-4V、Google Gemini、OpenRouter)分析画面内容,反向推导出可能使用的提示词,并输出结构化的、可直接复用的英文提示词。项目采用 Next.js 15 + React 19 全栈技术,使用 Supabase PostgreSQL 存储数据,Cloudflare R2 存储媒体文件,FFmpeg 进行视频帧提取,支持 better-auth 的 Google/GitHub 登录。除画面分析外,还支持通过 AssemblyAI 进行音频识别,提取视频中的语音旁白和台词。项目以 MIT 许可证开源,代码透明,可自由修改和商用。
解决什么问题
当用户在社交媒体上看到惊艳的 AI 生成视频时,往往想知道其使用的提示词,以便生成自己的版本。传统做法包括纯肉眼描述、手动截图配合 CLIP Interrogator、在社区寻找分享的提示词或直接询问作者,但这些方式存在明显痛点:手动截图效率极低,难以均匀捕捉关键帧;CLIP 模型输出的是标签式描述,缺乏细节和结构化格式;单帧截图丢失视频运动信息;工具链碎片化,缺乏一站式解决方案;音频信息被忽略。PromptLens 旨在优化从"看到好视频"到"拿到好提示词"的整条链路,将原本需要 30 分钟以上手动操作的过程压缩到几分钟内自动完成。
工作方式
PromptLens 的核心原理是一条清晰的管线:输入视频或图片,通过 FFmpeg 进行帧提取,将 JPEG 帧转换为 Base64 编码,作为图片输入传给多模态 AI 模型,最后按照精心设计的 Prompt 模板引导输出结构化提示词。帧提取采用均匀采样策略,根据视频时长和用户指定的帧数(默认 8 帧)计算均匀间隔,使用高质量输出参数确保画质。AI 分析支持多个提供商:智谱 AI 使用 GLM-4V-Plus 模型,Google Gemini 使用 Gemini 2.0 Flash,OpenRouter 可路由到 Claude 3 Haiku 等模型。分析结果保存到 Supabase PostgreSQL 数据库,关联用户 ID、原始媒体 URL、分析模式、完整提示词和核心提示词等信息。此外,通过 AssemblyAI 服务可提取视频音频轨道进行语音转文字,作为提示词分析的补充信息。
核心能力
- 自动帧提取:FFmpeg 均匀采样,默认提取 8 帧,保留时序信息
- 多帧分析:按时间顺序排列帧图片,让 AI 理解视频叙事弧线
- 结构化输出:通过 Prompt 模板引导输出核心提示词、主体描述、环境描述、光影风格、运镜方式等
- 多 AI 提供商:支持智谱 AI、Google Gemini、OpenRouter,用户可自由选择
- 音频识别:通过 AssemblyAI 提取视频中的语音旁白和台词
- 视频与图片双支持:不限于图片,能处理视频的时序信息
- 完整用户系统:支持 Google/GitHub 登录,数据隔离,历史记录持久化
- 管理后台:支持用户管理和操作日志审计
- 国际化支持:通过 next-intl 支持多语言
- 测试覆盖:Vitest 单元测试和 Playwright E2E 测试
使用前需要了解
- AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
- 报告明确指出,反推提示词不等于原始提示词,AI 视频生成过程不可逆,PromptLens 只能模拟提示词,无法真正提取原始 Prompt。帧数越多不一定分析越准确,过多的帧会增加 API Token 消耗和处理时间,默认 8 帧是经验平衡值。分析质量依赖所选 AI 模型,不同模型差异较大。视频长度受 100MB 文件大小限制,长视频需要预处理。Vercel Serverless Functions 有 10MB 内存限制,无法直接使用 FFmpeg,生产环境需使用 Mux 等替代方案或部署独立的视频处理服务。项目目前没有发布任何 Release 版本,历史记录、用户设置、管理员后台等功能在报告中标注为"开发中"状态,更适合作为学习项目、内部工具或二次开发的基础。分析提示词模板主要针对中文用户设计。