项目概览
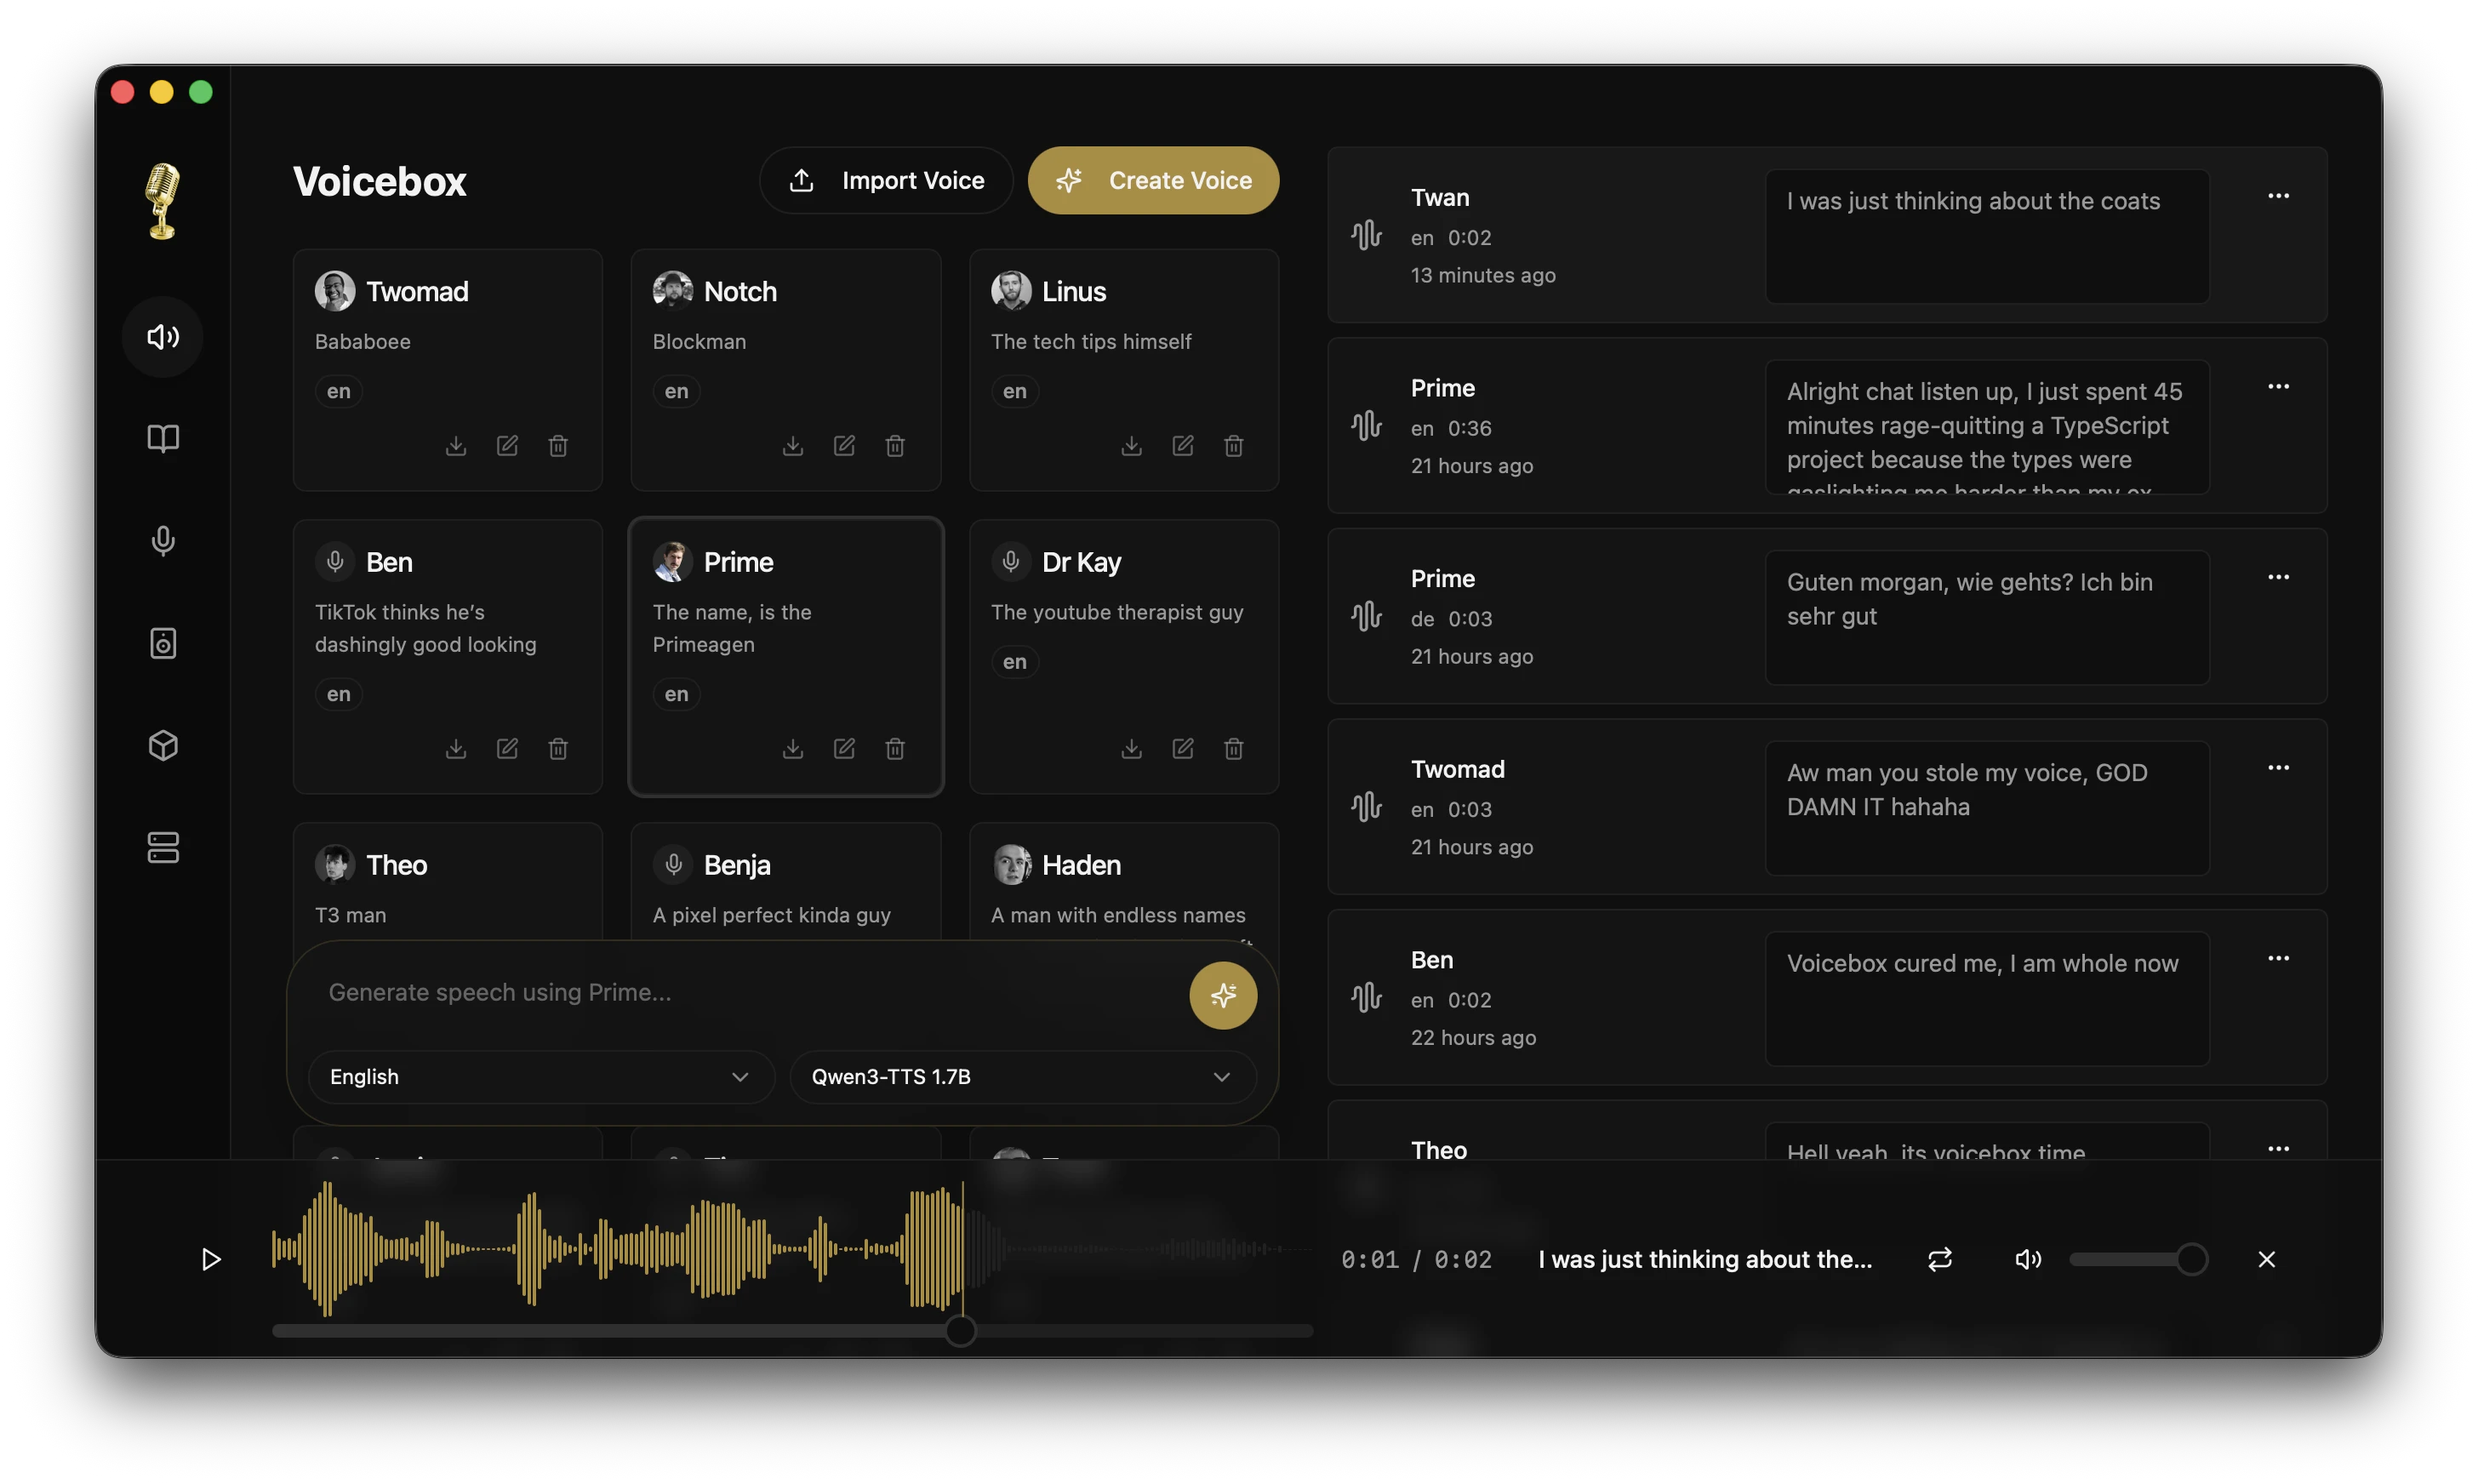
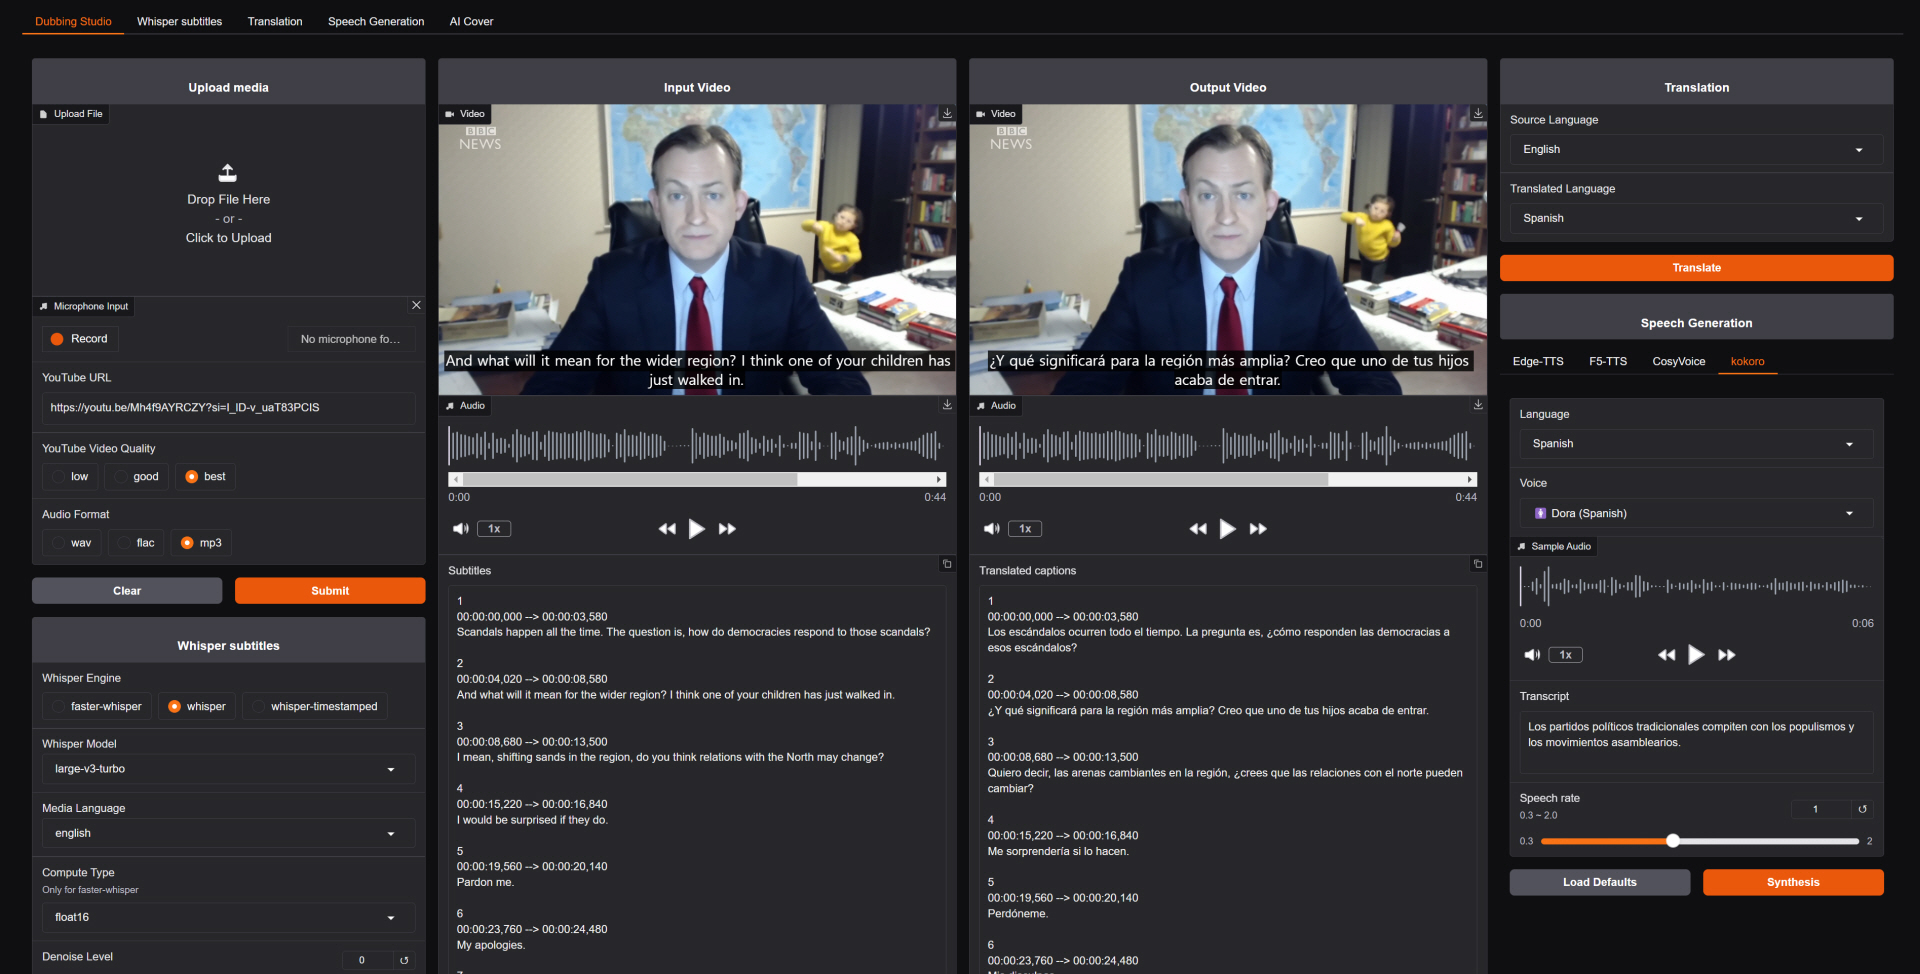
Voice-Pro 是一款面向创作者和开发者的 AI 音频全流程处理工具,由韩国创业公司 ABUS 开发,基于 Gradio WebUI 构建。它将视频下载、音频分离、语音识别、多语言翻译、文本转语音(TTS)和零样本声音克隆集成到一个统一的 Web 界面中,定位为 ElevenLabs 的开源替代方案。核心价值在于将传统需要 5-8 个工具配合的流程(下载、分离、识别、翻译、配音、字幕)串联成一条自动化管道,用户只需输入视频链接,即可获得多语言配音视频和字幕。工具支持四种 Whisper 变体用于语音识别,三种零样本声音克隆引擎(F5-TTS、E2-TTS、CosyVoice),以及 Edge-TTS、kokoro 等多语言 TTS。完全开源免费,本地运行,数据不出机器。需要 NVIDIA GPU(最低 4GB 显存,推荐 8GB+),首次部署需下载模型,耗时较长。
解决什么问题
传统视频配音工作流存在六大痛点。工具碎片化:做一段多语言配音视频,传统流程需要在 5-8 个工具之间来回切换,每换一个工具就要学一套界面、导出/导入一次文件,流程割裂。声音克隆门槛高:零样本声音克隆技术虽然开源,但部署需要配置 Python 环境、处理 PyTorch/CUDA 依赖冲突、编写推理脚本、手动管理模型下载,对非技术背景的创作者几乎不可逾越。翻译质量与 TTS 断裂:翻译工具输出纯文本或 Markdown,TTS 需要带时间轴的逐句文本,字幕需要 SRT/ASS 格式,三者句切分逻辑不一致,导致字幕和配音对不上。SaaS 成本高昂:主流 SaaS 平台处理 60 分钟视频的成本约 $24-$48,月度订阅模式下中小创作者支出压力大。GPU 资源浪费:独立工具各自加载模型到 GPU,依次使用时 GPU 在每个阶段只跑一个模型,其余时间空闲。跨语言一致性难保证:原语言的语音特征在翻译后完全丢失,跨语言声音克隆需要一整套工程。
工作方式
Voice-Pro 将 AI 音频全流程(下载→分离→识别→翻译→合成→字幕)集成到一个 Gradio 界面,用模型管道串联所有环节。技术栈为 Python 3.10.15 + PyTorch 2.5.1+cu124 + Gradio 5.14.0,依赖 NVIDIA GPU(CUDA 12.4)加速推理。核心设计原则包括:管道化,每个功能模块都是独立管道的节点,上游输出自动成为下游输入;模型可插拔,同一功能节点可切换不同引擎;本地优先,核心功能全部本地运行,数据不出机器。语音识别集成四种 Whisper 变体:OpenAI Whisper(官方原版)、Faster-Whisper(CTranslate2 加速,4x 推理速度)、Whisper-Timestamped(词级时间戳精度最高)、WhisperX(强制对齐+说话人分离)。零样本声音克隆支持 F5-TTS(非自回归扩散模型,3-10 秒参考音频)、E2-TTS(等长非自回归,推理快)、CosyVoice(LLM+Flow Matching 两阶段架构,支持跨语言克隆)。音频分离使用 Demucs(U-Net 变体,输出人声/鼓/贝斯/其他四轨)。翻译使用 Deep-Translator(免费,支持 Google、MyMemory、LibreTranslate 等后端)和 Azure Translator(付费版),通过 spaCy 做逐句翻译保持句子边界一致性。
核心能力
- 全流程一体化:下载→分离→识别→翻译→配音→字幕,一个界面搞定
- 完全开源免费:v3.2 起全部代码开源,无使用限制、无分钟数限制
- 多引擎可插拔:每个环节都有 2-4 个可选引擎,自由组合
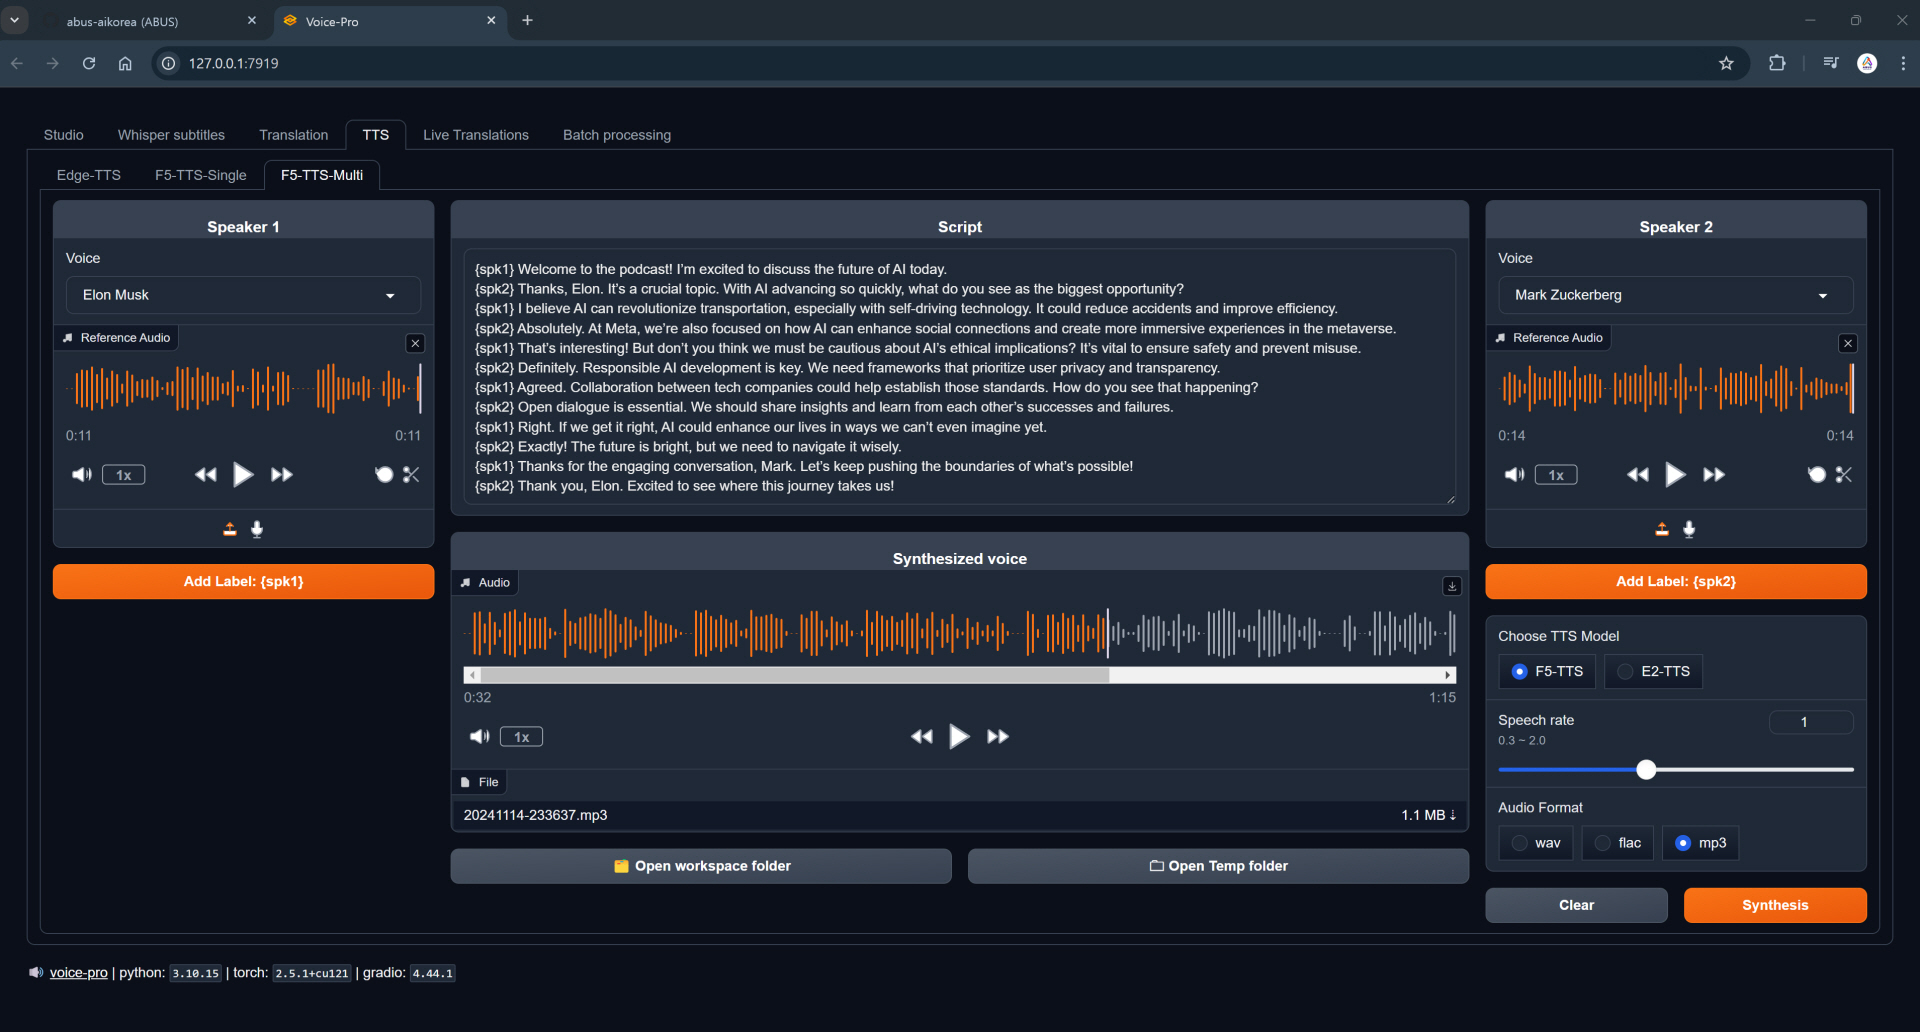
- 零样本声音克隆:3-10 秒参考音频即可克隆说话人声音
- 跨语言克隆:CosyVoice 支持中文样本克隆英文/日文/韩文发音
-
- 语言覆盖:语音识别 90+ 语言、翻译 100+ 语言、TTS 100+ 语言
- 本地运行,数据不出机器
- 内置 40+ 名人 30 秒声音样本
- 便携式安装:一键安装卸载,不留系统残留
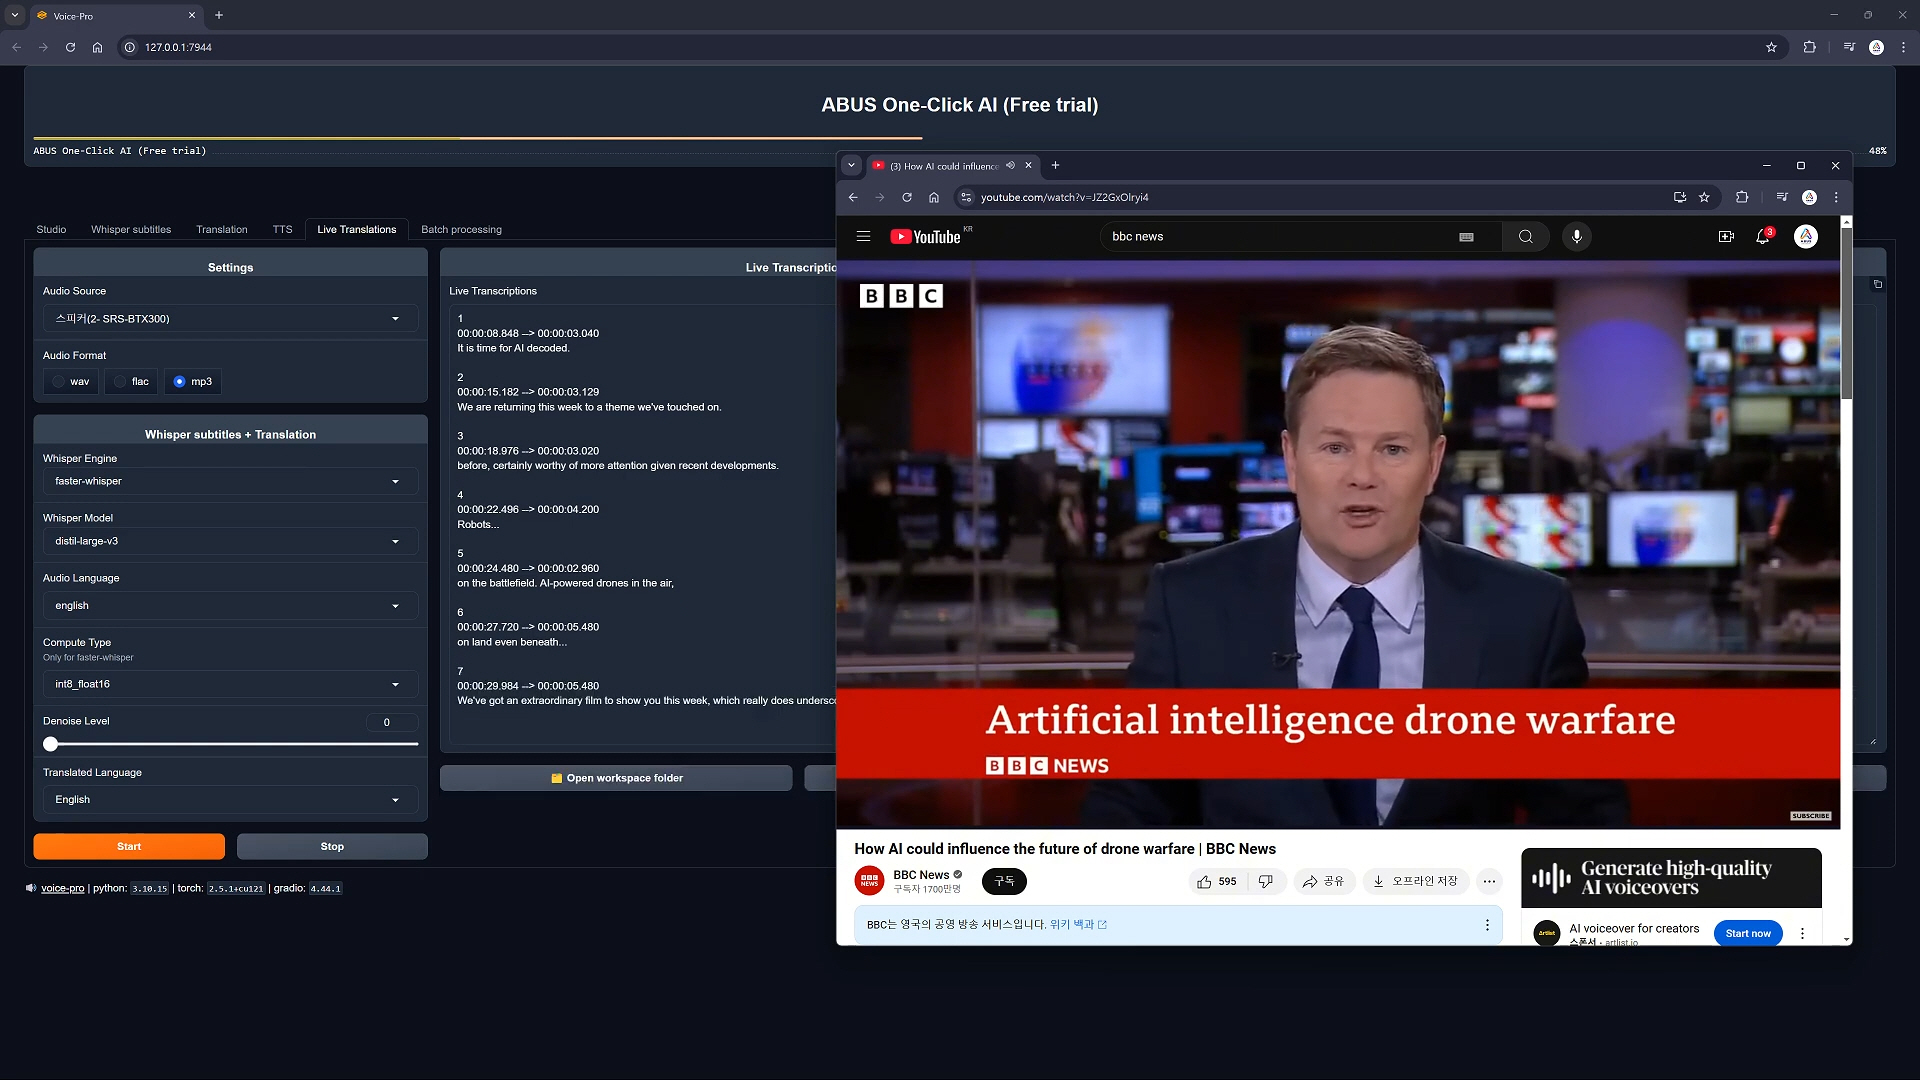
- 支持实时语音识别+翻译(适合会议同传)
使用前需要了解
- AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
- 硬件要求:必须配备 NVIDIA GPU(最低 4GB VRAM,推荐 8GB+),Mac 和 Linux 支持但未经充分验证,主要在 Windows + NVIDIA GPU 环境测试。首次部署耗时长:configure + start 首次运行需要 2-3 小时(下载模型、安装依赖),CosyVoice 首次运行需下载约 9GB 模型。模型体积大:全套模型占用 20GB+ 磁盘空间。项目维护暂停:团队专注于 WeConnect 项目,暂无更新计划,Bug 修复和功能迭代停滞。声音克隆质量不及 ElevenLabs:在情感表达、长文本一致性、细粒度控制方面仍有差距。免费版翻译质量有限:Deep-Translator 依赖免费翻译 API,小语种质量不如 Azure。实时翻译延迟:取决于 Whisper 推理速度,大模型延迟较高。批量处理能力弱:UI 是单任务设计,没有批处理队列或自动化流水线。无 API 服务:只有 Gradio WebUI,没有 REST API 或 SDK,集成到第三方系统需要额外开发。翻译功能依赖 Deep-Translator(调用 Google/MyMemory 在线 API),Edge-TTS 也需要网络,完全离线场景下翻译和 Edge-TTS 不可用。名人声音克隆涉及肖像权和声音权的法律风险,需确保合规使用。