跳到主要内容
InfiniteTalk · prolist
查看仓库原始简介 Unlimited-length talking video generation that supports image-to-video and video-to-video generation
来自项目 README 项目解读 README
项目解读由 AI 根据历史资料整理,尚未经人工复核。仓库资料更新于 2026-09-08,与历史解读分开保留。
项目概览 InfiniteTalk 是美团 MeiGen-AI 团队于 2025 年 8 月开源的音频驱动无限长说话视频生成框架,全称 "Audio-driven Video Generation for Sparse-Frame Video Dubbing"。它提出了一种新型视频配音范式——"稀疏帧视频配音",通过保留原始视频的关键参考帧,在维持身份信息、标志性手势和摄像机轨迹的同时,对全身运动进行音频同步的编辑。给定一段源视频和目标音频,可生成与音频精确口型同步、头部/身体/表情联动的全新视频;给定一张人物图片和音频,可从零生成无限长的说话人视频。支持 480P 和 720P 分辨率,默认最大 1000 帧/40 秒,可流式扩展。底层基于扩散模型构建,使用 Wan2.1-I2V-14B 作为视频生成基座,音频编码器采用 Wav2Vec2。项目以 Apache-2.0 许可证开源。
解决什么问题 传统视频配音技术主要聚焦口型区域编辑,典型方案包括 Wav2Lip、MuseTalk、LatentSync 等,只修改嘴部区域像素,不动其他部分,由此带来三大核心问题:表情不协调,说话人在说"啊!"但脸上毫无惊讶表情;身体僵硬,身体、头部完全不动,观感极不自然;情绪脱节,音频传递的情绪和画面中人的神态完全脱节。传统方案本质上是"像素替换"问题,在短视频(10 秒内)还能接受,但在长视频中观者的不协调感会随时间指数级放大。直接使用 Image-to-Video 模型(如 Sora、Wan2.1)做音频驱动也存在两个关键失败原因:无法实现自适应条件化,传统 I2V 模型把参考图作为硬约束,要么控制太强导致动作僵硬,要么控制太弱导致身份丢失;无法处理长序列,I2V 模型通常只能生成几秒的视频,无法维持长时的时序一致性。InfiniteTalk 解决的是从"音频 → 全身运动生成 → 长序列视频合成"这条完整链路的问题,不是在嘴上加 patch,而是用音频重新生成整段视频,以稀疏关键帧作为锚点,确保身份、背景和摄像机运动不被破坏。
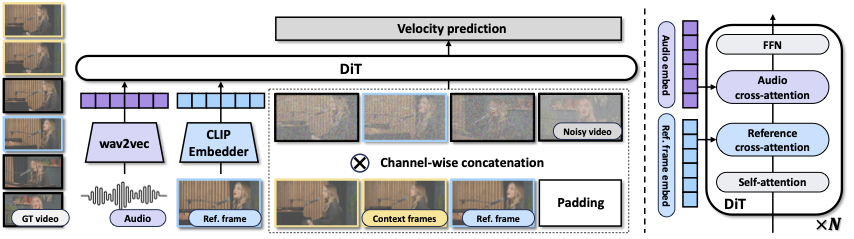
工作方式 整体原理链路为:输入源视频(或图片)和目标音频;通过 Wav2Vec2 音频编码器提取语音内容特征;从源视频中均匀采样稀疏关键帧作为参考帧;从上一个已生成块中取尾部帧作为当前块的前置上下文帧;以音频特征和参考帧为条件,使用 Wan2.1 DiT 扩散模型生成新视频块;将生成块逐一拼接成完整视频。视频生成基座采用阿里 Wan2.1 的 Image-to-Video 14B 参数模型,基于 DiT(Diffusion Transformer)架构。核心贡献是一组注入到 Wan2.1 DiT 中的条件权重(infinitetalk.safetensors),使模型能够接收音频特征作为额外条件。流式生成机制将长视频分成多个 chunk(每个 chunk 约 9 帧),逐块生成,每个 chunk 利用前一个 chunk 的尾部帧作为上下文,保证块间过渡平滑。关键机制是自适应条件强度:控制强度由视频上下文与图像条件之间的相似度决定,当生成内容与参考帧高度相似时控制强度自然较高,保持身份一致性;差异较大时控制强度自然降低,允许更多运动自由度。基于此提出精细参考帧定位策略,动态调整参考帧在时间轴上的位置,平衡"身份保持"和"运动对齐"之间的矛盾。多人动画模式通过共享音频特征和各自的参考帧,支持同时驱动画面中多个人物的说话动画。
核心能力
支持 V2V 和 I2V 两种模式:给定源视频+目标音频生成口型同步、头部/身体/表情联动的视频;给定人物图片+音频从零生成无限长说话人视频
支持 480P(832×480)和 720P(1280×720)分辨率
支持无限时长,默认最大 1000 帧/40 秒,可流式扩展
全身运动同步:头部、表情、身体、手势全部跟随音频联动
多人动画模式:可同时驱动画面中多个人物的说话动画
多种推理加速方案:TeaCache、FP8 量化、LCM 蒸馏、Sparse Attention、FusionX LoRA、Low VRAM 模式
支持多卡分布式推理,8 卡环境下加速约 6-7 倍
提供 Gradio Web UI 和 ComfyUI 节点集成方式
以 Apache-2.0 许可证开源
使用前需要了解
AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
计算资源需求高:基座模型 14B 参数,标准推理需要 40GB+ 显存,最低要求 NVIDIA 24GB 显存(Low VRAM 模式),模型权重约 80GB+。推理速度慢:40 步去噪采样,生成 1 分钟视频需要数分钟(GPU 时间)。色彩偏移:长视频生成超过 1 分钟后会出现明显的色彩偏移问题,FusionX LoRA 会加剧此问题,I2V 模式超过 1 分钟后色彩偏移加剧。摄像机运动控制有限:V2V 模式虽然会模仿原始摄像机运动但不精确,长视频尤为明显。身份保持非完美:因为是全局重新生成,身份信息有轻微变化。非实时:扩散模型推理延迟不适合实时通话场景,每帧推理仍需数百毫秒,远不能满足实时对话的延迟要求(<200ms)。不适用于精确口型匹配场景,全局生成方式对口型的精确控制不如 Wav2Lip。不适用于极低算力环境,14B 模型即使量化也需要 24GB 显存。不适用于身份要求极高的场景(如身份验证视频),全局生成会引入不可控变化。快速运动场景会加剧时序不一致。实际推荐使用长度在 1-3 分钟内效果最佳。多人模式必须使用
简体中文 · AI 译文 原文
AI 中文译文,非官方翻译;安装命令与技术细节请对照原文。
TL; DR: InfiniteTalk 是一个无限长度的说话视频生成模型,支持音频驱动的视频到视频和图像到视频生成
🔥 最新消息
2026年5月21日:🚀 我们发布了 LongCat-Video-Avatar-1.5
--num_persistent_param_in_dit 0
2025年8月19日:我们发布了 InfiniteTalk 的技术报告 、权重和代码。Gradio 和 ComfyUI 分支已发布。 2025年8月19日:我们发布了 InfiniteTalk 的项目页面
✨ 主要特性 我们提出 InfiniteTalk ,一种新颖的稀疏帧视频配音框架。给定输入视频和音频轨道,InfiniteTalk 合成一个新视频,具有准确的唇形同步,同时使头部运动、身体姿态和面部表情与音频对齐。与仅关注嘴唇的传统配音方法不同,InfiniteTalk 支持无限长度视频生成,具有准确的唇形同步和一致的身份保持。此外,InfiniteTalk 也可以作为图像-音频到视频模型使用,输入为图像和音频。
💬 稀疏帧视频配音 – 不仅同步嘴唇,还同步头部、身体和表情
⏱️ 无限长度生成 – 支持无限视频时长
✨ 稳定性 – 相比 MultiTalk 减少手部/身体变形
🚀 唇形准确性 – 实现优于 MultiTalk 的唇形同步
🌐 社区作品
📑 待办列表
视频演示
图像到视频
快速开始
🛠️安装
1. 创建 conda 环境并安装 pytorch、xformers conda create -n multitalk python=3.10
conda activate multitalk
pip install torch==2.4.1 torchvision==0.19.1 torchaudio==2.4.1 --index-url https://download.pytorch.org/whl/cu121
pip install -U xformers==0.0.28 --index-url https://download.pytorch.org/whl/cu121
2. Flash-attn 安装: pip install misaki[en]
pip install ninja
pip install psutil
pip install packaging
pip install wheel
pip install flash_attn==2.7.4.post1
3. 其他依赖 pip install -r requirements.txt
conda install -c conda-forge librosa
4. FFmeg 安装 conda install -c conda-forge ffmpeg
sudo yum install ffmpeg ffmpeg-devel
🧱模型准备
1. 模型下载 huggingface-cli download Wan-AI/Wan2.1-I2V-14B-480P --local-dir ./weights/Wan2.1-I2V-14B-480P
huggingface-cli download TencentGameMate/chinese-wav2vec2-base --local-dir ./weights/chinese-wav2vec2-base
huggingface-cli download TencentGameMate/chinese-wav2vec2-base model.safetensors --revision refs/pr/1 --local-dir ./weights/chinese-wav2vec2-base
huggingface-cli download MeiGen-AI/InfiniteTalk --local-dir ./weights/InfiniteTalk
🔑 快速推理
一些提示
唇形同步精度:音频CFG在3-5之间效果最佳。增大音频CFG值可获得更好的同步效果。
FusionX:虽然它能实现更快的推理和更高的质量,但FusionX LoRA会加剧超过1分钟视频的颜色偏移,并降低视频中的人物ID保持度。
V2V生成:支持无限长度生成。模型会模仿原始视频的镜头运动,但并非完全一致。使用SDEdit可显著提高镜头运动准确性,但会引入颜色偏移,最适合短视频。针对长视频的镜头控制改进已在计划中。
I2V生成:从单张图像生成最长1分钟的良好结果。超过1分钟后,颜色偏移会变得更加明显。一个生成超过1分钟高质量视频的技巧是,通过平移或放大图像将图像复制为视频。这里有一个将图像转换为视频 的脚本。
量化模型:如果您的推理过程因内存不足而被终止,我们建议使用量化模型,它可以帮助减少内存使用 。
InfiniteTalk的使用 --mode streaming: long video generation.
--mode clip: generate short video with one chunk.
--use_teacache: run with TeaCache.
--size infinitetalk-480: generate 480P video.
--size infinitetalk-720: generate 720P video.
--use_apg: run with APG.
--teacache_thresh: A coefficient used for TeaCache acceleration
—-sample_text_guide_scale: When not using LoRA, the optimal value is 5. After applying LoRA, the recommended value is 1.
—-sample_audio_guide_scale: When not using LoRA, the optimal value is 4. After applying LoRA, the recommended value is 2.
—-sample_audio_guide_scale: When not using LoRA, the optimal value is 4. After applying LoRA, the recommended value is 2.
--max_frame_num: The max frame length of the generated video, the default is 40 seconds(1000 frames).
1. 推理
1) 使用单GPU运行 python generate_infinitetalk.py \
--ckpt_dir weights/Wan2.1-I2V-14B-480P \
--wav2vec_dir 'weights/chinese-wav2vec2-base' \
--infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
--input_json examples/single_example_image.json \
--size infinitetalk-480 \
--sample_steps 40 \
--mode streaming \
--motion_frame 9 \
--save_file infinitetalk_res
2) 使用720P运行 如果您想使用720P运行,请设置--size infinitetalk-720:
python generate_infinitetalk.py \
    --ckpt_dir weights/Wan2.1-I2V-14B-480P \
    --wav2vec_dir 'weights/chinese-wav2vec2-base' \
    --infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
    --input_json examples/single_example_image.json \
    --size infinitetalk-720 \
    --sample_steps 40 \
    --mode streaming \
    --motion_frame 9 \
    --save_file infinitetalk_res_720p
3) 在极低显存下运行 如果您想在极低显存下运行,请设置--num_persistent_param_in_dit 0:
python generate_infinitetalk.py \
    --ckpt_dir weights/Wan2.1-I2V-14B-480P \
    --wav2vec_dir 'weights/chinese-wav2vec2-base' \
    --infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
    --input_json examples/single_example_image.json \
    --size infinitetalk-480 \
    --sample_steps 40 \
    --num_persistent_param_in_dit 0 \
    --mode streaming \
    --motion_frame 9 \
    --save_file infinitetalk_res_lowvram
4) 多GPU推理 GPU_NUM=8
torchrun --nproc_per_node=$GPU_NUM --standalone generate_infinitetalk.py \
--ckpt_dir weights/Wan2.1-I2V-14B-480P \
--wav2vec_dir 'weights/chinese-wav2vec2-base' \
--infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
--dit_fsdp --t5_fsdp \
--ulysses_size=$GPU_NUM \
--input_json examples/single_example_image.json \
--size infinitetalk-480 \
--sample_steps 40 \
--mode streaming \
--motion_frame 9 \
--save_file infinitetalk_res_multigpu
5) 多人动画 python generate_infinitetalk.py \
--ckpt_dir weights/Wan2.1-I2V-14B-480P \
--wav2vec_dir 'weights/chinese-wav2vec2-base' \
--infinitetalk_dir weights/InfiniteTalk/multi/infinitetalk.safetensors \
--input_json examples/multi_example_image.json \
--size infinitetalk-480 \
--sample_steps 40 \
--num_persistent_param_in_dit 0 \
--mode streaming \
--motion_frame 9 \
--save_file infinitetalk_res_multiperson
2. 使用FusioniX或Lightx2v运行(仅需4~8步) python generate_infinitetalk.py \
--ckpt_dir weights/Wan2.1-I2V-14B-480P \
--wav2vec_dir 'weights/chinese-wav2vec2-base' \
--infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
--lora_dir weights/Wan2.1_I2V_14B_FusionX_LoRA.safetensors \
--input_json examples/single_example_image.json \
--lora_scale 1.0 \
--size infinitetalk-480 \
--sample_text_guide_scale 1.0 \
--sample_audio_guide_scale 2.0 \
--sample_steps 8 \
--mode streaming \
--motion_frame 9 \
--sample_shift 2 \
--num_persistent_param_in_dit 0 \
--save_file infinitetalk_res_lora
3. 使用量化模型运行(仅支持单GPU运行) python generate_infinitetalk.py \
--ckpt_dir weights/Wan2.1-I2V-14B-480P \
--wav2vec_dir 'weights/chinese-wav2vec2-base' \
--infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
--input_json examples/single_example_image.json \
--size infinitetalk-480 \
--sample_steps 40 \
--mode streaming \
--quant fp8 \
--quant_dir weights/InfiniteTalk/quant_models/infinitetalk_single_fp8.safetensors \
--motion_frame 9 \
--num_persistent_param_in_dit 0 \
--save_file infinitetalk_res_quant
4. 使用Gradio运行 python app.py \
--ckpt_dir weights/Wan2.1-I2V-14B-480P \
--wav2vec_dir 'weights/chinese-wav2vec2-base' \
--infinitetalk_dir weights/InfiniteTalk/single/infinitetalk.safetensors \
--num_persistent_param_in_dit 0 \
--motion_frame 9
python app.py \
    --ckpt_dir weights/Wan2.1-I2V-14B-480P \
    --wav2vec_dir 'weights/chinese-wav2vec2-base' \
    --infinitetalk_dir weights/InfiniteTalk/multi/infinitetalk.safetensors \
    --num_persistent_param_in_dit 0 \
    --motion_frame 9
📚 引用 @misc{yang2025infinitetalkaudiodrivenvideogeneration,
title={InfiniteTalk: Audio-driven Video Generation for Sparse-Frame Video Dubbing},
author={Shaoshu Yang and Zhe Kong and Feng Gao and Meng Cheng and Xiangyu Liu and Yong Zhang and Zhuoliang Kang and Wenhan Luo and Xunliang Cai and Ran He and Xiaoming Wei},
year={2025},
eprint={2508.14033},
archivePrefix={arXiv},
primaryClass={cs.CV},
url={https://arxiv.org/abs/2508.14033},
}
📜 许可证 本仓库中的模型根据Apache 2.0许可证授权。我们对您生成的内容不主张任何权利,
授予您使用它们的自由,同时确保您的使用符合本许可证的规定。
您对模型的使用负全部责任,不得涉及分享任何违反适用法律、
对个人或群体造成伤害、传播旨在伤害的个人信息、散布错误信息或针对弱势群体的内容。