跳到主要内容
Voicebox · prolist
它能帮你做什么 把视频旁白或播客稿粘贴进去,选一个声音,就能生成配音。也可以提供一小段声音样本,模仿这种音色朗读,再把多段音频剪辑、拼接成完整作品。软件在本地运行,需要先安装并下载语音模型。
查看仓库原始简介 The open-source AI voice studio. Clone, dictate, create.
来自项目 README 项目解读 README
项目解读由 AI 根据历史资料整理,尚未经人工复核。仓库资料更新于 2026-09-08,与历史解读分开保留。
项目概览 Voicebox 是由 Jamie Pine 开发的开源语音合成工作室,定位为 ElevenLabs 的免费本地替代方案。它是一个完整的桌面应用,集声音克隆、语音生成、后处理特效、多轨编辑于一体,所有模型和数据完全在本地运行。项目采用 Tauri (Rust) 桌面框架,前端使用 React + TypeScript,后端为 Python (FastAPI),音效处理由 Spotify pedalboard 驱动。内置 5 个 TTS 引擎,支持 23 种语言,最大文本长度 50,000 字符,并提供完整 REST API 供外部集成。核心能力包括多引擎声音克隆、情感表达控制(如 [laugh]、[sigh] 等副语言学标签)、8 种后处理音效、多轨时间轴编辑(Stories Editor)以及长文本自动分段与交叉淡入淡出拼接。项目采用 MIT 协议完全开源,支持 CUDA、ROCm、MLX、DirectML、XPU 及 CPU 等多种 GPU 后端。
解决什么问题 在 Voicebox 之前,内容创作者面临"三难困境":要么付费订阅商业服务,要么接受低质量的免费方案,要么自己从零搭建复杂的技术栈。商业 SaaS 如 ElevenLabs 按字符计费,长音频成本指数级增长,且存在高峰期排队问题。声音作为敏感生物特征数据,上传云端意味着放弃控制权,企业用户难以满足合规要求。此外,TTS 模型、后处理音效、多角色对话编辑各自独立,技术栈碎片化严重;高质量模型本地部署复杂,普通用户几乎无法完成;多数开源 TTS 表现力不足,缺少情感控制;长文本处理能力差,生成中断后需手动拼接。
工作方式 Voicebox 采用 Tauri (Rust) 桌面框架,前端为 React + TypeScript + Tailwind CSS,状态管理使用 Zustand + React Query,后端为 Python (FastAPI) 提供 TTS 模型推理服务,音效处理由 Spotify pedalboard 驱动,转录使用 Whisper / Whisper Turbo,构建工具为 Bun,支持 Docker 一键部署。声音克隆流程包括音频预处理(自动归一化、降噪、切片)、声纹提取(Speaker Embedding)、条件生成、波形合成(声码器)及可选后处理。长文本处理通过智能分段(尊重缩写词、CJK 标点、情感标签)、并行生成、交叉淡入淡出(0-200ms 可配置)实现无缝拼接。
核心能力
个 TTS 引擎自由切换(Qwen3-TTS、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、TADA)
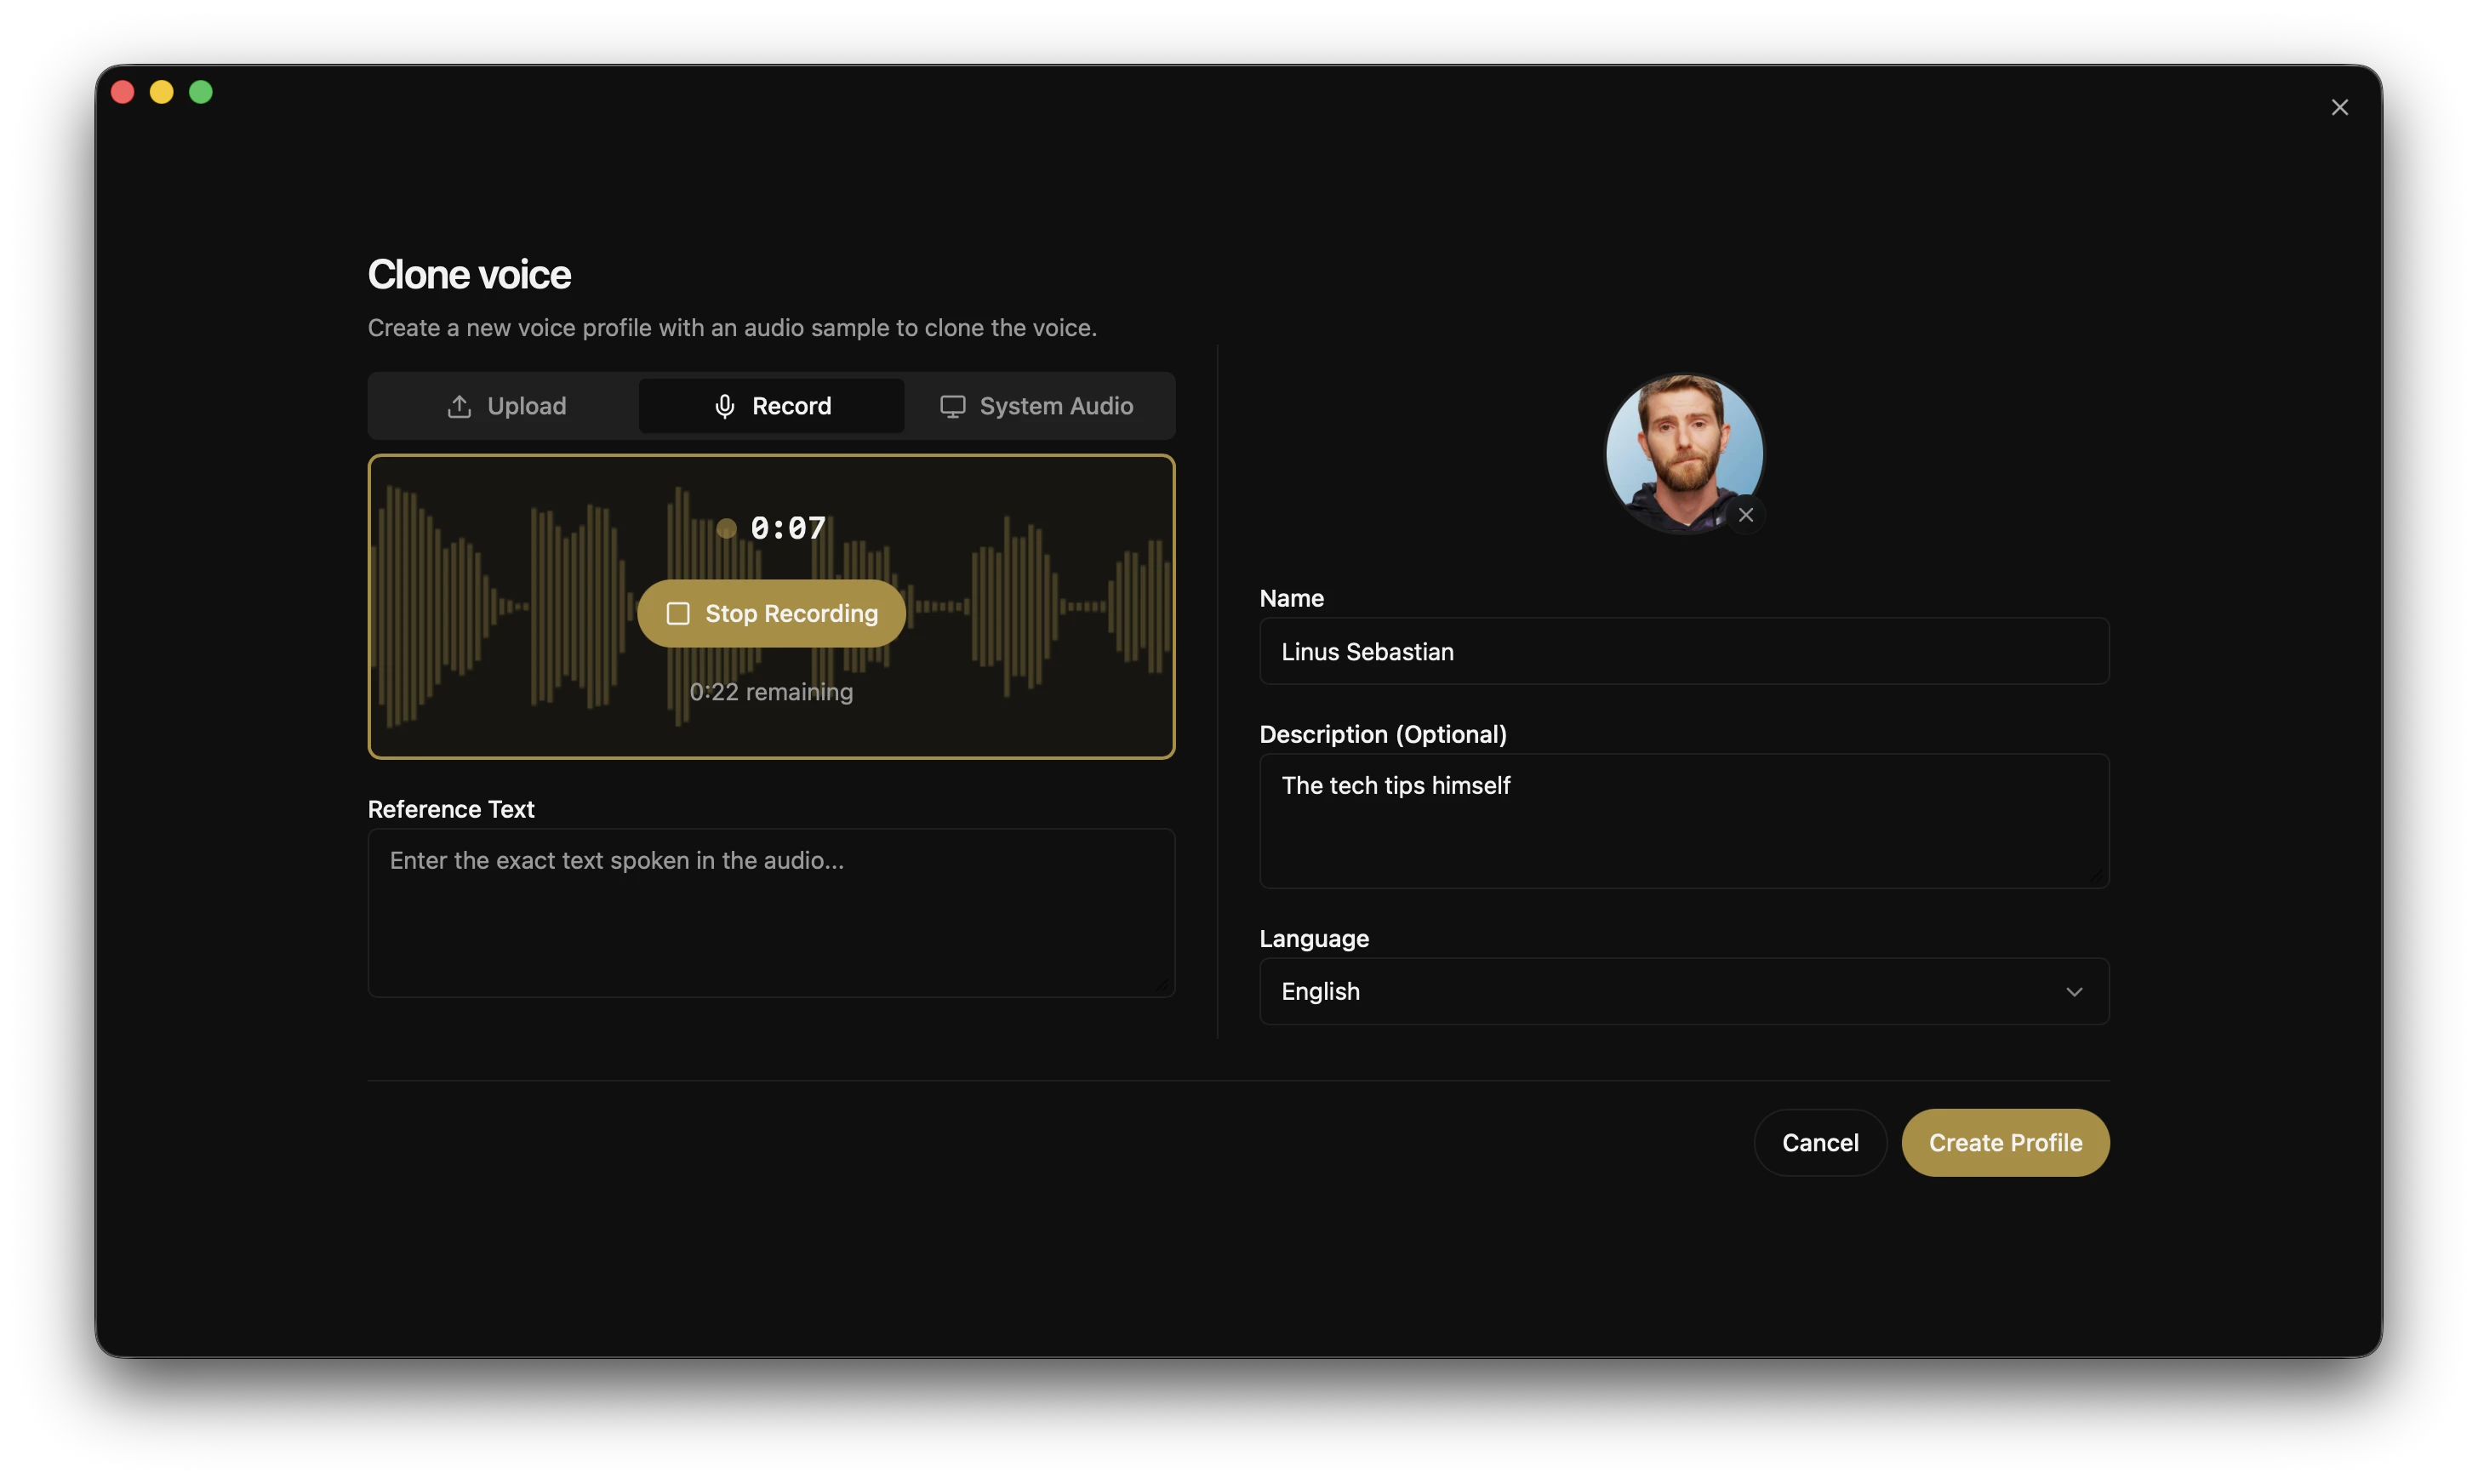
几秒钟音频即可完成声音克隆
副语言学情感标签([laugh]、[sigh]、[gasp] 等)内联合成,非后处理拼接
种后处理音效(变调、混响、延迟、压缩等),由 Spotify pedalboard 驱动
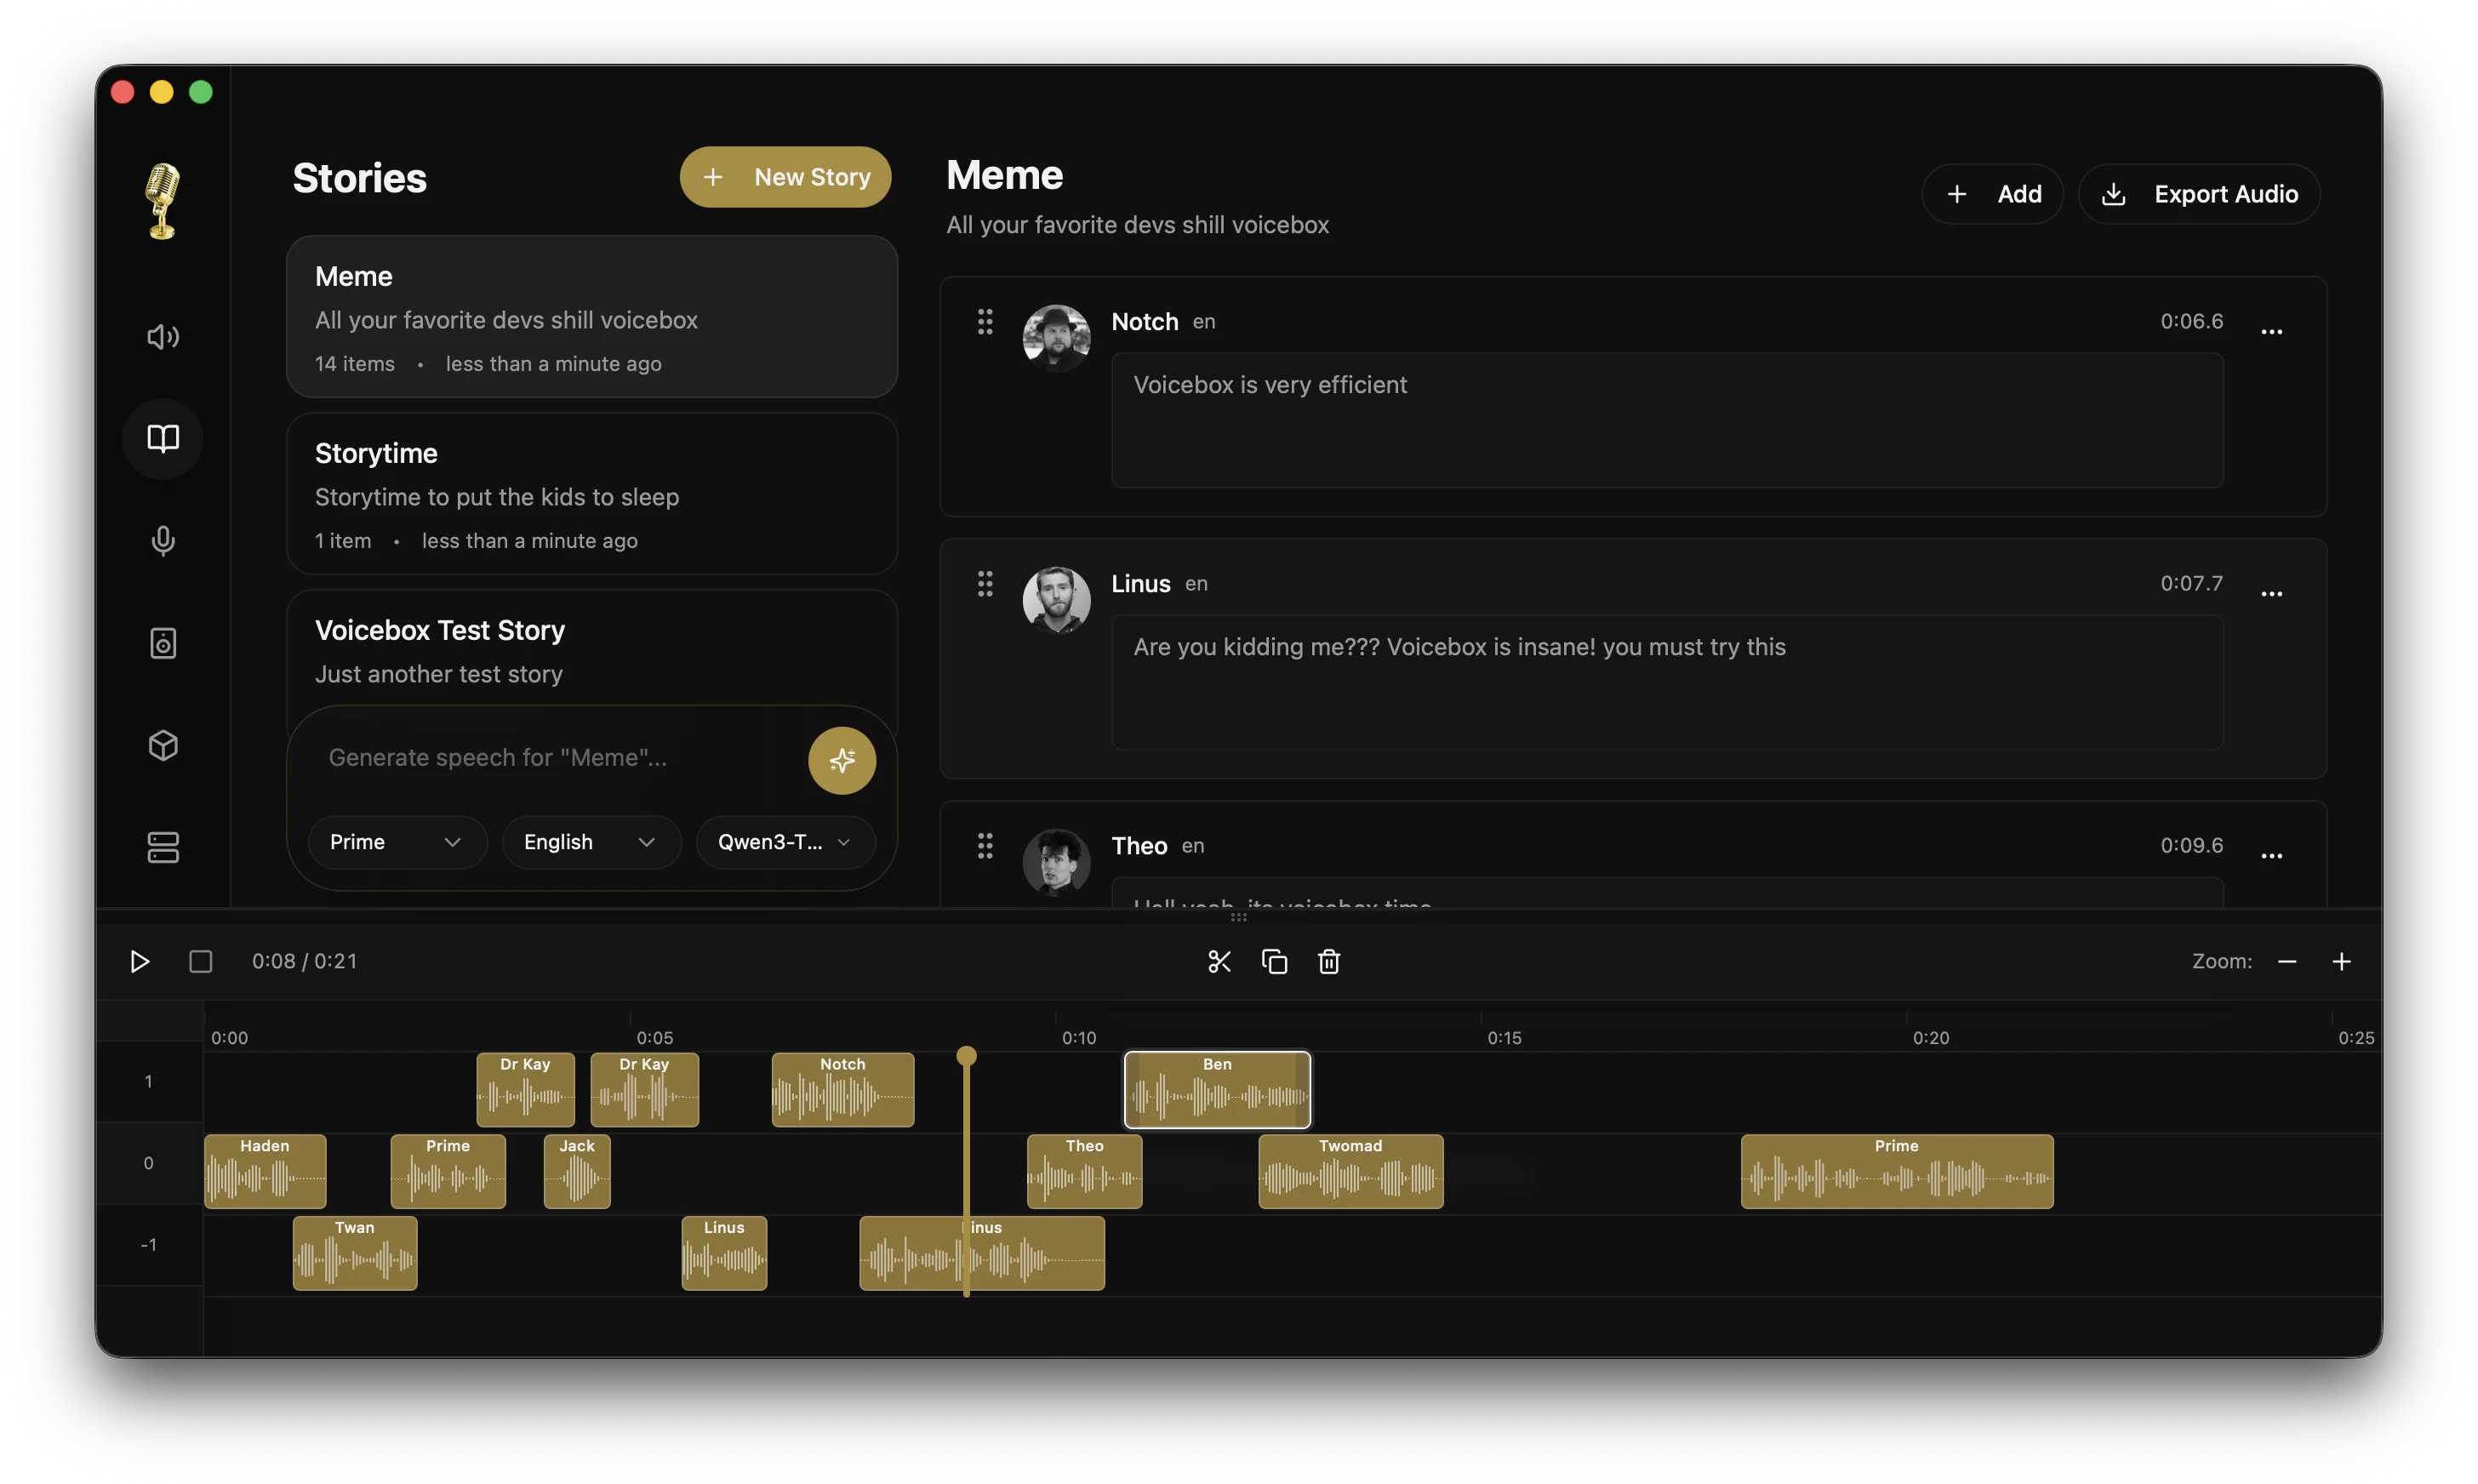
Stories Editor 多轨时间轴编辑,支持多角色对话编排
,000 字符长文本自动分段与交叉淡入淡出拼接
完整 REST API,可集成到游戏、播客、无障碍工具等场景
支持 6 种 GPU 后端(CUDA、ROCm、MLX、DirectML、XPU、CPU)
支持 23 种语言
MIT 协议完全开源,无付费功能
使用前需要了解
AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
根据报告,Voicebox 不适合电信级 TTS(需要毫秒级延迟),不适合需要严格 SLA 的企业生产环境;声音克隆质量仍不如 ElevenLabs 顶级方案;缺少实时流式输出(目前是生成后返回完整文件)。Linux 无预编译版本,需要源码编译,门槛较高;完整安装需要 10-20GB 磁盘空间;最佳体验需要 NVIDIA GPU(8GB+ VRAM);中文支持有限,Qwen3-TTS 支持 10 语言但中文质量待验证;生成延迟 1-5 秒,不适合实时对话场景;项目较新(v0.3.1),API 可能变动。
简体中文 · AI 译文 原文
AI 中文译文,非官方翻译;安装命令与技术细节请对照原文。
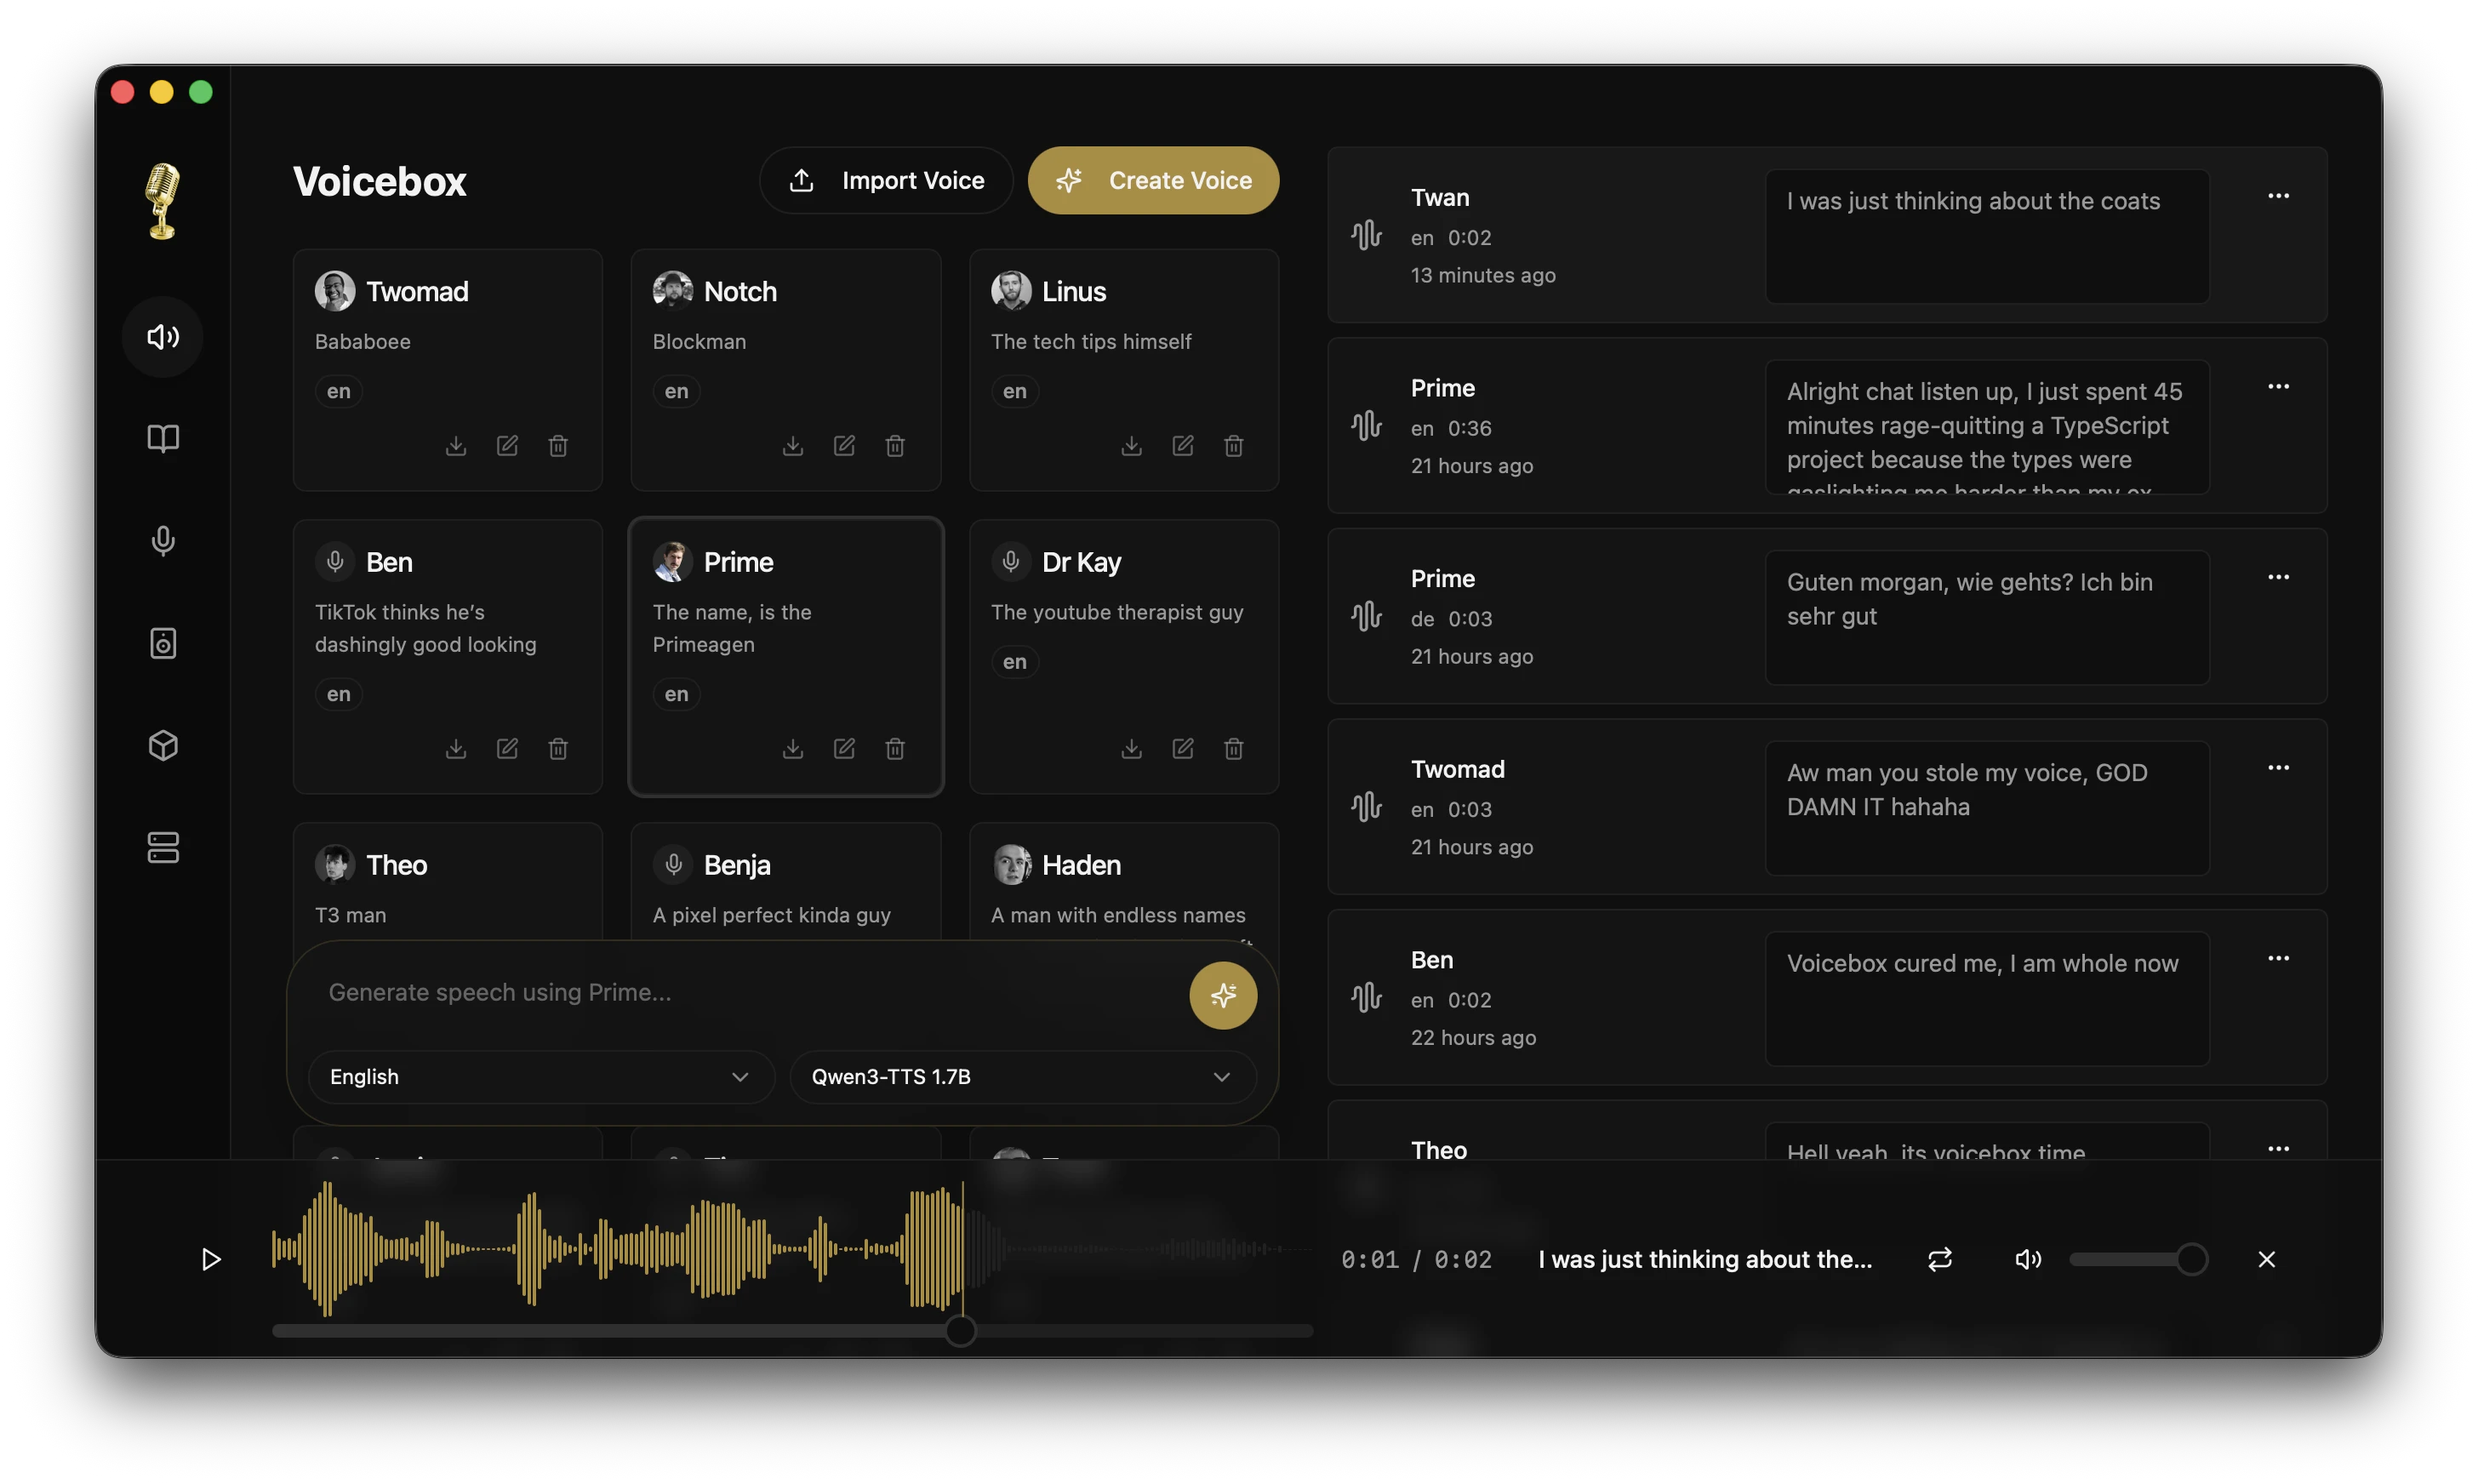
什么是 Voicebox? Voicebox 是一个本地优先的 AI 语音工作室 ——一个免费开源的 ElevenLabs 和 WisprFlow 替代品,集于一个应用。从几秒钟的音频中克隆声音,在 7 个 TTS 引擎中生成 23 种语言的语音,使用全局热键在任何文本字段中听写,并为你选择的任何支持 MCP 的 AI 智能体赋予声音。
两家云服务巨头分别占据语音输入/输出循环的两端——ElevenLabs 负责输出,WisprFlow 负责输入。Voicebox 两者兼顾,通过内置的本地 LLM 进行优化和按配置文件定制角色,并在你的机器上运行整个系统。
完全隐私 ——模型、语音数据和捕获内容永远不会离开你的机器7 个 TTS 引擎 ——Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro语音克隆和预设声音 ——从参考样本进行零样本克隆,或通过 Kokoro 和 Qwen CustomVoice 使用 50 多个精选预设声音23 种语言 ——从英语到阿拉伯语、日语、印地语、斯瓦希里语等后处理效果 ——音高变换、混响、延迟、合唱、压缩和滤波器表现力语音 ——通过 Chatterbox Turbo 支持 [laugh]、[sigh]、[gasp] 等副语言标签;通过 Qwen CustomVoice 支持自然语言交付控制无限长度 ——自动分块并交叉淡化,适用于脚本、文章和章节故事编辑器 ——用于对话、播客和叙事的多轨时间线语音输入 ——全局听写热键,支持按键说话和切换模式,macOS 上经过无障碍验证的自动粘贴,每个文本字段内置麦克风,基于 Whisper 的 STT智能体语音输出 ——一次工具调用(voicebox.speak),任何支持 MCP 的智能体(Claude Code、Cursor、Cline)就能用你克隆的声音与你对话语音个性 ——为任何语音配置文件附加自由形式的角色,然后通过内置的本地 LLM 进行撰写、重写或回复——智能体可以通过 MCP 调用相同模式API 优先 ——REST API 加上内置的 MCP 服务器,用于将语音输入/输出集成到你自己的应用和智能体中原生性能 ——使用 Tauri(Rust)构建,而非 Electron随处运行 ——macOS(MLX/Metal)、Windows(CUDA)、Linux、AMD ROCm、Intel Arc、Docker
下载
遇到问题? 请参阅 故障排除指南 了解常见的安装、生成、模型下载和 GPU 问题。
功能
多引擎语音克隆
情感与副语言标签 只有 Chatterbox Turbo 能解释 [laugh] 和
[sigh] 等副语言标签。Qwen3-TTS、LuxTTS、Chatterbox Multilingual 和 HumeAI TADA 会将其
按字面文本读取。
选择 Chatterbox Turbo 后,在文本输入中键入 / 可打开标签
插入器,并在语音中内联添加表现力标签:
[laugh] [chuckle] [gasp] [cough] [sigh] [groan] [sniff] [shush] [clear throat]
后期处理效果 由 Spotify 的 pedalboard 库提供支持的 8 种音频效果。在生成后应用,实时预览,构建可复用的预设。
附带 4 个内置预设(机器人、收音机、回声室、低沉嗓音),并支持自定义预设。效果可按配置文件分配为默认设置。
无限生成长度 文本会在句子边界自动拆分,每个块独立生成,然后交叉淡化拼接在一起。适用于所有引擎。
可配置的自动分块限制(100–5,000 字符)
交叉淡化滑块(0–200ms),实现平滑过渡
最大文本长度:50,000 字符
智能拆分尊重缩写、中日韩标点符号和 [tags]
生成版本
原始 — 干净的 TTS 输出,始终保留效果版本 — 从任何源版本应用不同的效果链录制片段 — 使用新种子重新生成以产生变化来源追踪 — 每个版本都记录其谱系收藏 — 为生成结果加星标以便快速访问
异步生成队列
串行执行队列防止 GPU 争用
实时 SSE 状态流
失败的生成可以重试
崩溃导致的过期生成在启动时自动恢复
语音配置文件管理
从音频文件创建配置文件,或在应用内直接录制
导入/导出配置文件以共享或备份
多样本支持,实现更高质量的克隆
每个配置文件的默认效果链
使用描述和语言标签进行组织
故事编辑器
支持拖放的多轨合成
内联音频修剪和分割
带同步播放头的自动播放
每个轨道片段的版本固定
全局听写与语音输入 语音输入/输出循环的另一半。在系统任意位置按住热键,说话,松开 — 在 macOS 上,转录文本会直接粘贴到聚焦的文本字段中。或者点击任意 Voicebox 文本输入上的麦克风,直接在应用内听写。
可配置和弦绑定 — 按住说话和点按切换和弦,每个都可在应用内的和弦选择器中重新绑定。按住通话时,在按住期间点按 Space 会无缝升级为切换会话,音频无中断目标感知粘贴(macOS) — 通过辅助功能验证注入到聚焦的文本字段,并带有原子剪贴板保存/恢复,确保剪贴板不被覆盖首次运行权限体验 — 应用内引导带您完成 macOS 辅助功能和输入监控授权,并提供系统设置的深层链接每个 Voicebox 文本字段上的应用内麦克风按钮 — 生成表单、配置文件描述、故事标题,任何您会输入的地方LLM 优化 — 粘贴前可选清理语气词、口吃和错误开头屏幕药丸 — 浮动覆盖层,显示 recording、transcribing、refining 和 speaking 状态。与代理对您说话时使用的药丸相同,因此循环的两个方向共享一个心智模型
语音转文本 Voicebox 运行 OpenAI Whisper 进行转录 — 与支持听写、Captures 标签页和 /transcribe API 的模型相同。根据您的平台,在 MLX(Apple Silicon)或 PyTorch(CUDA / ROCm / DirectML / CPU)上运行。
更多引擎(Parakeet v3、Qwen3-ASR)正在规划中 — 请参阅 路线图 。
Captures 每次听写、应用内录音和上传的音频文件都会进入 Captures 标签页 — 原始音频与转录文本配对,始终保留。
重播、重新转录、优化 — 使用任意 Whisper 大小重新运行 STT,或使用不同标志(填充词清理、自我纠正移除、技术术语保留)通过本地 LLM 重新处理原始转录内联编辑 — 调整转录文本并在失焦时保存作为语音配置文件播放 — 一键将任何捕获内容转换为克隆语音的语音提升为语音样本 — 使用捕获内容的音频 + 转录文本作为任何语音配置文件的参考样本本地捕获存储 — 原始音频和转录文本保留在您的 Voicebox 数据目录中,设置中提供文件夹快捷方式
代理语音输出 每个代理都有语音。一次工具调用,任何支持 MCP 的代理都可以用您克隆的语音与您对话 — 任务完成、提问、通知。听写期间显示的药丸在代理说话时也会显示,因此您始终能看到机器正在输出的内容。
// In any MCP-aware agent:
await voicebox.speak({
  text: "Deploy complete.",
  profile: "Morgan",
});
也作为 POST /speak 暴露,适用于不支持 MCP 的任何内容 — ACP、A2A、Shell 脚本、自定义框架。
双向药丸 — recording、transcribing、refining 和 speaking 都是同一操作系统级覆盖层的状态,因此听写和代理语音共享一个界面每个代理的语音绑定 — 在 设置 → MCP 中,将 Claude Code 固定到 Morgan,将 Cursor 固定到 Scarlett,这样无需查看即可分辨是哪个代理在说话。每个客户端的 last_seen_at 时间戳确认安装确实生效始终可见 — 无静默后台 TTS;每次代理发起的语音都会在完整持续时间内显示带有语音配置文件名称的药丸HTTP + stdio 传输 — 在 Claude Code / Cursor / Windsurf / VS Code MCP 中作为 URL 安装,或将仅支持 stdio 的客户端指向捆绑的 voicebox-mcp 二进制文件
语音个性 为任何语音配置文件附加一个自由形式的个性——这个声音是谁、他们如何说话、他们关心什么。当设置了个性后,生成框上会出现两个操作,由内置的 Qwen3 LLM 驱动,完全在本地运行。
撰写 — 一个随机按钮,将一句符合角色设定的话放入文本框;编辑并朗读,或再次点击以获取不同的内容角色化朗读 — 一个开关,将您的输入文本通过个性 LLM 路由,在 TTS 之前以该角色的口吻重写 代理可以通过 MCP 传递 personality: true 到 voicebox.speak 来使用相同的重写路径,将该工具转变为 文本输入 → 个性 LLM → TTS 的流水线。同一个 LLM 也支持听写的润色步骤——应用内一个 LLM,一个模型缓存,一个 GPU 内存占用。
本地 LLM 选项: Qwen3 0.6B / 1.7B / 4B,与 TTS 运行时共享(Apple Silicon 上为 MLX,其他平台为 PyTorch)。
使用场景:代理开发循环(口述问题,用克隆的声音听到答案)、游戏和叙事工具的交互式角色、为无法用原声说话的人提供语音辅助。
模型管理
按模型卸载以释放 GPU 内存,无需删除下载
通过 VOICEBOX_MODELS_DIR 自定义模型目录
带进度跟踪的模型文件夹迁移
下载取消/清除界面
GPU 支持
API Voicebox 提供了一个 REST API,用于将语音输入/输出集成到您自己的应用和代理中。
# Generate speech
curl -X POST http://127.0.0.1:17493/generate \
  -H "Content-Type: application/json" \
  -d '{"text": "Hello world", "profile_id": "abc123", "language": "en"}'

# Agent voice output — any app or script can speak in a cloned voice
curl -X POST http://127.0.0.1:17493/speak \
  -H "Content-Type: application/json" \
  -H "X-Voicebox-Client-Id: my-script" \
  -d '{"text": "Deploy complete.", "profile": "Morgan"}'

# Transcribe an audio file
curl -X POST http://127.0.0.1:17493/transcribe \
  -F "audio=@recording.wav" \
  -F "model=whisper-turbo"

# List voice profiles
curl http://127.0.0.1:17493/profiles
POST /speak 接受 profile 作为名称(不区分大小写)或 ID,并遵循与 MCP 工具相同的优先级进行解析:显式参数 → 每客户端绑定 → capture_settings.default_playback_voice_id。
MCP 服务器 Voicebox 内置了一个 模型上下文协议 服务器,因此任何支持 MCP 的代理(Claude Code、Cursor、Windsurf、Cline、VS Code MCP 扩展)都可以进行语音合成、转录以及浏览录音和配置文件。
claude mcp add voicebox \
  --transport http \
  --url http://127.0.0.1:17493/mcp \
  --header "X-Voicebox-Client-Id: claude-code"
任何 HTTP MCP 客户端 (Cursor、Windsurf、VS Code 等):
{
  "mcpServers": {
    "voicebox": {
      "url": "http://127.0.0.1:17493/mcp",
      "headers": { "X-Voicebox-Client-Id": "cursor" }
    }
  }
}
Stdio 回退 适用于不支持 HTTP MCP 的客户端——指向应用内捆绑的 voicebox-mcp 二进制文件:
{
  "mcpServers": {
    "voicebox": {
      "command": "/Applications/Voicebox.app/Contents/MacOS/voicebox-mcp",
      "env": { "VOICEBOX_CLIENT_ID": "claude-desktop" }
    }
  }
}
内置四个工具:voicebox.speak、voicebox.transcribe、voicebox.list_captures、voicebox.list_profiles。每客户端的语音绑定在 Voicebox → 设置 → MCP 中管理。有关工具签名、解析优先级、说话胶囊约定和安全说明,请参阅 完整 MCP 指南 。
// In any MCP-aware agent:
await voicebox.speak({
  text: "Tests passing. Ready to merge.",
  profile: "Morgan",      // optional — falls back to the per-client binding
  personality: true,      // optional — rewrites text through the profile's personality LLM first
});
使用场景: 代理开发循环(语音输入,语音输出)、游戏对话、播客制作、无障碍工具、语音助手、内容自动化。
完整 API 文档可在 http://127.0.0.1:17493/docs 获取。
技术栈
路线图
开发
快速开始 git clone https://github.com/jamiepine/voicebox.git
cd voicebox
just setup # creates Python venv, installs all deps
just dev # starts backend + desktop app
安装 just :brew install just 或 cargo install just。运行 just --list 查看所有命令。
仓库在根目录预置了 .mcp.json —— 在此检出目录中运行 Claude Code 时,一旦开发应用运行,会自动加载 Voicebox MCP 工具。
本地构建 just build # Build CPU server binary + Tauri app
just build-local # (Windows) Build CPU + CUDA server binaries + Tauri app
添加新语音模型 多引擎架构使得添加新的 TTS 引擎变得简单直接。一份分步指南 涵盖了完整流程:依赖调研、后端协议实现、前端接线以及 PyInstaller 打包。
该指南针对 AI 编码代理进行了优化。一个代理技能 可以接收模型名称并自主处理整个集成过程——你只需在本地测试构建即可。
项目结构 voicebox/
├── app/ # Shared React frontend
├── tauri/ # Desktop app (Tauri + Rust)
├── web/ # Web deployment
├── backend/ # Python FastAPI server
├── landing/ # Marketing website
└── scripts/ # Build & release scripts
贡献
Fork 仓库
创建功能分支
进行修改
提交 Pull Request
安全
许可证