跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签115开源34AI Agent33Python23提示词工程13Claude Code13TypeScript12LLM11Markdown10MIT10React9知识管理8声音克隆4

项目搜索结果

找到 4 个项目 · 标签:声音克隆 移除标签

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

Voicebox README 配图
内容创作GitHub 项目

Voicebox

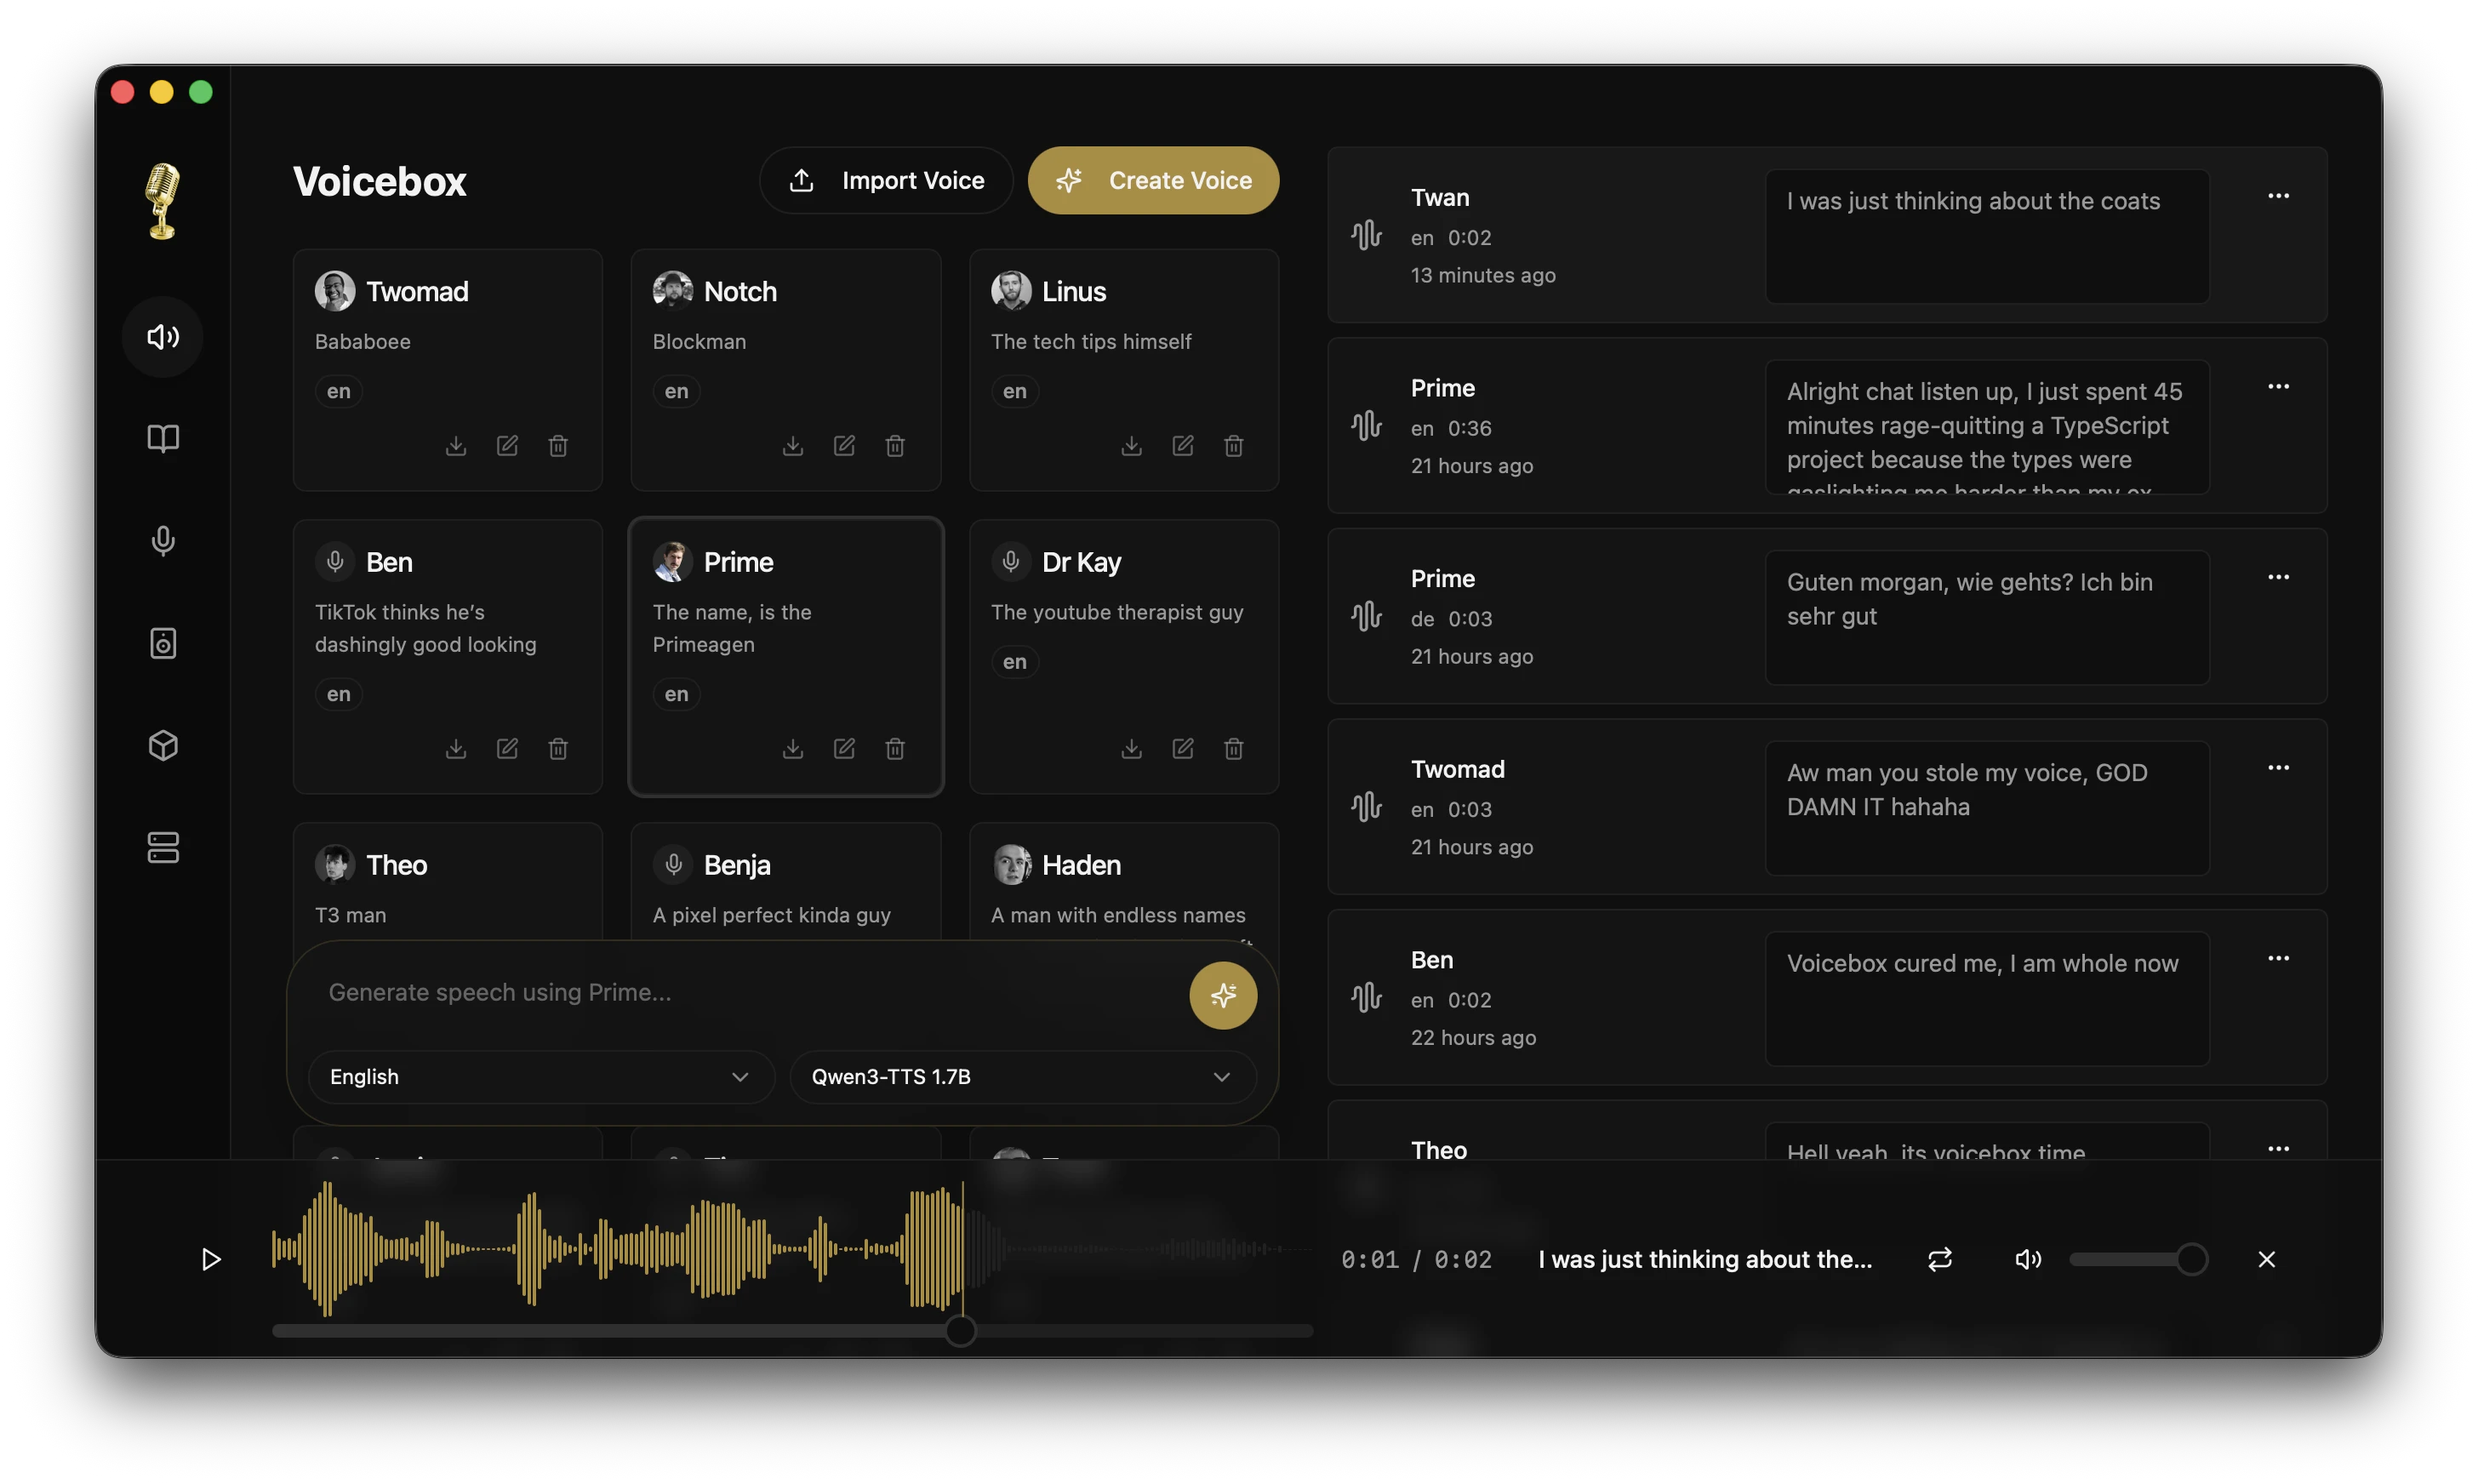
本地优先的开源语音合成工作站,集成多引擎声音克隆、情感标签、后处理音效与多轨编辑

Voicebox 是由 Jamie Pine 开发的开源语音合成工作室,定位为 ElevenLabs 的免费本地替代方案。它是一个完整的桌面应用,集声音克隆、语音生成、后处理特效、多轨编辑于一体,所有模型和数据完全在本地运行。项目采用 Tauri (Rust) 桌面框架,前端使用 React + TypeScript,后端为 Python (FastAPI),音效处理由 Spotify pedalboard 驱动。内置 5 个 TTS 引擎,支持 23 种语言,最大文本长度 50,000 字符,并提供完整 REST API 供外部集成。核心能力包括多引擎声音克隆、情感表达控制(如 [laugh]、[sigh] 等副语言学标签)、8 种后处理音效、多轨时间轴编辑(Stories Editor)以及长文本自动分段与交叉淡入淡出拼接。项目采用 MIT 协议完全开源,支持 CUDA、ROCm、MLX、DirectML、XPU 及 CPU 等多种 GPU 后端。

本地优先声音克隆FastAPI
09.08
Voice-Pro README 配图
内容创作GitHub 项目

Voice-Pro

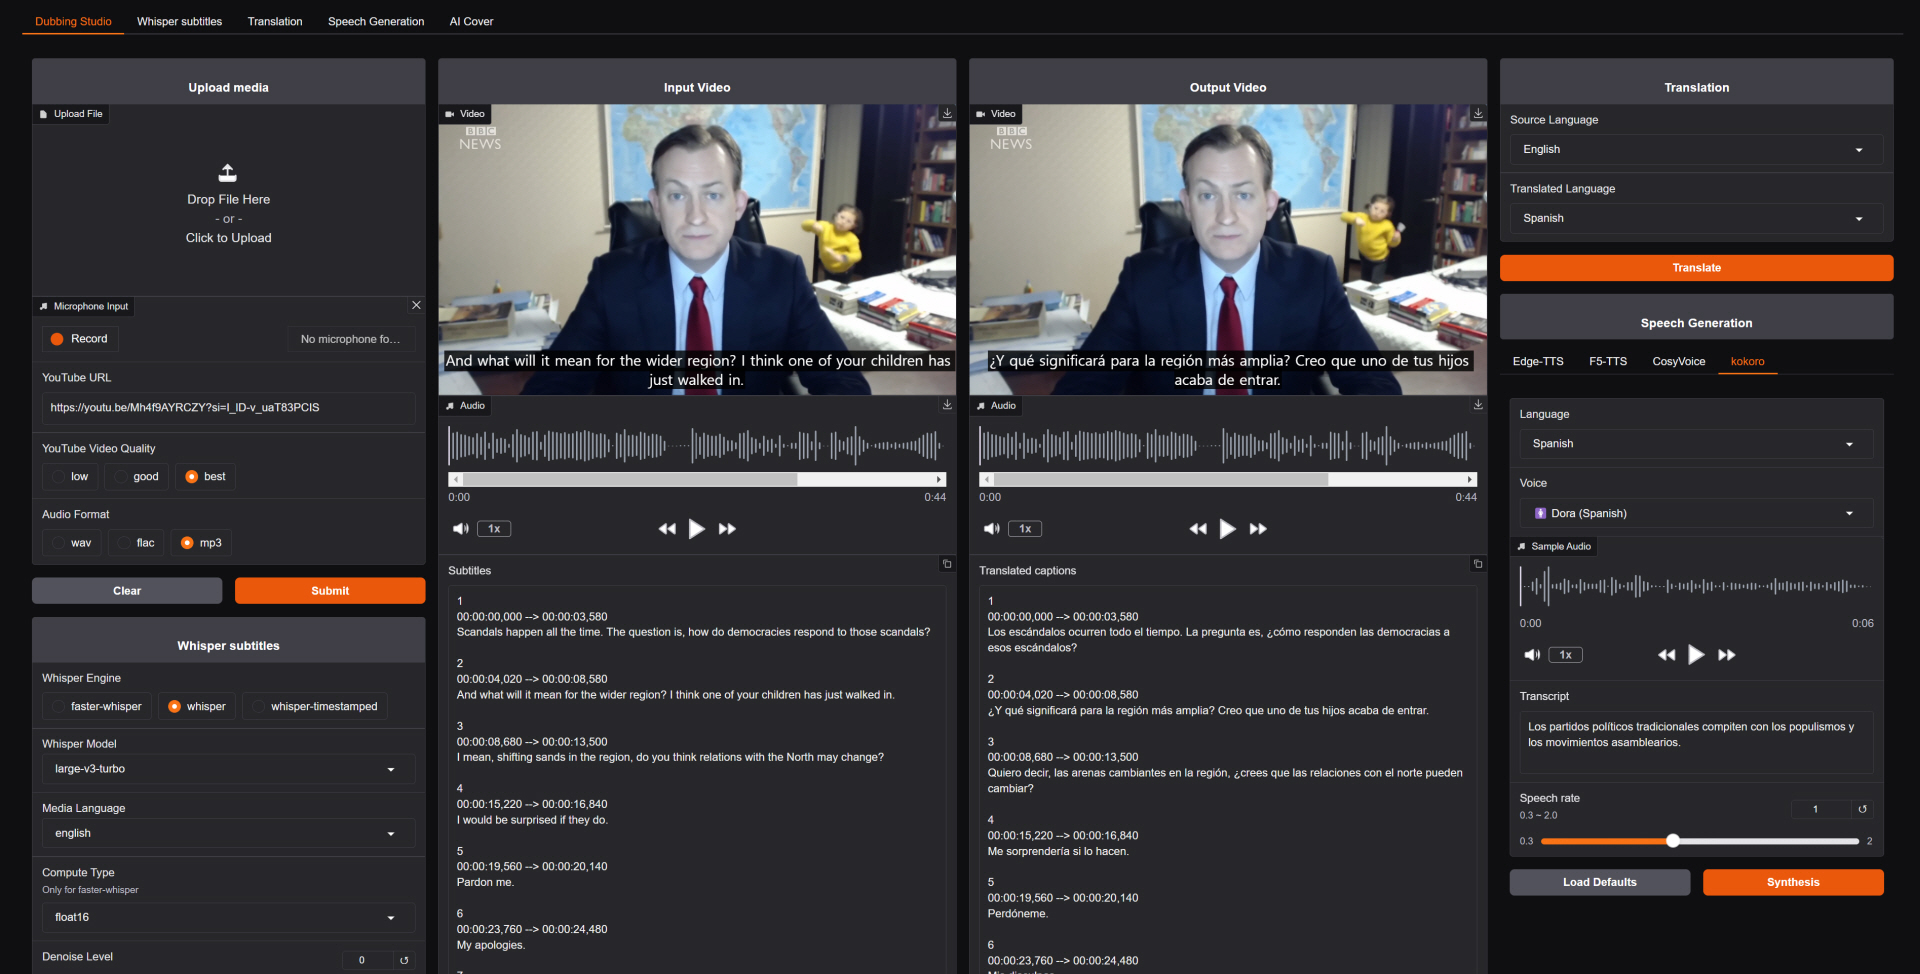
一站式 AI 语音工作台,从视频下载到多语言配音全流程自动化

Voice-Pro 是一款面向创作者和开发者的 AI 音频全流程处理工具,由韩国创业公司 ABUS 开发,基于 Gradio WebUI 构建。它将视频下载、音频分离、语音识别、多语言翻译、文本转语音(TTS)和零样本声音克隆集成到一个统一的 Web 界面中,定位为 ElevenLabs 的开源替代方案。核心价值在于将传统需要 5-8 个工具配合的流程(下载、分离、识别、翻译、配音、字幕)串联成一条自动化管道,用户只需输入视频链接,即可获得多语言配音视频和字幕。工具支持四种 Whisper 变体用于语音识别,三种零样本声音克隆引擎(F5-TTS、E2-TTS、CosyVoice),以及 Edge-TTS、kokoro 等多语言 TTS。完全开源免费,本地运行,数据不出机器。需要 NVIDIA GPU(最低 4GB 显存,推荐 8GB+),首次部署需下载模型,耗时较长。

开源声音克隆视频配音
09.08
CosyVoice README 配图
内容创作GitHub 项目

CosyVoice

多语种语音生成模型,支持3秒声音克隆与流式合成

CosyVoice 是阿里巴巴达摩院 FunAudioLLM 团队开发的多语种大语音生成模型,提供推理、训练和部署的全栈能力。其核心能力包括仅需 3 秒参考音频即可实现零样本声音克隆,覆盖 9 种常见语言和 18 种以上中文方言,并支持跨语种克隆。模型采用 LLM 生成语义 Token 与 Flow Matching 渲染声波的双阶段架构,CosyVoice 2.0 起支持双向流式合成,延迟低至 150ms。CosyVoice 3.0 引入多任务 Tokenizer 和可微分奖励模型后训练,训练数据扩展至 100 万小时。项目采用 Apache-2.0 许可证,支持本地部署,提供 Docker、FastAPI、gRPC、vLLM、TensorRT-LLM 等多种部署方式。

多语种流式合成深度学习
09.08
其他项目主题配图

Supertonic vs MOSS-TTS-Nano 开源轻量级 TTS 深度对比

对比两款开源轻量级 TTS:Supertonic 跨平台部署,MOSS-TTS-Nano 零样本声音克隆

本文档对比两款开源轻量级 TTS 系统:Supertonic 与 MOSS-TTS-Nano。Supertonic 由 Supertone Inc. 开发,基于 ONNX Runtime 完全本地运行,约 99M 参数,支持 31 种语言,提供 11 种语言 SDK,采用 Flow Matching 与语音自编码器架构,代码 MIT 许可,模型 OpenRAIL-M。MOSS-TTS-Nano 由 MOSI.AI 和复旦大学 OpenMOSS 团队开发,仅 0.1B 参数,基于 Audio Tokenizer + LLM 纯自回归架构,支持实时流式推理,可在 4 核 CPU 上运行,支持零样本声音克隆,输出 48kHz 立体声,Apache-2.0 许可。两者均解决传统 TTS 的部署、质量、工程与生态痛点,但侧重点不同:Supertonic 适合跨平台部署与极低资源设备,MOSS-TTS-Nano 适合声音克隆与中文 TTS。文档还包含架构原理、系统架构、关键流程、应用场景、优缺点与选型建议。

端侧推理声音克隆语音合成
09.08