跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签8RAG6知识管理4LLM4开源3Markdown3MIT2Obsidian2React2TypeScript2表格抽取1个人知识管理1公式提取1

项目搜索结果

找到 8 个项目

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

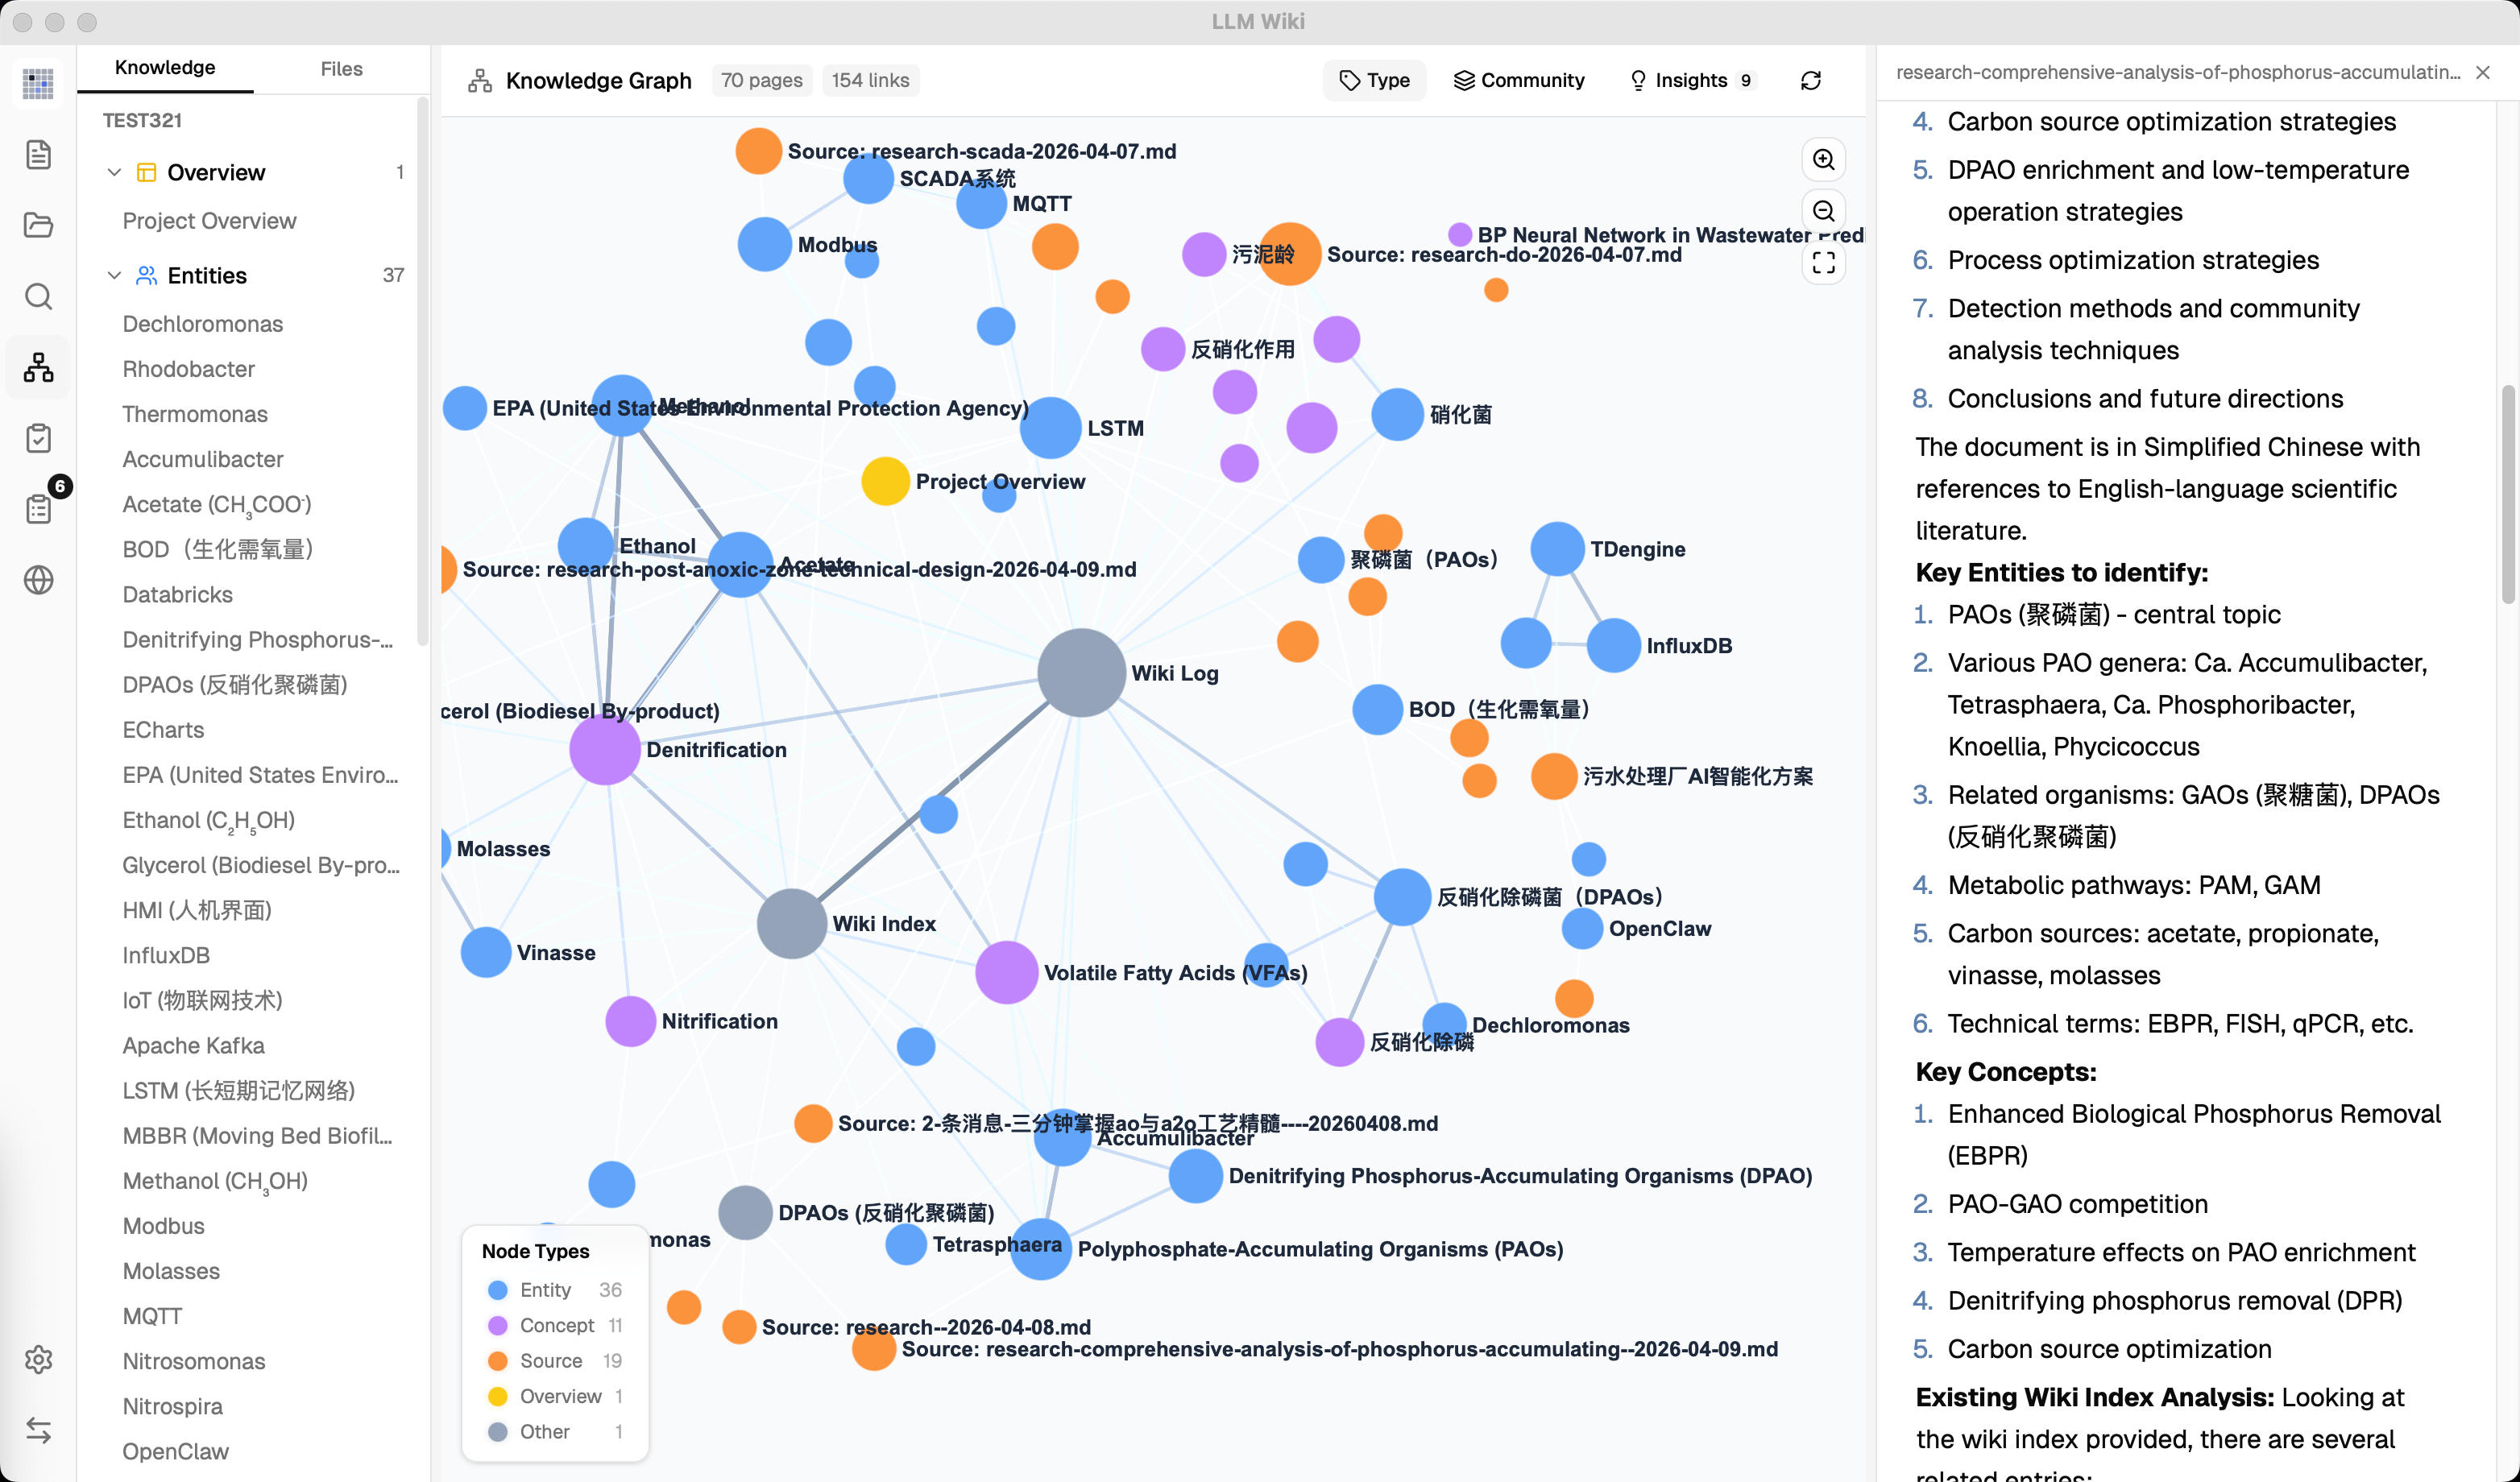
LLM Wiki Desktop (nashsu/llm_wiki) README 配图
知识管理GitHub 项目

LLM Wiki Desktop (nashsu/llm_wiki)

一款将文档编译为结构化、互相关联知识库的跨平台桌面应用

LLM Wiki 是一款跨平台桌面应用,由开发者 nashsu(Yong Su)基于 Andrej Karpathy 提出的 LLM Wiki 模式构建,将抽象设计模式转化为功能完整的桌面软件,能够自动将文档转化为结构化、互相关联的知识库。其核心定位是编译式知识管理,区别于传统 RAG 的检索式模式。应用采用三层架构(Schema 层、Wiki 层、Raw 层),支持 Ingest、Query、Lint 三大核心操作。其关键创新是 Two-Step Chain-of-Thought Ingest,将单步摄取拆分为分析和生成两步,以提升页面质量。知识图谱采用四信号模型(直接链接、来源重叠、共同邻居、类型亲和)并结合 Louvain 社区检测。查询采用多阶段检索管线,包含分词搜索、可选向量搜索、图谱扩展和预算控制。应用支持多格式文档导入、Chrome 扩展 Web Clip、Deep Research 等功能,数据完全本地化,Wiki 目录兼容 Obsidian。

知识管理知识图谱桌面应用
09.08
知识管理主题配图

llm-knowledge-bases

以 LLM 为知识编译器的个人知识库构建方法

本条目整理自一份关于 Andrej Karpathy 个人知识库构建方法的技术拆解报告。报告指出,Karpathy 于 2026 年 4 月公开分享了一套基于 LLM 的知识库构建方法,其核心是从“操作代码”转向“操作知识”,将 LLM 视为知识库的核心引擎。系统采用五层架构:数据摄取层将网页、论文、代码等原始数据统一收集到 raw/ 目录;知识编译层由 LLM 将原始数据“编译”为结构化的 Markdown Wiki,包括摘要、概念文章、反向链接和索引文件;查看与浏览层使用 Obsidian 作为前端;问答层通过 LLM Agent 检索知识库并生成结构化回答;维护层通过 LLM 健康检查确保知识库一致性。报告强调,在约 40 万词的规模下,LLM 可以自动维护索引,无需传统 RAG 组件。每次查询的结果会回写知识库,实现增量增强。

个人知识管理知识管理知识库
09.08
microsoft 的 GitHub 头像microsoft/markitdown
开发工具GitHub 项目

MarkItDown

微软开源的轻量级多格式文档转 Markdown 工具,为 LLM 与 RAG 管道提供结构化文本提取。

MarkItDown 是微软 AutoGen 团队开发并维护的开源 Python 工具,采用 MIT 协议,当前 GitHub 星标超过 105k,最新版本为 v0.1.5(2026 年 2 月发布)。它支持 PDF、Word、PowerPoint、Excel、图片、音频、HTML、EPUB 等 15 种以上文件格式,将其转换为结构化的 Markdown 文本。其核心设计目标是让 LLM 和文本分析工具能以最高效的方式“阅读”非文本文件,输出为机器可消费的结构化文本,而非人类可读的高保真转换。工具采用可插拔的 Converter 架构,每种格式对应独立转换器,核心库仅依赖 Python 标准库,其他功能通过可选依赖按需安装。v0.1.0 之后支持流式处理,不创建临时文件。基础转换不依赖 LLM,但可选用 LLM 增强图片描述与 OCR 功能。此外,项目提供 MCP 服务器,便于 AI 客户端直接调用。

开源文档转换LLM
09.08
知识管理主题配图

知识检索技术全景对比

从传统RAG到LLM Wiki,一文看懂五大知识检索技术流派

本文档是一份关于知识检索技术的深度对比指南,系统梳理了当前领域的五大技术流派:传统RAG、PageIndex、SirChmunk、MinerU和LLM Wiki。文档从技术概述、问题背景、核心思想、核心原理、系统架构、关键流程、技术关系、应用场景、工程落地、优缺点与适用边界等多个维度进行了全面分析。文档指出,传统RAG存在语义碎片化、静态索引僵化、近似匹配不等于真正相关、文档解析能力弱、知识不累积等五大结构性缺陷。针对这些痛点,PageIndex通过构建文档语义树实现推理式树搜索,SirChmunk采用无索引实时扫描与自进化缓存,MinerU作为文档解析上游基础设施提供高质量输入,LLM Wiki则通过编译式知识管理实现知识累积复利。文档强调,未来知识检索一定是混合方案,根据查询类型自动选择检索策略,没有银弹。

文档解析知识管理知识检索
09.08
opendataloader-pdf README 配图
数据与分析GitHub 项目

opendataloader-pdf

开源 PDF 解析与无障碍标注引擎,本地优先、AI 增强

OpenDataLoader PDF 是由韩国 Hancom 开发的 PDF 解析引擎,能将 PDF 转换为 AI 可消费的结构化数据(Markdown、JSON、HTML),同时是全球首个开源端到端 PDF 无障碍自动标注工具。它采用“本地确定性解析为主,AI 混合增强为辅”的核心思想:简单页面由本地 Java 引擎快速处理,复杂页面(如无边框表格、扫描件、公式、图表)路由到自托管的 AI 后端增强,全程数据不出机器。引擎提供阅读顺序识别(XY-Cut++)、边界框坐标、表格抽取、OCR(80+ 语言)、公式提取(LaTeX)、图表描述等功能,并内置 AI 安全过滤机制。项目采用 Apache-2.0 许可证,提供 Python、Node.js、Java SDK 及 CLI,支持 LangChain 集成。报告指出其基准测试成绩为开源第一(Hybrid 模式总分 0.907),但基准由 Hancom 内部测试,缺乏第三方独立验证。

表格抽取公式提取无障碍标注
09.08
知识管理主题配图

LLM Wiki — 用 LLM 构建持久化个人知识库

让 LLM 成为知识库的编译器和维护者,实现知识的持续积累与复利增长

LLM Wiki 是 Karpathy 于 2026 年 4 月提出的一种用 LLM 构建和维护个人知识库的方法论。其核心主张是不再把 LLM 当作临时问答工具,而是让它成为知识库的编译器和维护者,像程序员维护代码库一样,持续读取源材料、写入 Wiki 页面、更新交叉引用、标记矛盾。该方法论横跨个人知识管理、LLM 应用范式和知识编译三个领域,旨在解决传统 RAG 模式没有知识积累、无法发现矛盾、无法跨文档综合、查询结果无法沉淀以及人类维护负担过重等痛点。其核心思想是让 LLM 成为知识库的编译器和维护者,而非临时检索引擎。底层基于三层架构:Raw Sources(原始源材料)、The Wiki(知识库)和 The Schema(配置规范),并通过 Ingest(摄入)、Query(查询)、Lint(健康检查)三个核心操作实现知识的增量编译和持续维护。该方法论适合长期深度研究、个人知识管理等场景,但存在 Token 消耗高、冷启动成本高、幻觉风险等局限。

知识编译知识管理Git
09.08
Magic Resume README 配图
内容创作GitHub 项目

Magic Resume

开源在线 AI 简历编辑器,所见即所得,数据本地存储

Magic Resume 是一款开源的在线 AI 简历编辑器,由开发者 Siyue 创建并维护。它提供所见即所得的编辑体验,左侧编辑内容,右侧实时预览最终效果。所有简历数据存储在浏览器 localStorage,不上传服务器,从根本上解决隐私问题。内置 AI 辅助写作,支持 Gemini、DeepSeek、豆包等多个大模型,可进行内容润色、语法检查和简历导入。基于 TanStack Start、Tiptap v3、Zustand 等现代技术栈构建,支持多套模板和深色模式。PDF 导出时自动调整字号和间距,确保简历恰好一页。采用 Apache 2.0 开源协议,个人使用免费,商业使用需单独授权。支持 Docker 一键部署,无需数据库和后端。

简历编辑器开源AI辅助
09.08
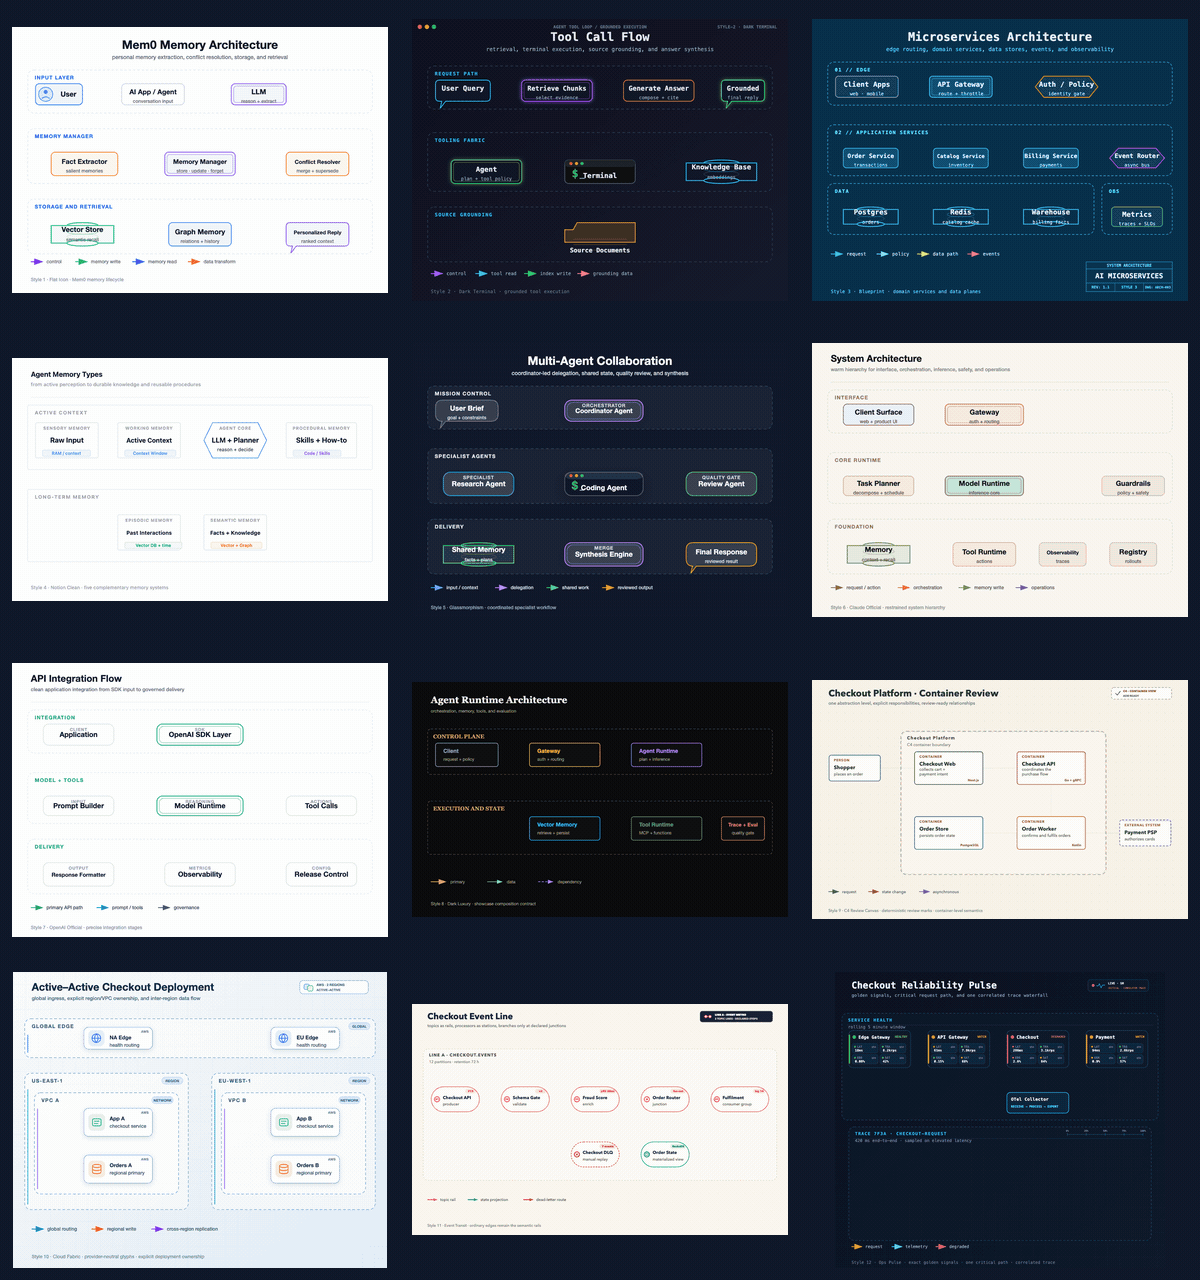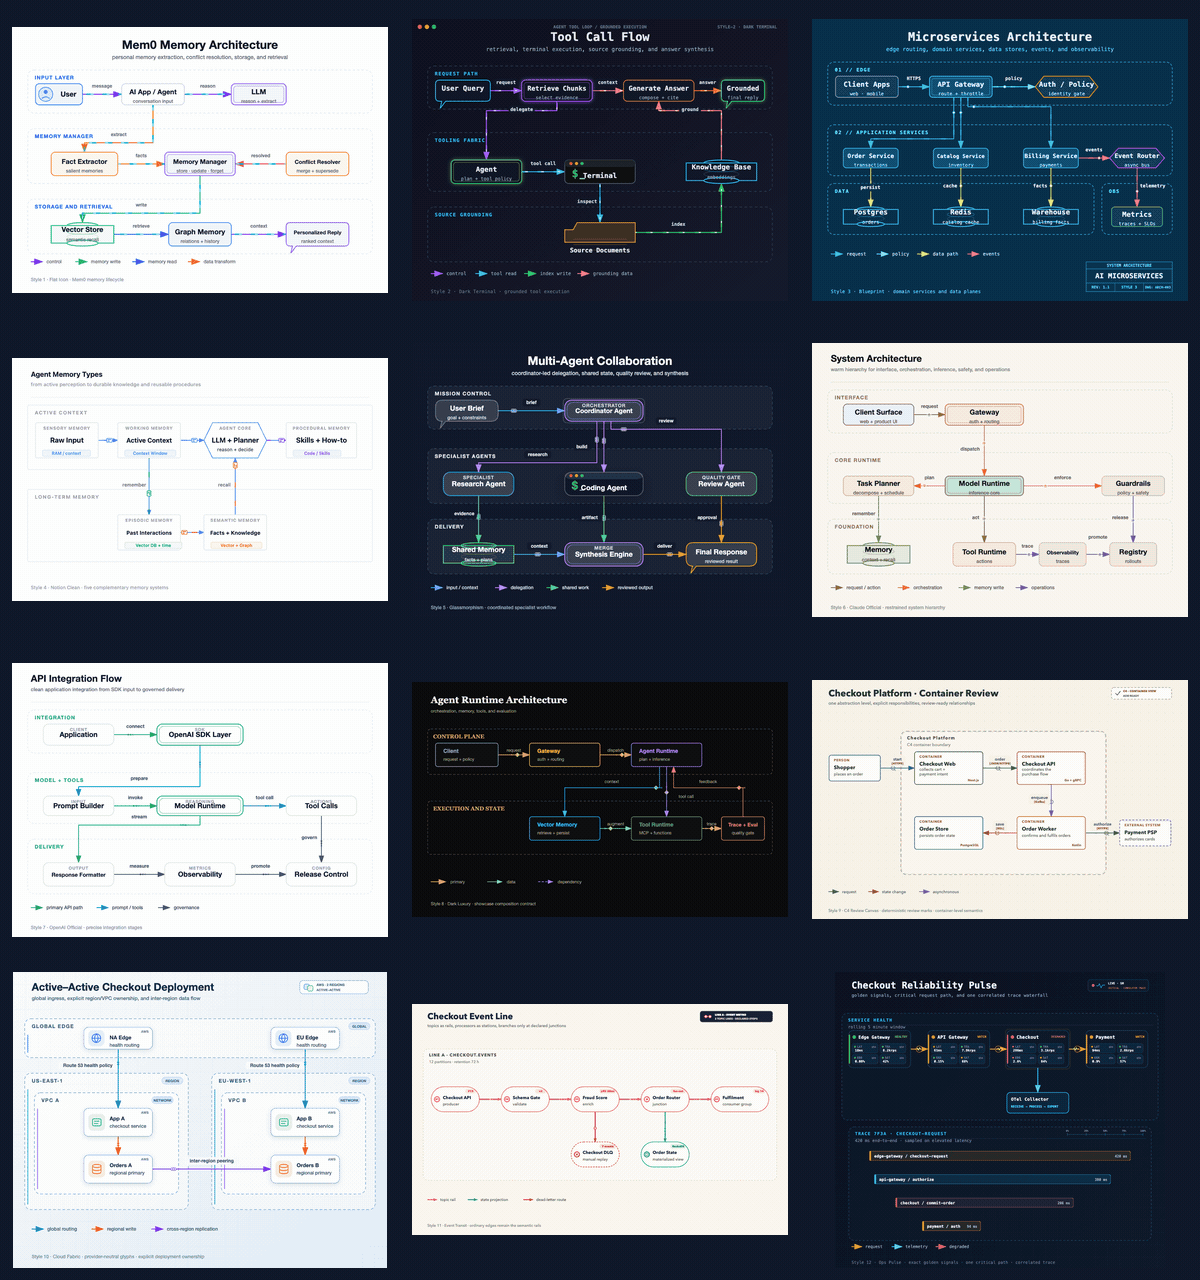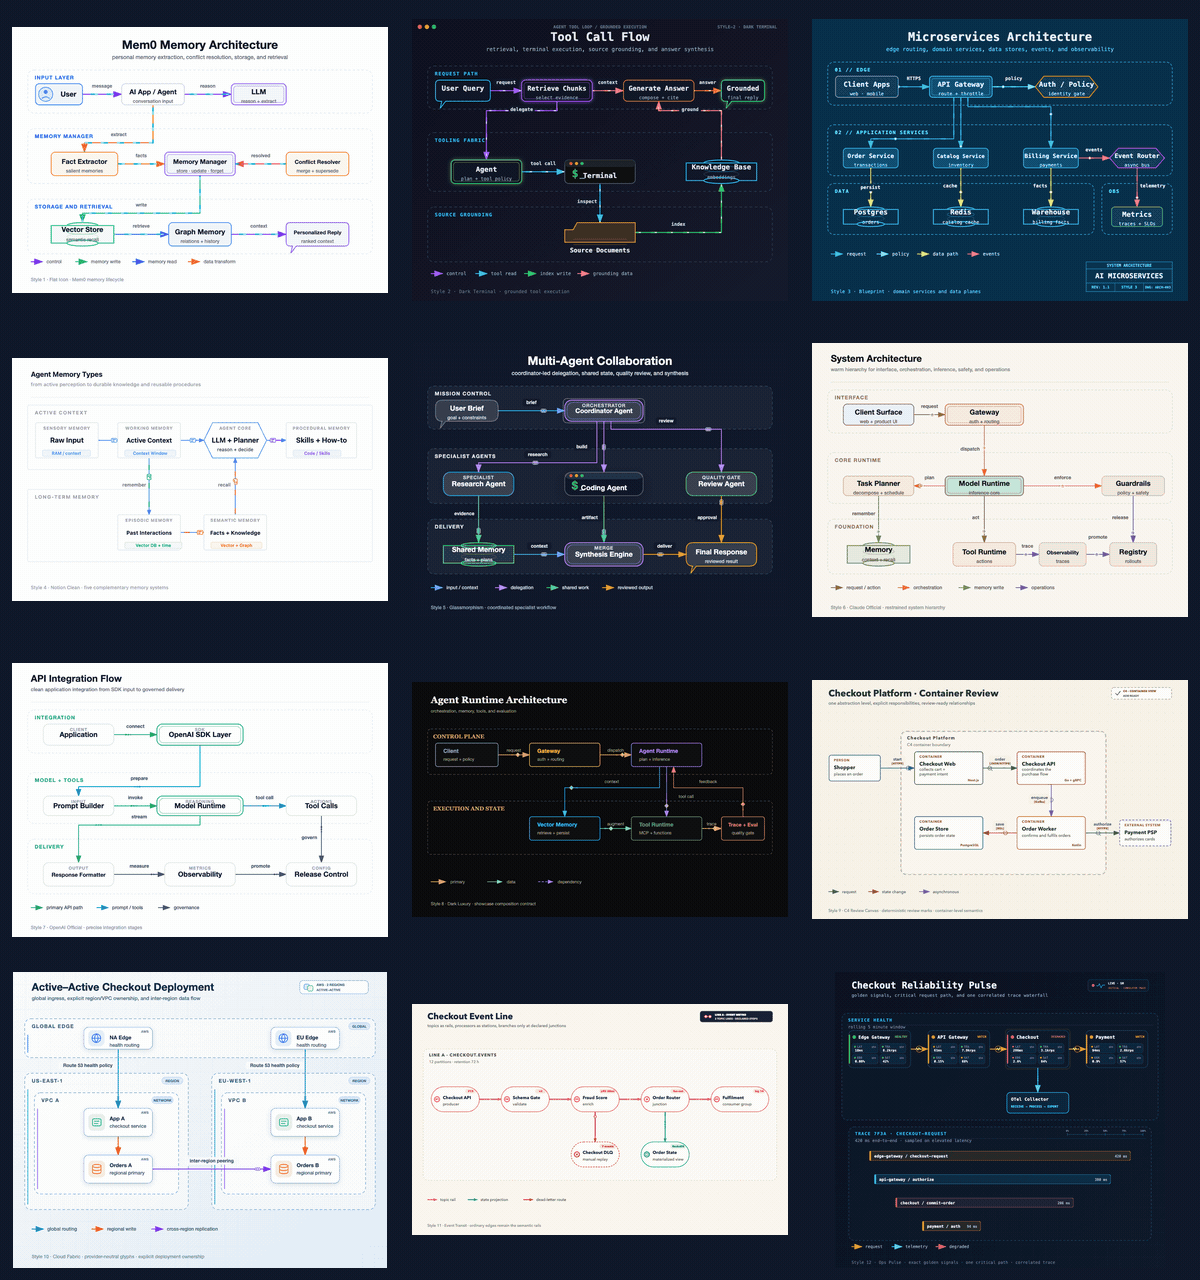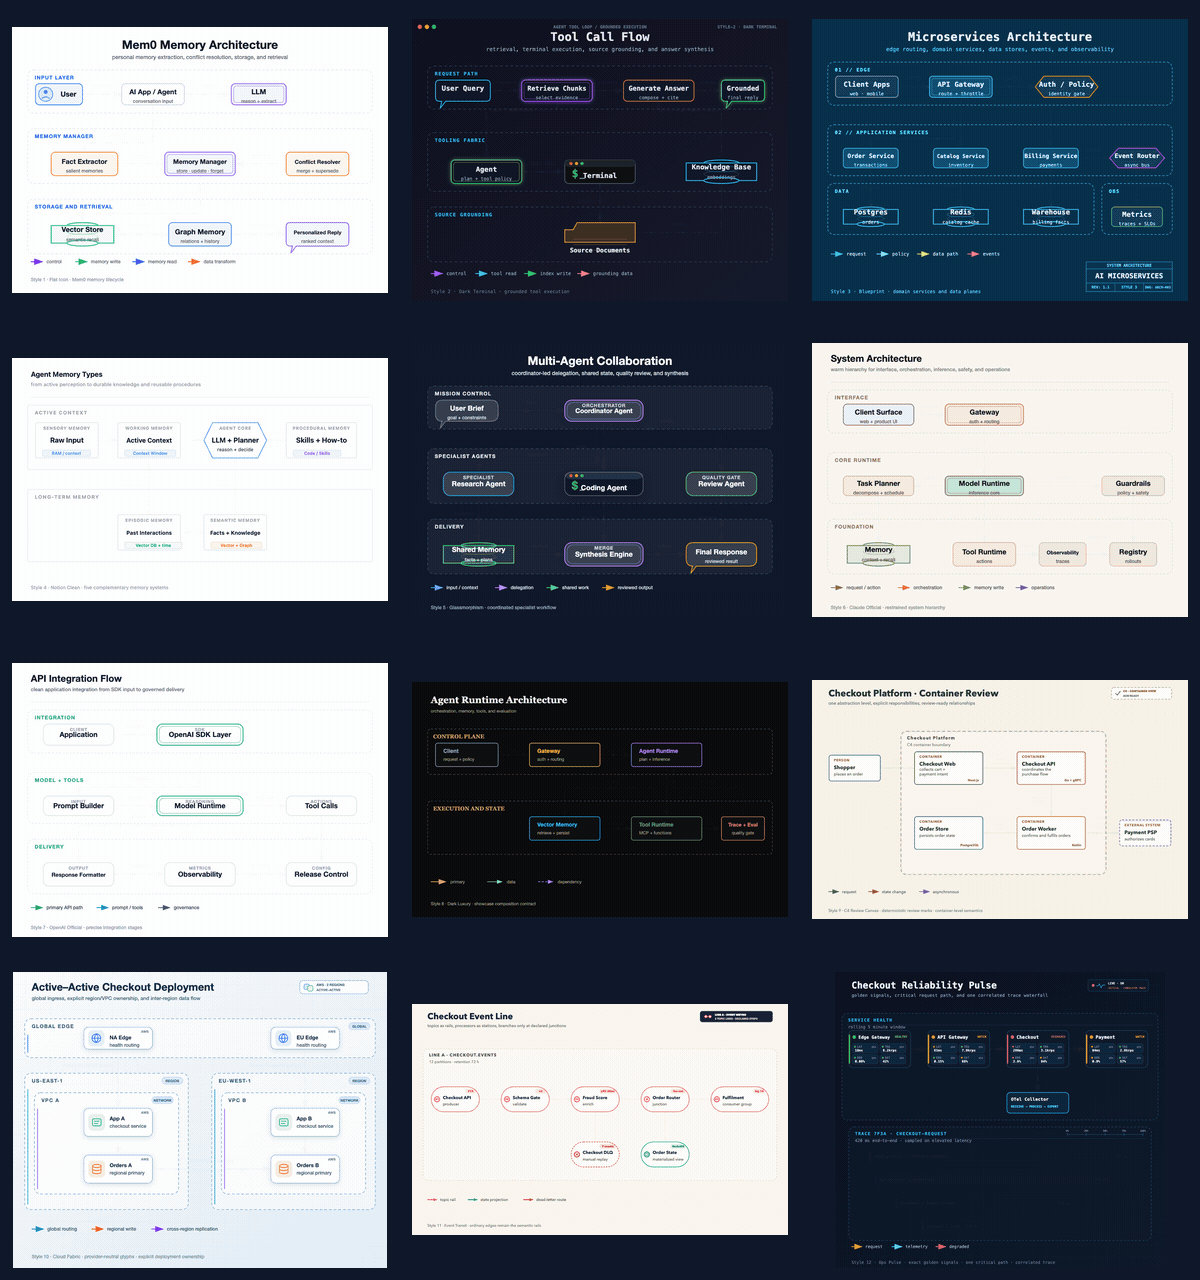
fireworks-tech-graph README 配图
开发工具GitHub 项目

fireworks-tech-graph

用自然语言描述系统,几秒钟生成可嵌入文档的 SVG+PNG 技术图表

Fireworks Tech Graph 是一个专为 Claude Code 设计的开源 Skill,能够将自然语言描述直接转换为生产级质量的 SVG + PNG 技术图表。它支持 8 种图表类型、5 种视觉风格,并内置了深厚的 AI/Agent 领域知识(RAG、Agentic Search、Mem0、Multi-Agent、Tool Call 等)。核心解决的问题是让开发者和技术写作者不用学习任何图表 DSL(如 Mermaid 语法、PlantUML、Graphviz DOT),也不用打开 draw.io 等可视化编辑器,只需要用自然语言描述系统,就能获得出版级的技术图表。它本质上是一套注入到 Claude Code 中的专业绘图知识和规则体系,包含 9 步固定工作流、语义形状系统、语义箭头系统、5 套完整的视觉设计系统、40+ 产品图标库以及 AI/Agent 领域的 7+ 内置架构模式。输出为可编辑的 SVG 文件和 1920px 高清 PNG 文件,完全离线使用,不依赖外部 API 或 CDN。

技术图表开源自然语言生成
09.08