跳到主要内容
LLM Wiki Desktop (nashsu/llm_wiki) · prolist
查看仓库原始简介 LLM Wiki is a cross-platform desktop application that turns your documents into an organized, interlinked knowledge base — automatically. Instead of traditional RAG (retrieve-and-answer from scratch every time), the LLM incrementally builds and maintains a persistent wiki from your sources。
来自项目 README 项目解读 README
项目解读由 AI 根据历史资料整理,尚未经人工复核。仓库资料更新于 2026-09-08,与历史解读分开保留。
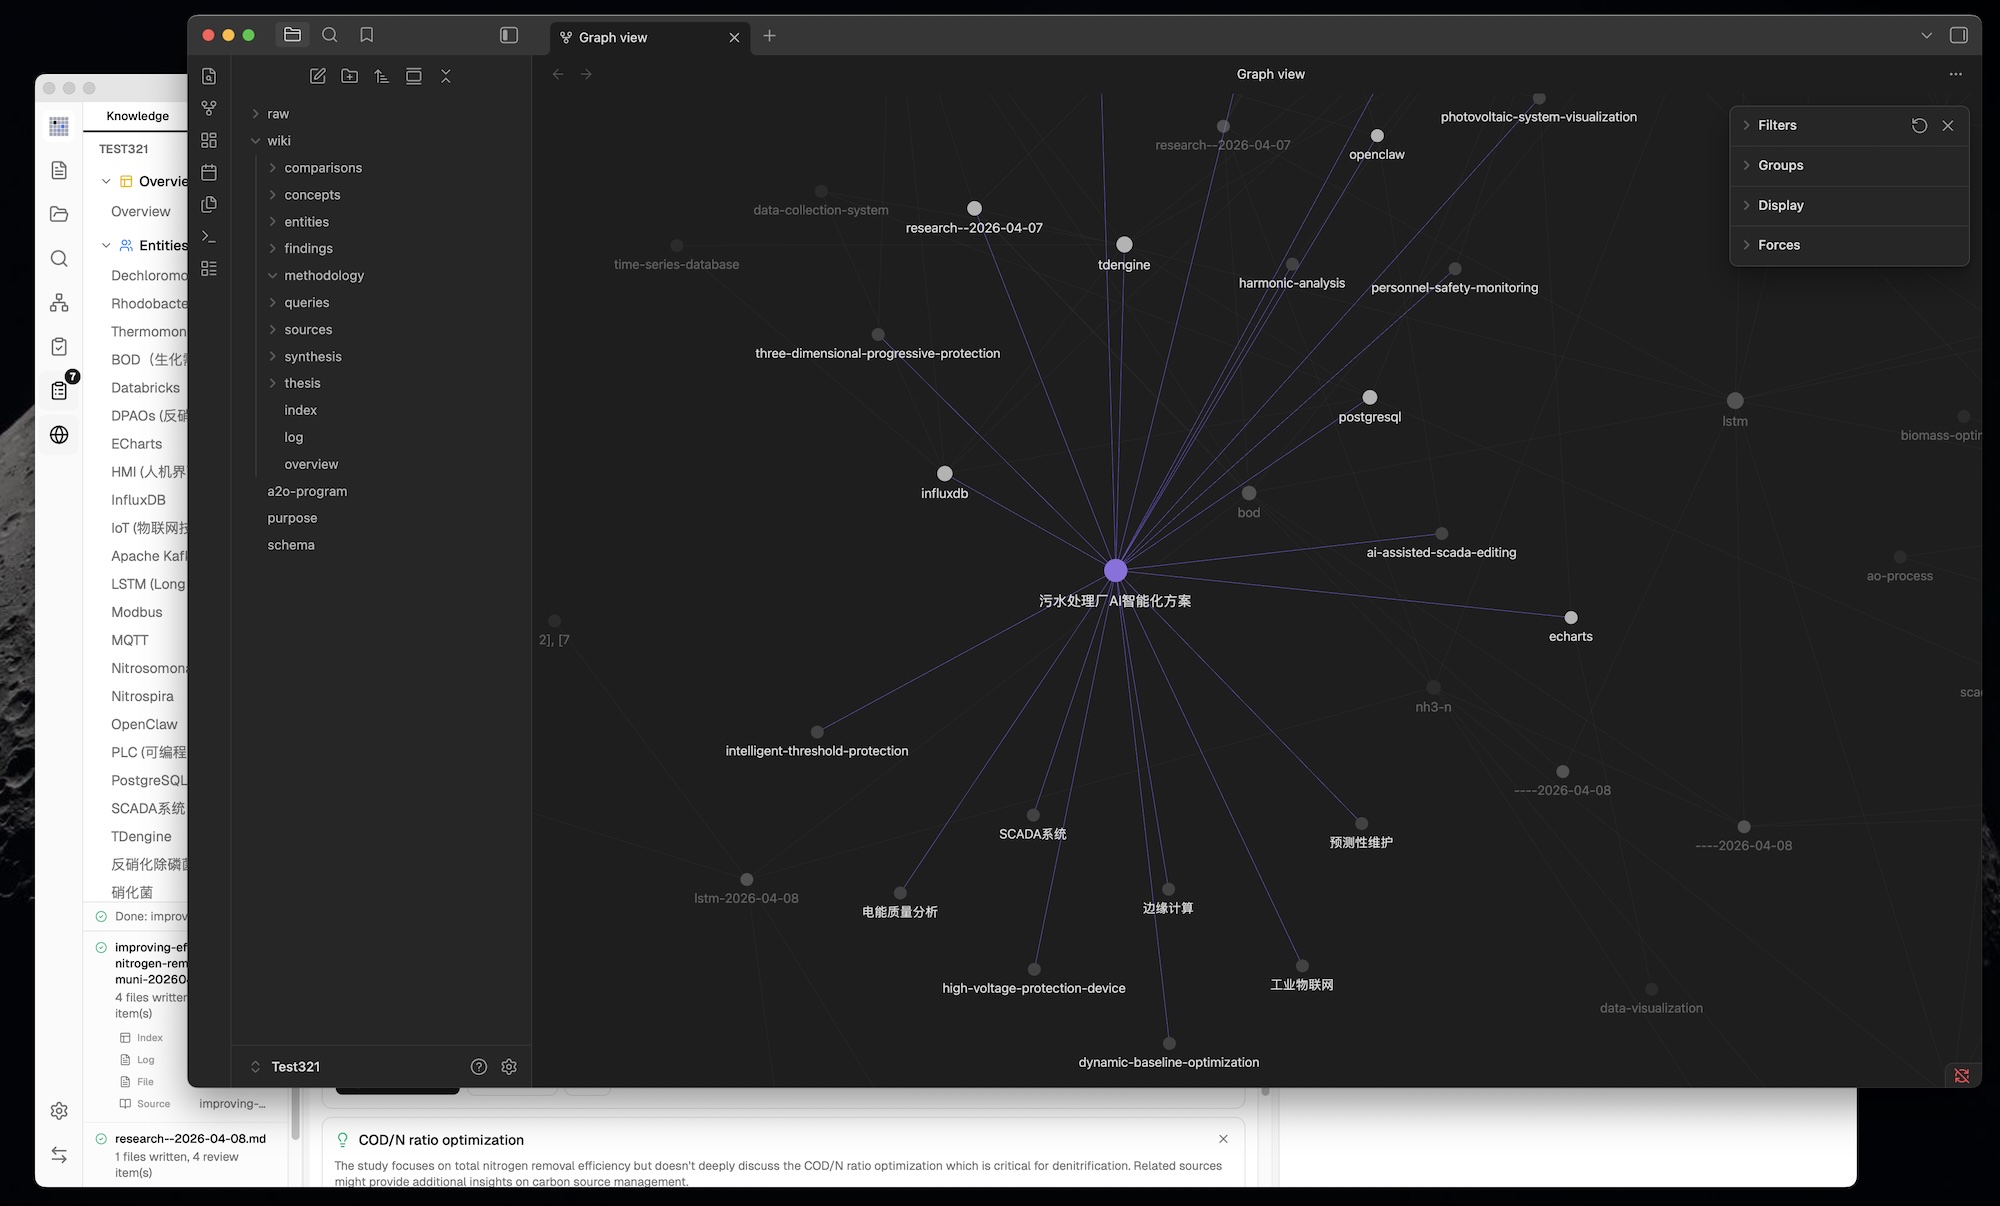
项目概览 LLM Wiki 是一款跨平台桌面应用,由开发者 nashsu(Yong Su)基于 Andrej Karpathy 提出的 LLM Wiki 模式构建,将抽象设计模式转化为功能完整的桌面软件,能够自动将文档转化为结构化、互相关联的知识库。其核心定位是编译式知识管理,区别于传统 RAG 的检索式模式。应用采用三层架构(Schema 层、Wiki 层、Raw 层),支持 Ingest、Query、Lint 三大核心操作。其关键创新是 Two-Step Chain-of-Thought Ingest,将单步摄取拆分为分析和生成两步,以提升页面质量。知识图谱采用四信号模型(直接链接、来源重叠、共同邻居、类型亲和)并结合 Louvain 社区检测。查询采用多阶段检索管线,包含分词搜索、可选向量搜索、图谱扩展和预算控制。应用支持多格式文档导入、Chrome 扩展 Web Clip、Deep Research 等功能,数据完全本地化,Wiki 目录兼容 Obsidian。
解决什么问题 LLM Wiki 旨在解决传统 RAG 在个人知识管理场景中的五个根本性问题:每次查询都重新检索和生成,不会积累理解;大量 token 用于塞原始文档,留给推理的空间有限;检索基于单篇匹配,很难发现跨文档的隐含关联;对话结束即遗忘,知识不持久化;知识散落在向量空间中,无法直观看到全貌。此外,Karpathy 原版作为抽象方法论文档,存在没有用户界面、没有可视化、单步摄取、无知识图谱分析、无向量检索、无多格式支持等落地障碍。LLM Wiki 桌面版要同时解决从模式到产品的跨越和从基础到增强的跨越。
工作方式 LLM Wiki 采用三层架构:Schema 层(规则与配置,定义 Wiki 的结构规则和方向性意图)、Wiki 层(LLM 生成的知识,包含 entities、concepts、sources、comparisons 等结构化页面)、Raw 层(原始文档,不可变)。应用支持三大核心操作:Ingest(摄取新文档,LLM 分析后生成 Wiki 页面)、Query(查询知识库,多阶段检索加图谱扩展)、Lint(检查 Wiki 健康度,修复断裂链接)。其核心创新是 Two-Step Chain-of-Thought Ingest,将单步摄取拆成两步 LLM 调用:Step 1 分析(提取关键实体、概念、论点,关联现有 Wiki 内容,标记矛盾和张力),Step 2 生成(生成 Wiki 文件,更新 index、log、overview,标记 Review 项)。知识图谱采用四信号模型(直接链接权重×3.0、来源重叠权重×4.0、共同邻居权重×1.5、类型亲和权重×1.0),并使用 Louvain 社区检测自动发现知识聚类。查询采用多阶段检索管线:分词搜索(英文分词加标题加权,中文 CJK bigram)、可选向量语义搜索(LanceDB 存储)、图谱扩展(2-hop 遍历加衰减)、预算控制(可配上下文窗口,按比例分配)、上下文组装(编号页面加引用格式)。技术栈包括 Tauri v2(Rust 后端)、React 19、TypeScript、Vite、sigma.js、graphology、LanceDB 等。
核心能力
两步 Chain-of-Thought 摄取,分离分析与生成,页面质量更稳定
四信号加权知识图谱,支持 Louvain 社区检测和 Graph Insights
多阶段查询检索管线,支持关键词搜索、可选向量搜索和图谱扩展
上下文预算控制,可配置 4K 到 1M tokens 窗口
支持 PDF、DOCX、PPTX、XLSX、Markdown 等多格式文档导入
Chrome Extension Web Clip,一键保存网页内容
Deep Research 自动发现知识缺口并补充 Web 搜索
数据完全本地化,不上传云端
Wiki 目录兼容 Obsidian,可随时用 Obsidian 打开
支持 OpenAI、Anthropic、Google、Ollama、Custom、MiniMax 等多种 LLM Provider
跨平台支持 macOS、Windows、Linux
开源 GPL v3.0 许可证
使用前需要了解
AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
根据报告,LLM Wiki 目前存在以下局限:单人项目,仅 1 个贡献者,维护风险较高;早期版本 v0.3.1,API 可能频繁变动;大量文档摄取时 LLM API 调用成本不可忽略;纯本地应用,不支持多人同步编辑;仅桌面应用,无 iOS/Android 移动端;虽支持中文,但 CJK bigram 分词不如专用引擎;知识图谱适合个人或小团队(数百到数千页面),超大规模可能性能下降。报告明确不建议用于以下场景:需要多人实时协作的大型团队知识库;需要全文检索海量文档的企业搜索;需要 API 集成到其他系统的场景(LLM Wiki 是桌面应用,不是 API 服务);需要移动端随时访问的场景。
简体中文 · 官方 原文
LLM Wiki
一个能自我构建的个人知识库。
这是什么? •
功能特性 •
技术栈 •
安装 •
致谢 •
许可证
English | 中文 | 日本語 | 한국어
功能亮点
两步思维链摄入 — LLM 先分析再生成 Wiki 页面,来源可追溯,支持增量缓存多模态图片摄入 — 自动提取 PDF 内嵌图片,调用视觉模型生成事实性描述,搜索结果按图文分区,支持 lightbox 预览与跳转到原始文档对应位置多格式文档解析 — 支持 PDF、Office 文档、EPUB/MOBI、Org mode、图片、音视频、网页剪藏和批量 URL 导入,并提供内置、云端或本地 MinerU PDF 处理灵活的模型配置 — 支持项目级模型配置、Chat/Ingest 独立模型路由,以及自定义 Provider、请求头和流式输出原始资料检索 — 可使用“只读原文”模式,仅依据导入的原始资料回答项目管理与迁移 — 支持完整项目归档的跨设备导入导出,并可根据现有 Wiki 页面重建索引四信号知识图谱 — 直接链接、来源重叠、Adamic-Adar、类型亲和四维关联度模型Louvain 社区检测 — 自动发现知识聚类,内聚度评分图谱洞察 — 惊奇连接与知识空白检测,一键触发 Deep Research向量语义搜索 — 可选的 embedding 检索,基于 LanceDB,支持任意 OpenAI 兼容端点持久化摄入队列 — 串行处理,崩溃恢复,取消/重试,进度可视化文件夹导入 — 递归导入保留目录结构,文件夹路径作为 LLM 分类上下文Source 文件夹自动监听 — 检测 raw/sources/ 的外部变更,并同步触发摄入或删除清理深度研究 — LLM 智能生成搜索主题,通过 Tavily、SerpApi 或 SearXNG 进行多查询网络搜索,研究结果自动摄入 Wiki
Rust 后端 Chat Agent
Agent Skills — 扫描并启用本地 SKILL.md 目录,在聊天中用 /skill 选择,让 Agent 按需读取 Skill 指令
生成物预览 — Agent 生成的 Markdown、HTML、图片等 workspace 文件会作为生成物展示,支持预览和快速打开目录
Mermaid 流程图渲染 — 聊天和预览中可直接渲染 Mermaid 代码块,语法错误会显示为紧凑错误卡片
异步审核系统 — LLM 在摄入时标记需人工判断的项,预定义操作,预生成搜索查询
Chrome 网页剪藏 — 一键捕获网页内容,自动摄入知识库本地 HTTP API + MCP Server + AI Agent Skill — 内置 127.0.0.1:19828 JSON API 和随包提供的 MCP Server,支持 Hybrid 检索、文件读取、知识图谱遍历、源资料重新扫描;配套 agent skill 一行命令接入 Claude Code / Codex(npx skills add …)
这是什么? LLM Wiki 是一个跨平台桌面应用,能将你的文档自动转化为有组织、相互关联的知识库。与传统 RAG(每次查询都从头检索和回答)不同,LLM 会从你的资料中增量构建并维护一个持久化的 Wiki 。知识只编译一次并持续更新,而非每次查询都重新推导。
致谢 基础方法论来自 Andrej Karpathy 的 llm-wiki.md ,描述了使用 LLM 增量构建和维护个人 Wiki 的设计模式。原始文档是一个抽象的设计范式;本项目是一个具体的实现,并有大量扩展。
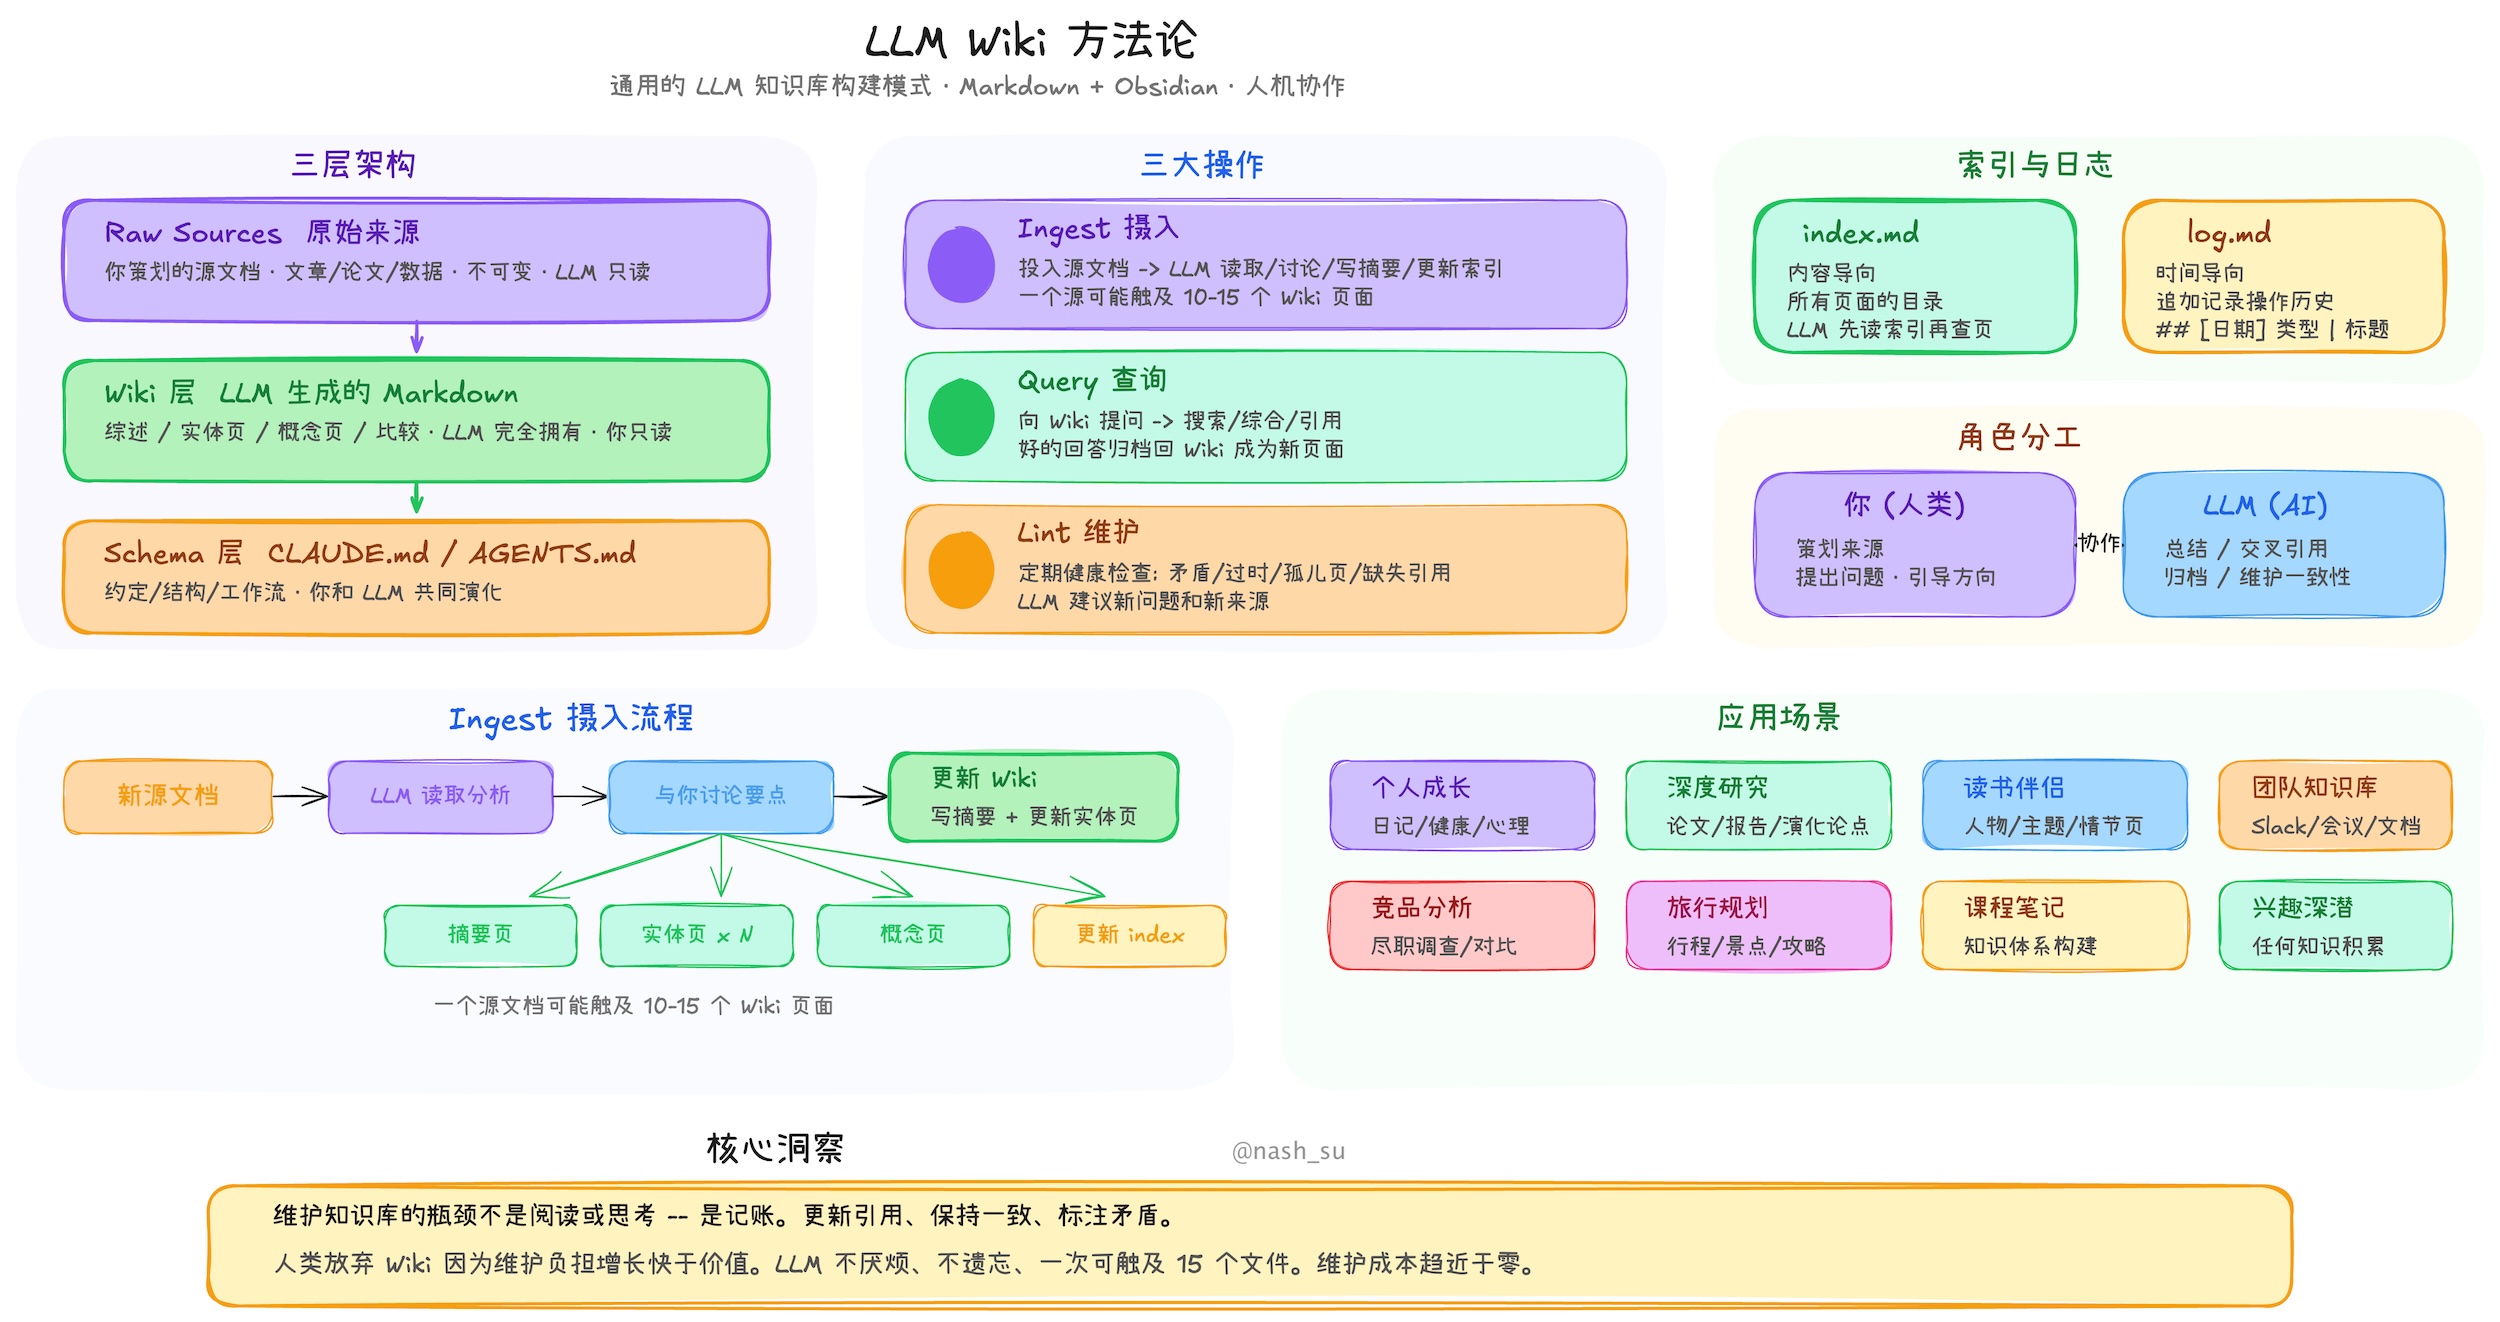
保留的原始设计
三层架构 :原始资料(不可变)→ Wiki(LLM 生成)→ Schema(规则和配置)三个核心操作 :Ingest(摄入)、Query(查询)、Lint(检查)index.md 作为内容目录和 LLM 导航入口log.md 作为可解析格式的时序操作记录[[wikilink]] 语法用于交叉引用YAML frontmatter 存在于每个 Wiki 页面Obsidian 兼容 —— Wiki 目录可直接作为 Obsidian 仓库使用人类策展,LLM 维护 —— 基本角色分工
我们的修改与新增
1. 从命令行到桌面应用 原始设计是一个抽象的模式文档,设计上是复制粘贴给 LLM agent 使用的。我们将其构建为完整的跨平台桌面应用 :
三栏布局 :知识树 / 文件树(左)+ 聊天(中)+ 预览(右)图标侧边栏 —— 在 Wiki、资料源、搜索、图谱、Lint、审核、深度研究、设置之间快速切换自定义可调面板 —— 左右面板支持拖拽调整大小,带最小/最大约束活动面板 —— 实时处理状态,逐文件显示摄入进度全状态持久化 —— 对话、设置、审核项、项目配置在重启后保持场景模板 —— 研究、阅读、个人成长、商业、通用 —— 每个模板预配置 purpose.md 和 schema.md
2. Purpose.md —— Wiki 的灵魂 原始设计有 Schema(Wiki 如何运作),但没有正式定义 为什么 这个 Wiki 存在。我们新增了 purpose.md:
定义目标、关键问题、研究范围、演进中的论点
LLM 在每次摄入和查询时都会读取它以获取上下文
LLM 可以根据使用模式建议更新
与 schema 不同 —— schema 是结构规则,purpose 是方向意图
3. 两步思维链摄入 原始设计描述的是 LLM 同时阅读和写入的单步摄入。我们将其拆分为两次顺序 LLM 调用 ,显著提升质量:
第一步(分析):LLM 阅读资料 → 结构化分析
  - 关键实体、概念、论点
  - 与现有 Wiki 内容的关联
  - 与现有知识的矛盾和张力
  - Wiki 结构建议

第二步(生成):LLM 基于分析 → 生成 Wiki 文件
  - 带 frontmatter 的资料摘要(type, title, sources[])
  - 实体页面、概念页面及交叉引用
  - 更新 index.md、log.md、overview.md
  - 需要人工判断的审核项
  - 深度研究的搜索查询
SHA256 增量缓存 —— 摄入前检查源文件内容哈希,未变更则自动跳过,节省 LLM token 和时间持久化摄入队列 —— 串行处理防止并发 LLM 调用;队列持久化到磁盘,应用重启后自动恢复;失败任务自动重试最多 3 次文件夹导入 —— 递归导入保留目录结构;文件夹路径作为分类上下文传给 LLM(如 "papers > energy" 帮助分类)Source 文件夹自动监听 —— 在应用外新增、修改或删除 raw/sources/ 文件时会被自动检测,并复用应用内相同的摄入/删除生命周期队列可视化 —— 活动面板显示进度条、排队/处理中/失败任务,支持取消和重试自动 Embedding —— 开启向量搜索时,新页面摄入后自动生成 embedding来源可追溯 —— 每个生成的 Wiki 页面在 YAML frontmatter 中包含 sources: [] 字段,链接回贡献的原始资料文件overview.md 自动更新 —— 全局概要页面在每次摄入后重新生成,反映 Wiki 最新状态保证资料摘要生成 —— 兜底机制确保资料摘要页面始终被创建,即使 LLM 遗漏语言感知生成 —— LLM 按用户配置的语言(中文或英文)响应资料源渐进渲染 —— 大型资料目录会随滚动分批渲染,保持 Sources 页面流畅
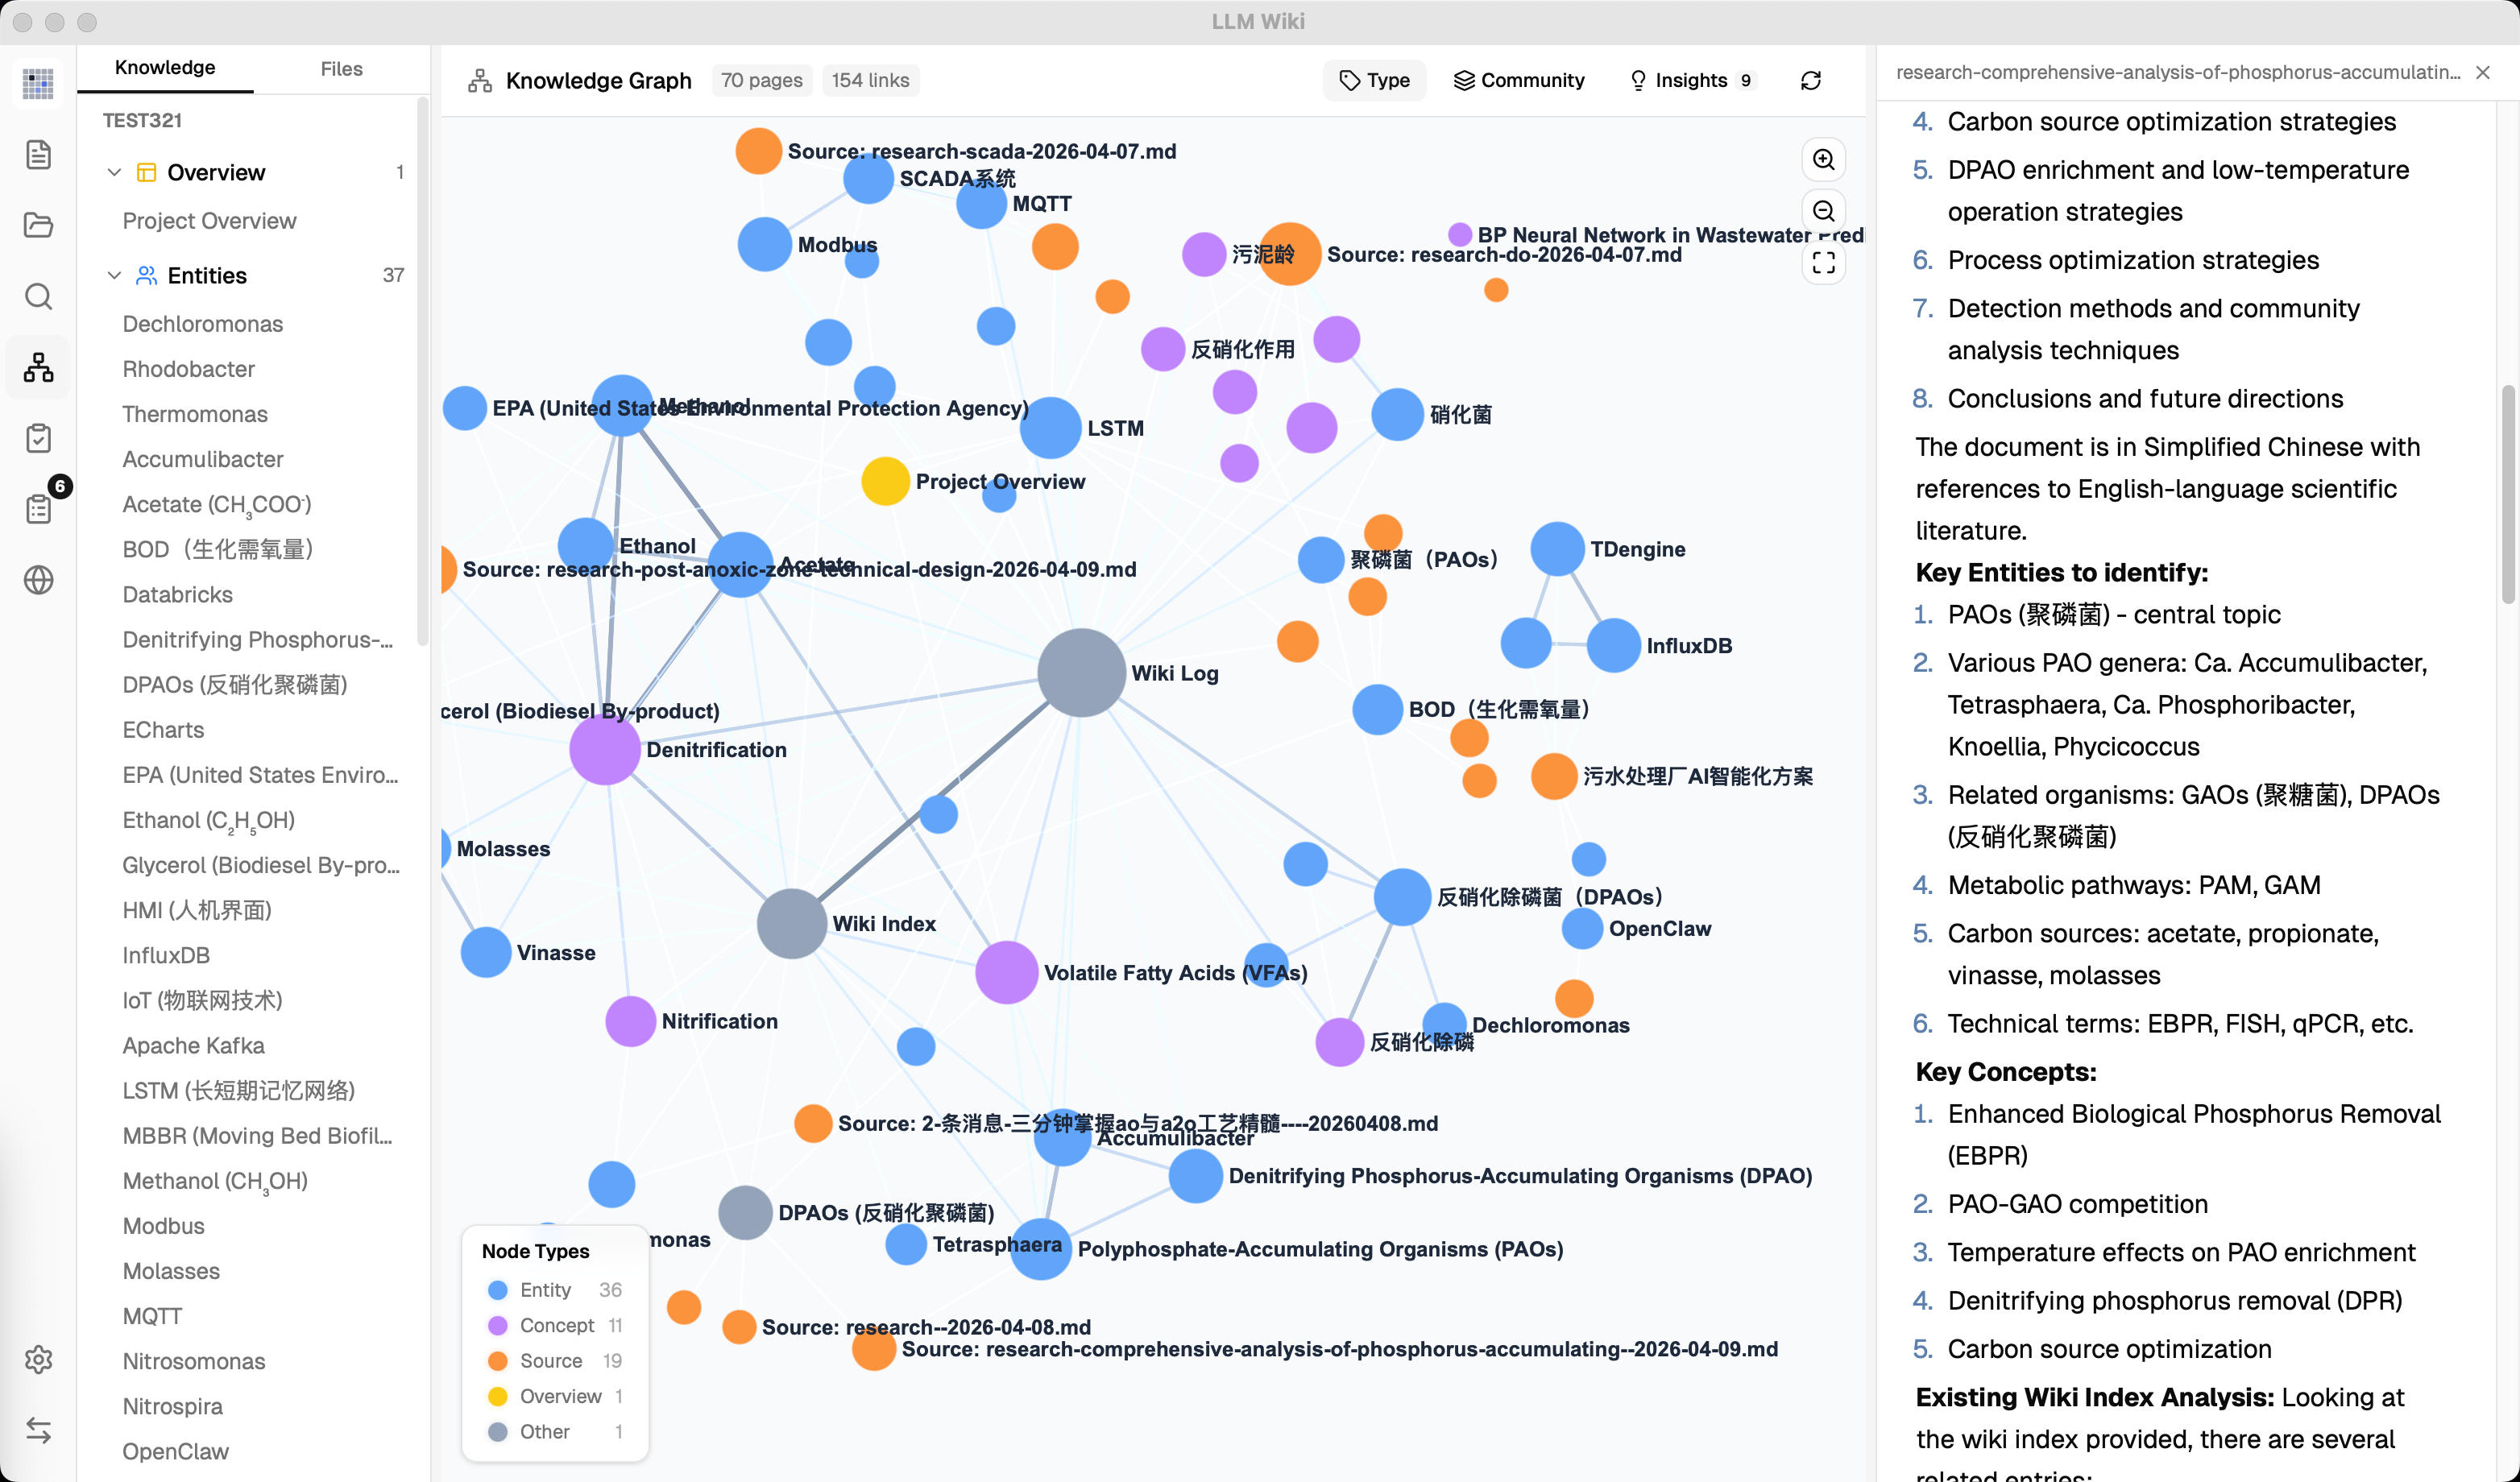
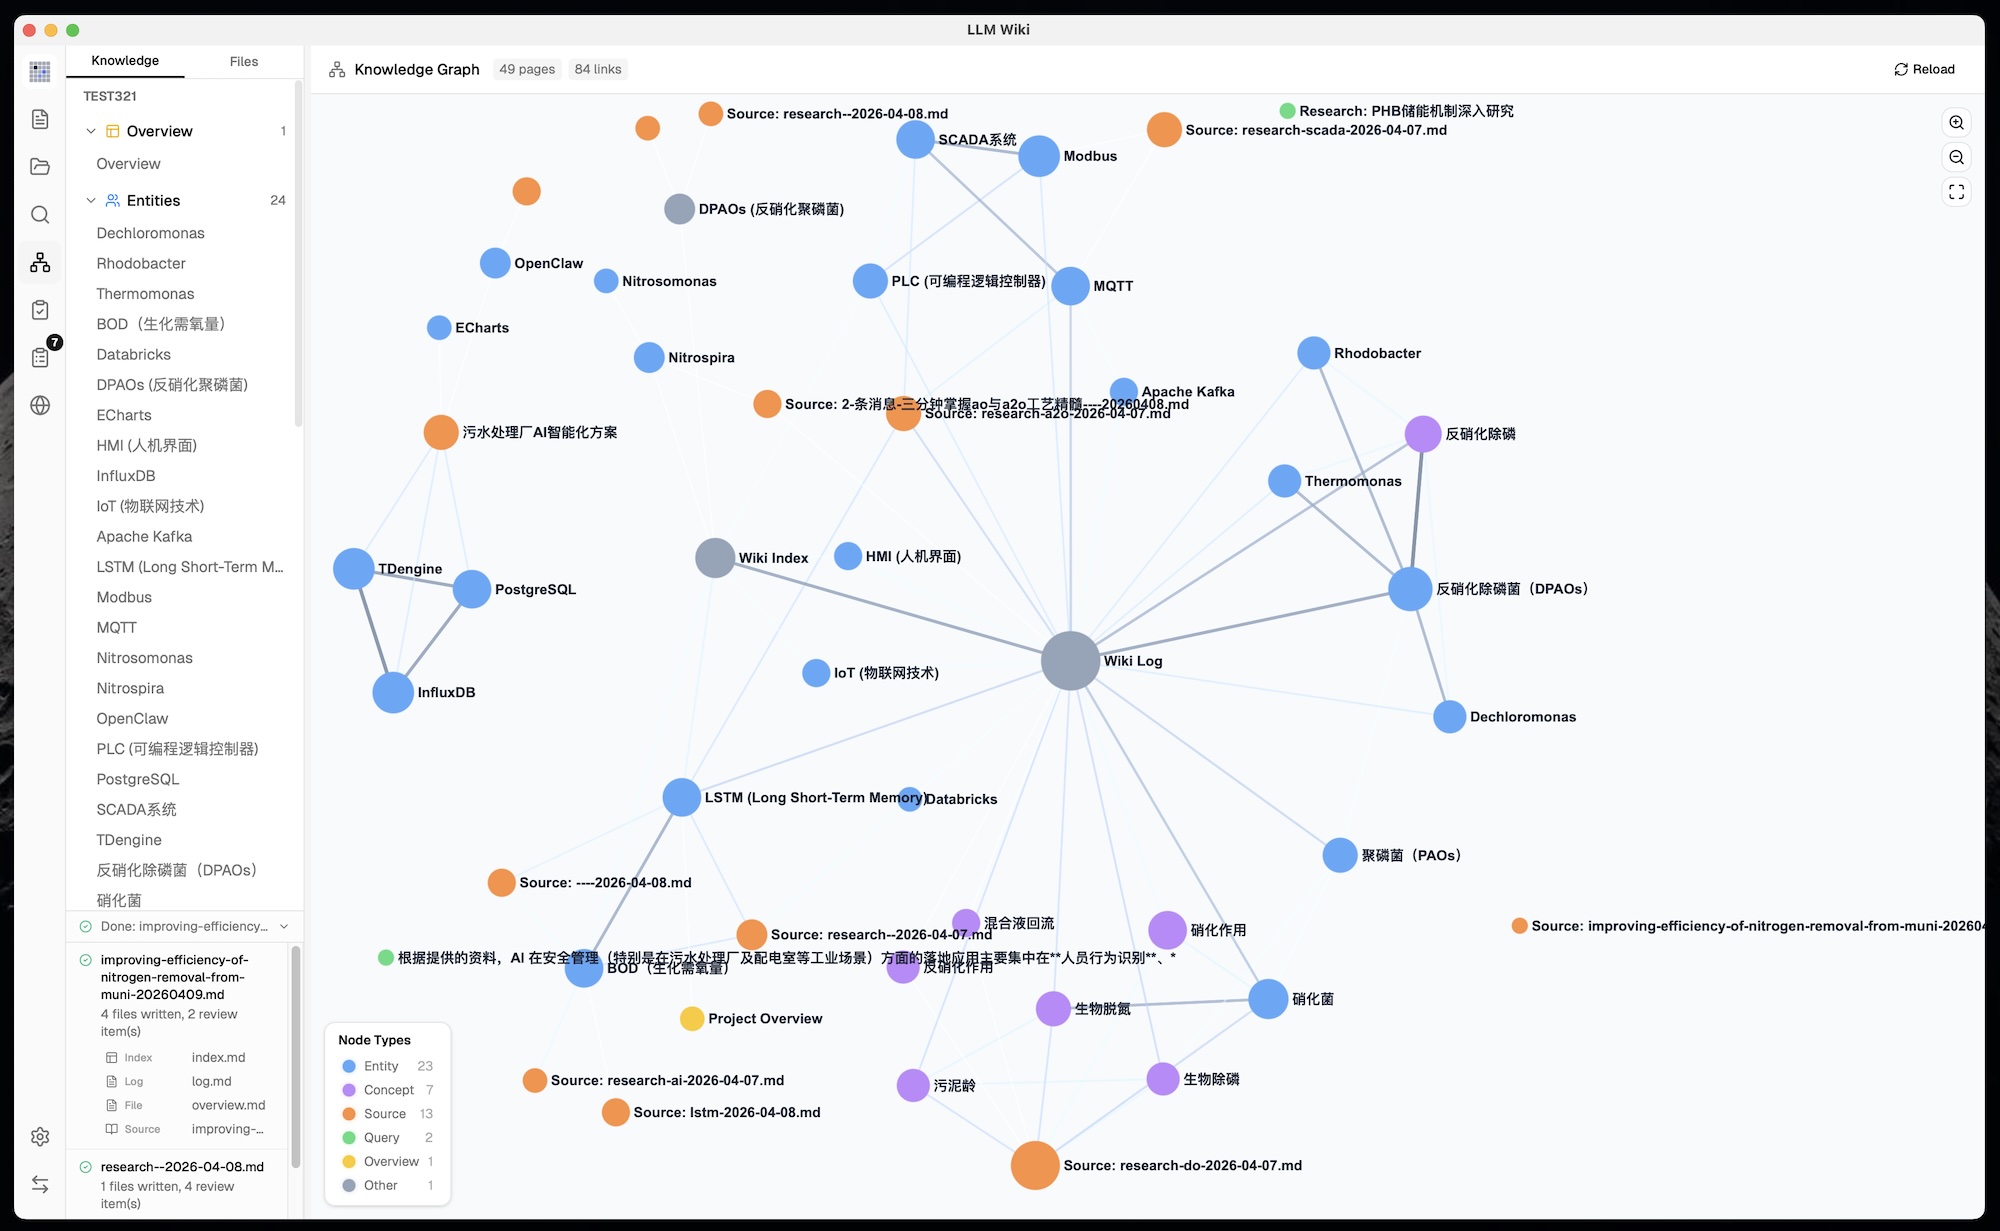
4. 知识图谱与关联度模型 原始设计提到了 [[wikilinks]] 用于交叉引用,但没有图分析。我们构建了完整的知识图谱可视化和关联度引擎 :
图谱可视化(sigma.js + graphology + ForceAtlas2):
按页面类型或社区着色节点,按链接数缩放节点大小(√ 缩放)
边的粗细和颜色按关联权重变化(绿色=强,灰色=弱)
悬停交互:邻居节点保持可见,非邻居变暗,边高亮并显示关联度分数
缩放控件(放大、缩小、适应屏幕)
位置缓存防止数据更新时布局跳动
图例根据着色模式自动切换类型计数或社区信息
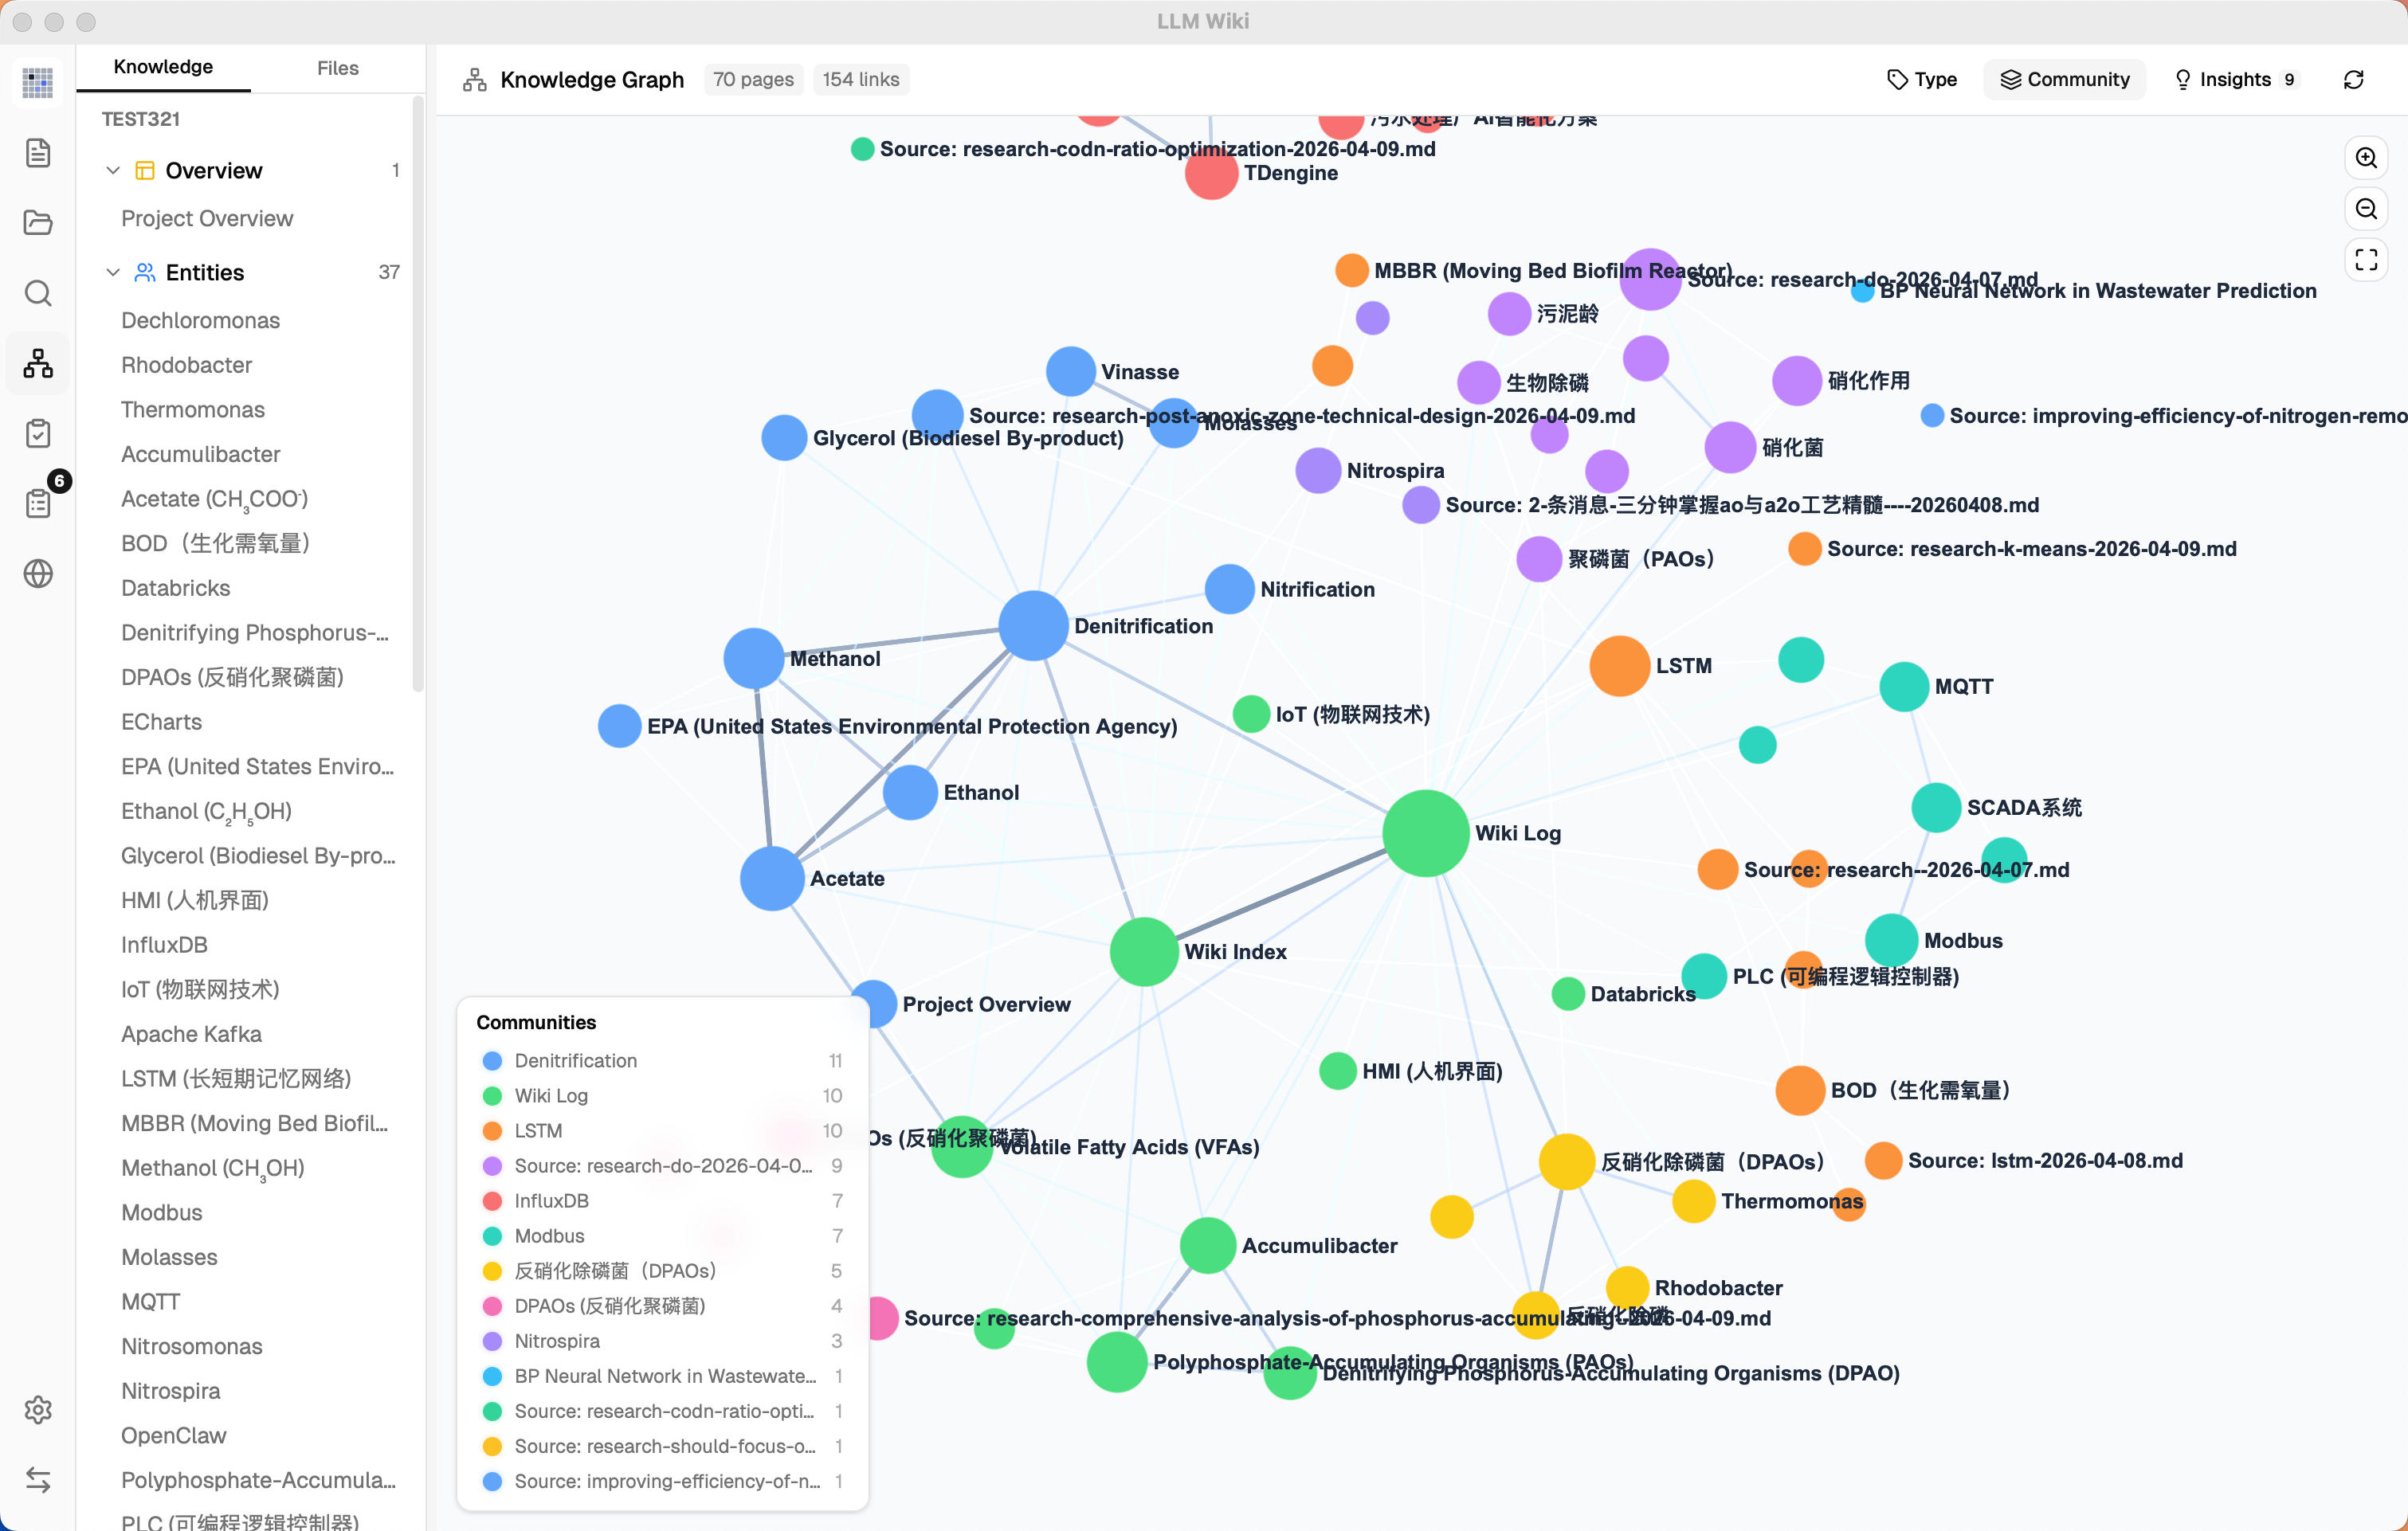
5. Louvain 社区检测 原始设计中没有。基于 Louvain 算法 (graphology-communities-louvain)自动发现知识聚类:
自动聚类 —— 根据链接拓扑发现哪些页面自然归为一组,独立于预定义的页面类型类型 / 社区 一键切换 —— 按页面类型(实体、概念、资料...)或按发现的知识集群着色内聚度评分 —— 每个社区按内部边密度(实际边数 / 可能边数)评分;低内聚社区(< 0.15)标警告12 色调色板 —— 集群之间视觉区分清晰社区图例 —— 显示核心节点标签、成员数和内聚度
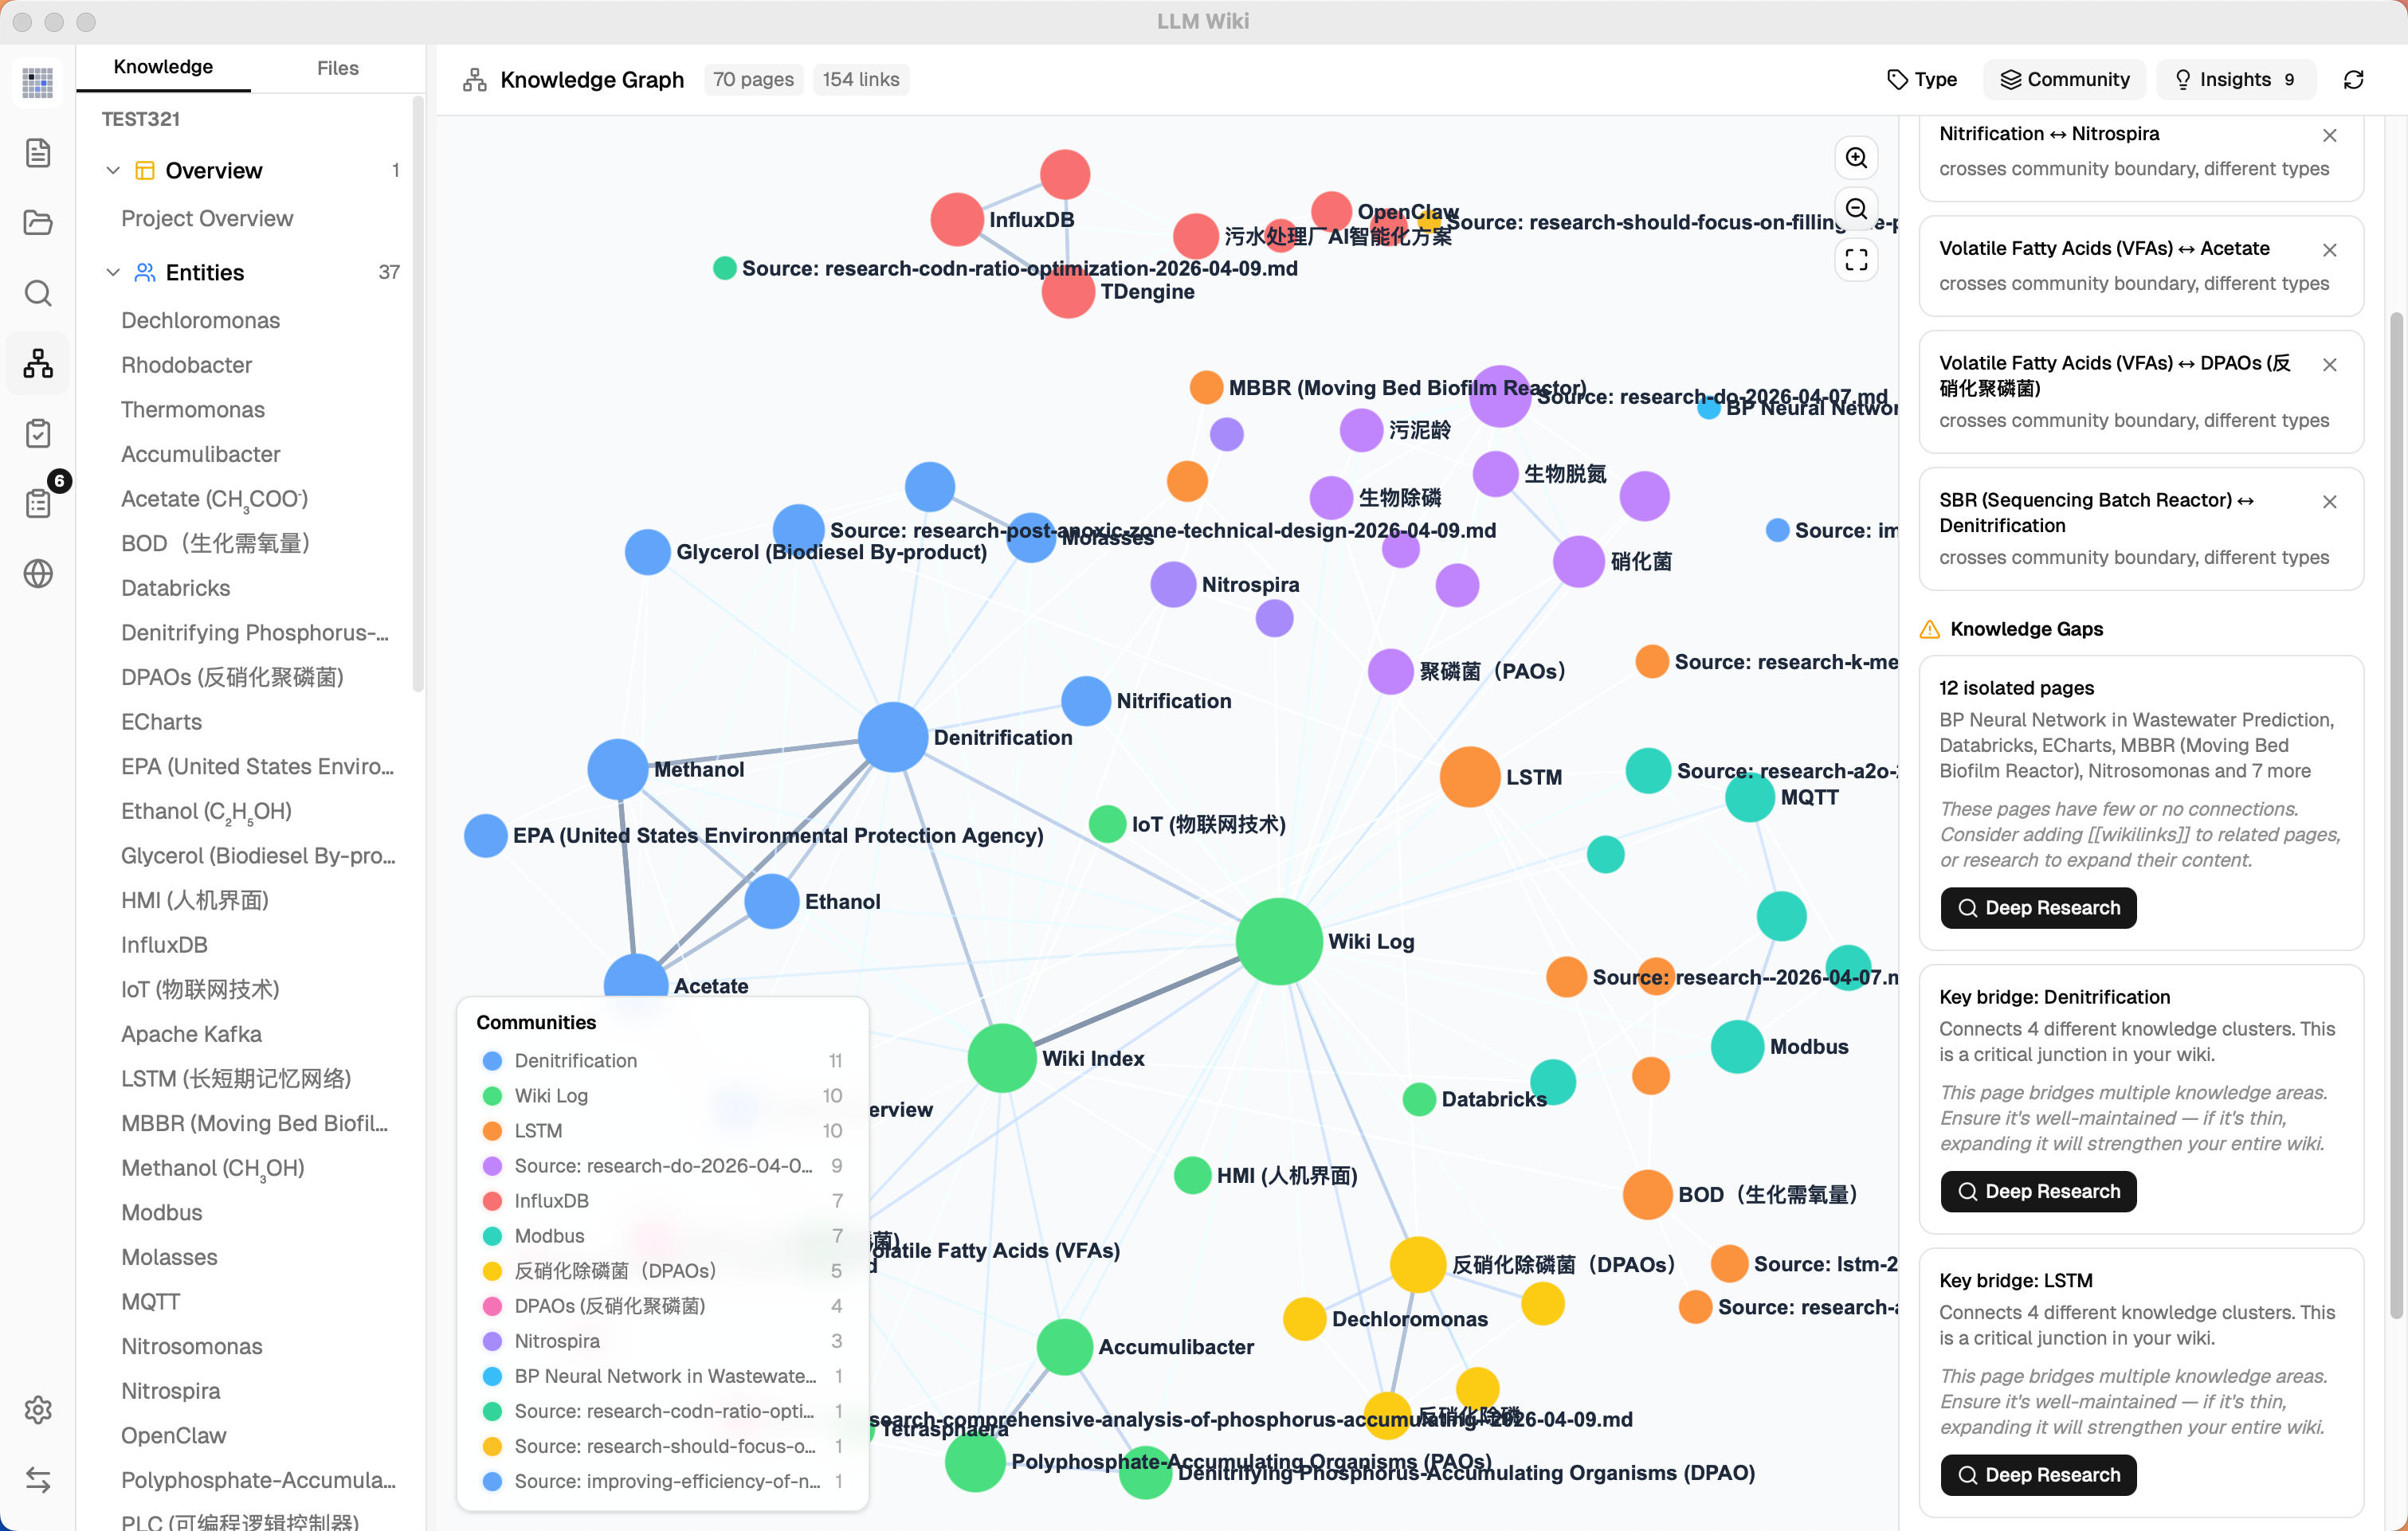
6. 图谱洞察 —— 惊奇连接与知识空白 原始设计中没有。系统自动分析图谱结构 ,呈现可操作的洞察:
检测意外关联:跨社区边、跨类型链接、边缘↔核心耦合
复合惊奇度评分排序最值得关注的连接
可消除 —— 标记为已查看后不再重复出现
孤立页面 (度 ≤ 1)—— 与 Wiki 其余部分缺少连接的页面稀疏社区 (cohesion < 0.15,≥ 3 页)—— 内部交叉引用薄弱的知识领域桥接节点 (连接 3+ 个集群)—— 维系多个知识领域的关键枢纽页面
点击洞察卡片高亮 图谱中对应节点和边;再次点击取消
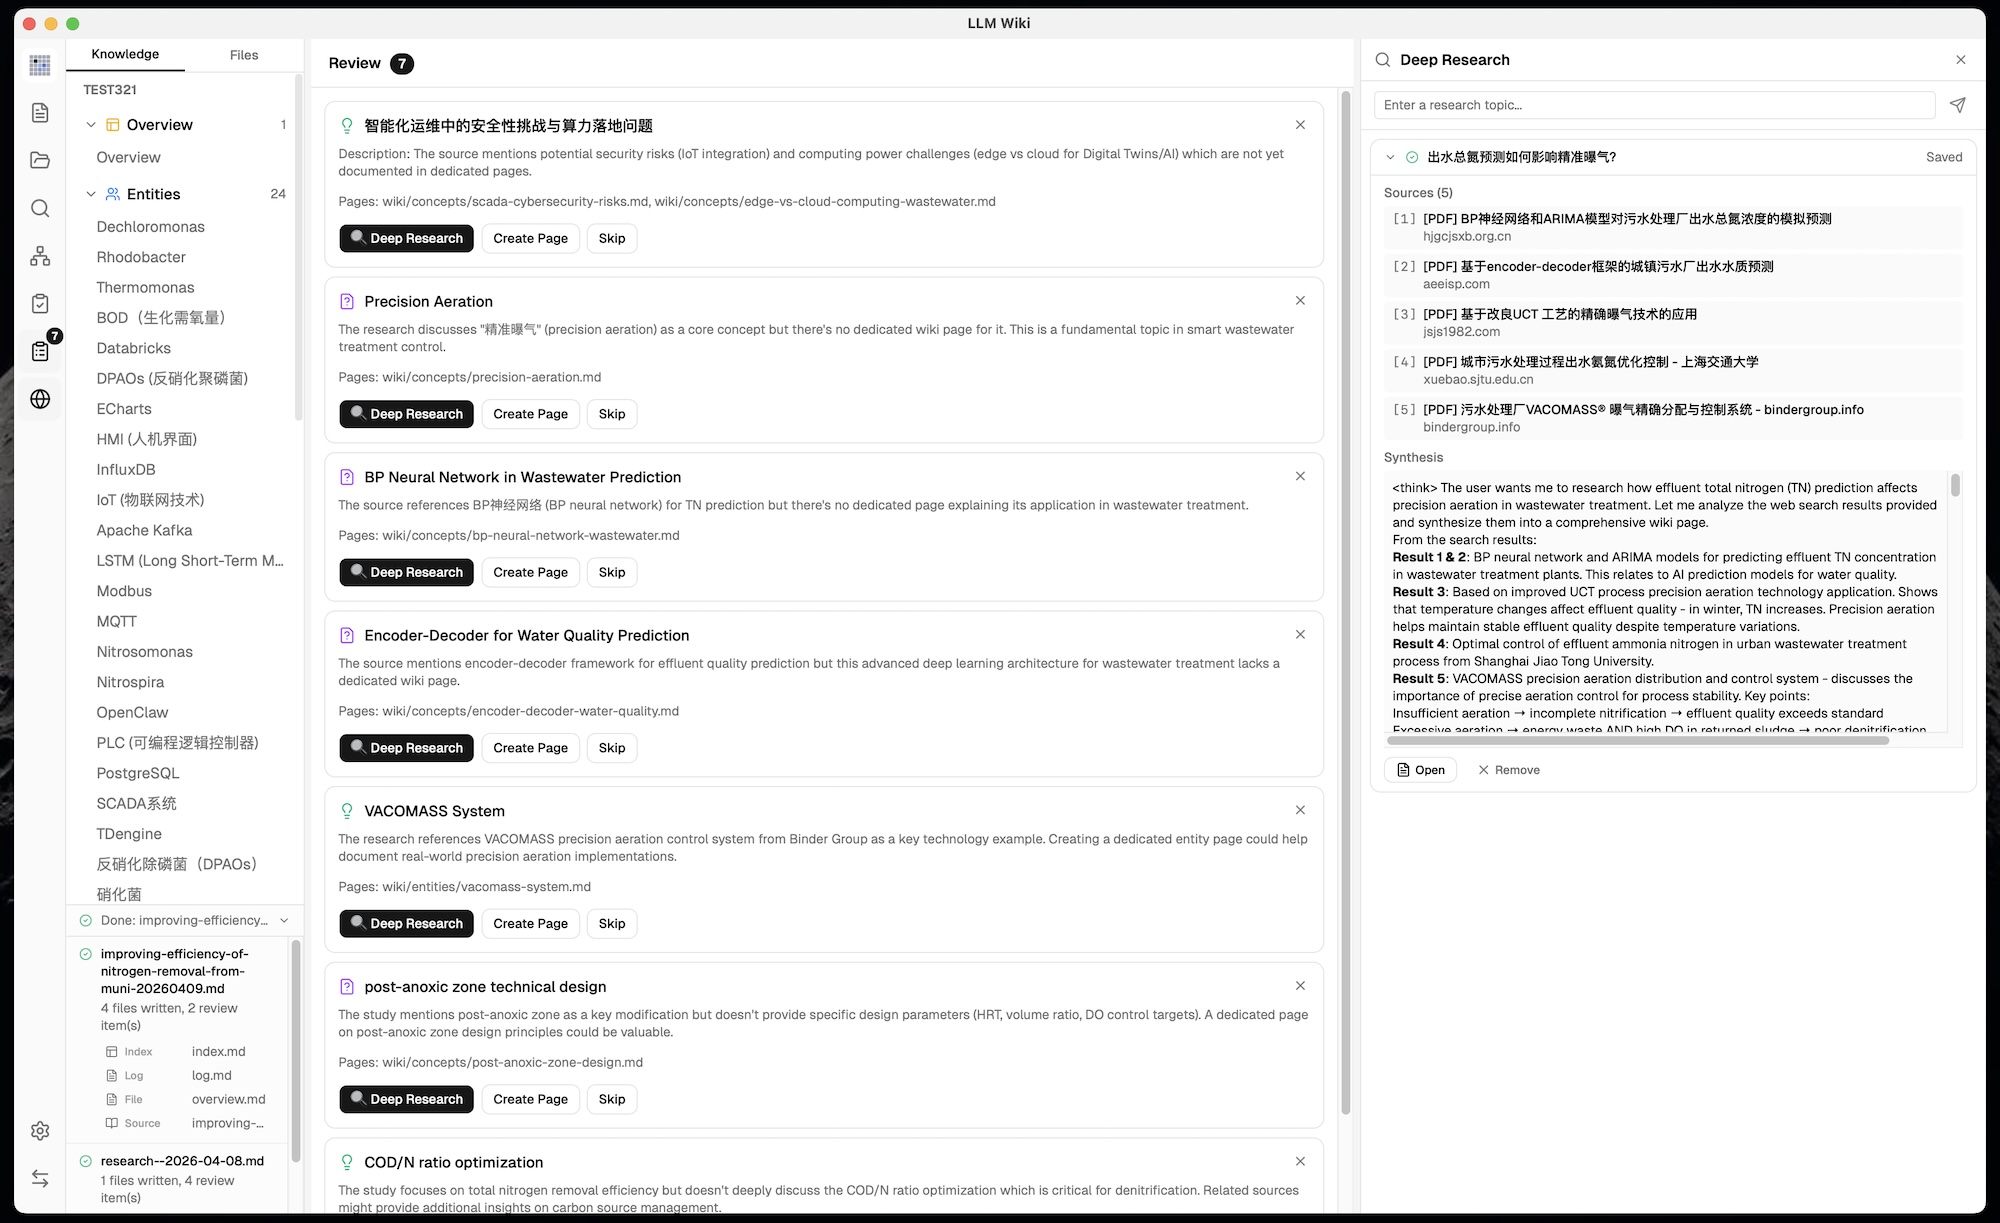
知识空白和桥接节点附带 Deep Research 按钮 —— 触发 LLM 智能主题生成(读取 overview.md + purpose.md 获取领域上下文)
研究主题在可编辑确认对话框 中展示 —— 用户可修改主题和搜索查询后再启动
7. 优化的查询检索管线 原始设计描述了 LLM 读取相关页面的简单查询。我们构建了支持可选向量搜索的多阶段检索管线 :
阶段 1:分词搜索
  - 英文:分词 + 停用词过滤
  - 中文:CJK 二元组分词(每个 → [每个, 个…])
  - 标题匹配加分(+10 分)
  - 同时搜索 wiki/ 和 raw/sources/

阶段 1.5:向量语义搜索(可选)
  - 通过任意 OpenAI 兼容的 /v1/embeddings 端点生成 embedding
  - 存储在 LanceDB(Rust 后端)中进行快速 ANN 检索
  - 余弦相似度发现即使没有关键词重叠也语义相关的页面
  - 结果合并:增强已有匹配 + 添加新发现

阶段 2:图谱扩展
  - 搜索结果作为种子节点
  - 四信号关联度模型发现相关页面
  - 2 跳遍历带衰减,发现更深层关联

阶段 3:预算控制
  - 可配置上下文窗口:4K → 1M tokens
  - 比例分配:60% Wiki 页面,20% 聊天历史,5% 索引,15% 系统提示
  - 页面按搜索 + 图谱关联度综合分数排序

阶段 4:上下文组装
  - 编号页面附完整内容(非仅摘要)
  - 系统提示包含:purpose.md、语言规则、引用格式、index.md
  - LLM 被指示按编号引用页面:[1]、[2] 等
向量搜索 完全可选 —— 默认关闭,在设置中开启,有独立的端点、API Key 和模型配置。关闭时管线 fallback 到分词搜索 + 图谱扩展。基准测试:开启向量搜索后整体召回率从 58.2% 提升至 71.4%。
8. 多对话聊天与持久化 原始设计只有单一查询接口。我们构建了完整的多对话支持 :
独立聊天会话 —— 创建、重命名、删除对话对话侧边栏 —— 快速切换不同主题逐对话持久化 —— 每个对话保存到 .llm-wiki/chats/{id}.json可配置历史深度 —— 限制作为上下文发送的消息数量(默认:10)引用参考面板 —— 每条回复上可折叠的区域,显示使用了哪些 Wiki 页面,按类型分组并附图标引用持久化 —— 引用的页面直接存储在消息数据中,重启后稳定不变重新生成 —— 一键重新生成最后一条回复(移除最后的助手+用户消息对,重新发送)保存到 Wiki —— 将有价值的回答归档到 wiki/queries/,然后自动摄入提取实体/概念到知识网络
9. Rust 后端 Chat Agent 与 Skills 原始设计中没有。聊天现在由 Rust 后端 Agent runtime 驱动,而不是只在浏览器端运行 TypeScript 循环:
工具型 Agent —— 可自主选择 Wiki 检索、Source 检索、图谱检索、网页搜索、AnyTXT、workspace 文件工具、已批准的 shell 命令和 Skill 文件读取Skill 管理 —— 扫描项目级和用户级 Skill 目录,启用或禁用 Skill,并在每个会话中通过 /skill 补全选择 Skill生成物管理 —— Agent 工具生成的文件统一放在 agent-workspace/ 下,并作为生成物在聊天中展示、预览或打开目录用户交互表单 —— Skill 可以请求单选、多选或自由文本等结构化用户输入,不需要为每个 Skill 硬编码专用界面更安全的执行模型 —— 项目 workspace 内的命令可以顺畅继续执行,外部 shell 命令仍需要明确批准
10. 思维链 / 推理过程展示 原始设计中没有。针对会输出 <think> 块的 LLM(DeepSeek、QwQ 等):
流式思维展示 —— 生成中滚动显示 5 行,带透明度渐变默认折叠 —— 生成完成后思维块隐藏,点击展开视觉分离 —— 思维内容以独特样式显示,与主回复分开
11. Markdown 渲染:KaTeX 数学公式与 Mermaid 图表 原始设计中没有。聊天和预览支持更丰富的 Markdown 渲染:
KaTeX 渲染 —— 行内 $...$ 和块级 $$...$$ 公式通过 remark-math + rehype-katex 渲染Milkdown 数学插件 —— 预览编辑器通过 @milkdown/plugin-math 原生渲染数学公式自动检测 —— 裸 \begin{aligned} 等 LaTeX 环境自动补上 $$ 定界符Unicode 降级 —— 100+ 符号映射(α, ∑, →, ≤ 等)用于数学块外的简单行内符号Mermaid 代码块 —— fenced mermaid 代码块可直接渲染为流程图、时序图等 Mermaid 支持的图表紧凑 Mermaid 错误 —— 语法错误会被收敛到小型错误卡片中,不会把原始解析器输出铺满聊天界面
12. 审核系统(异步人机协作) 原始设计建议在摄入时全程参与。我们新增了异步审核队列 :
LLM 在摄入过程中标记需要人工判断的项目
预定义操作类型 :创建页面、深度研究、跳过 —— 约束操作防止 LLM 凭空生成任意操作摄入时生成搜索查询 —— LLM 预先为每个审核项生成优化的网络搜索查询用户可在方便时处理审核 —— 不阻塞摄入流程
13. 深度研究
网络搜索 支持 Tavily、SerpApi 或 SearXNG,查找相关资料并返回完整内容(非截断摘要)Provider 独立配置 —— Tavily 和 SerpApi 使用各自 API Key;SerpApi 支持选择搜索引擎,SearXNG 使用实例 URL 和搜索分类多条搜索查询 —— 摄入时由 LLM 生成,针对搜索引擎优化LLM 智能主题生成 —— 从图谱洞察触发时,LLM 读取 overview.md + purpose.md 生成领域精准的研究主题和查询(非泛泛关键词)用户确认对话框 —— 研究主题和搜索查询可编辑,确认后才开始研究LLM 综合 搜索结果生成 Wiki 研究页面,并交叉引用现有 Wiki思维链展示 —— 综合过程中 <think> 块显示为可折叠区域,自动滚动到最新内容自动摄入 —— 研究结果自动进入两步摄入流程,提取实体/概念到 Wiki任务队列 —— 最多 3 个并发任务研究面板 —— 专用侧边面板,动态高度,实时流式进度
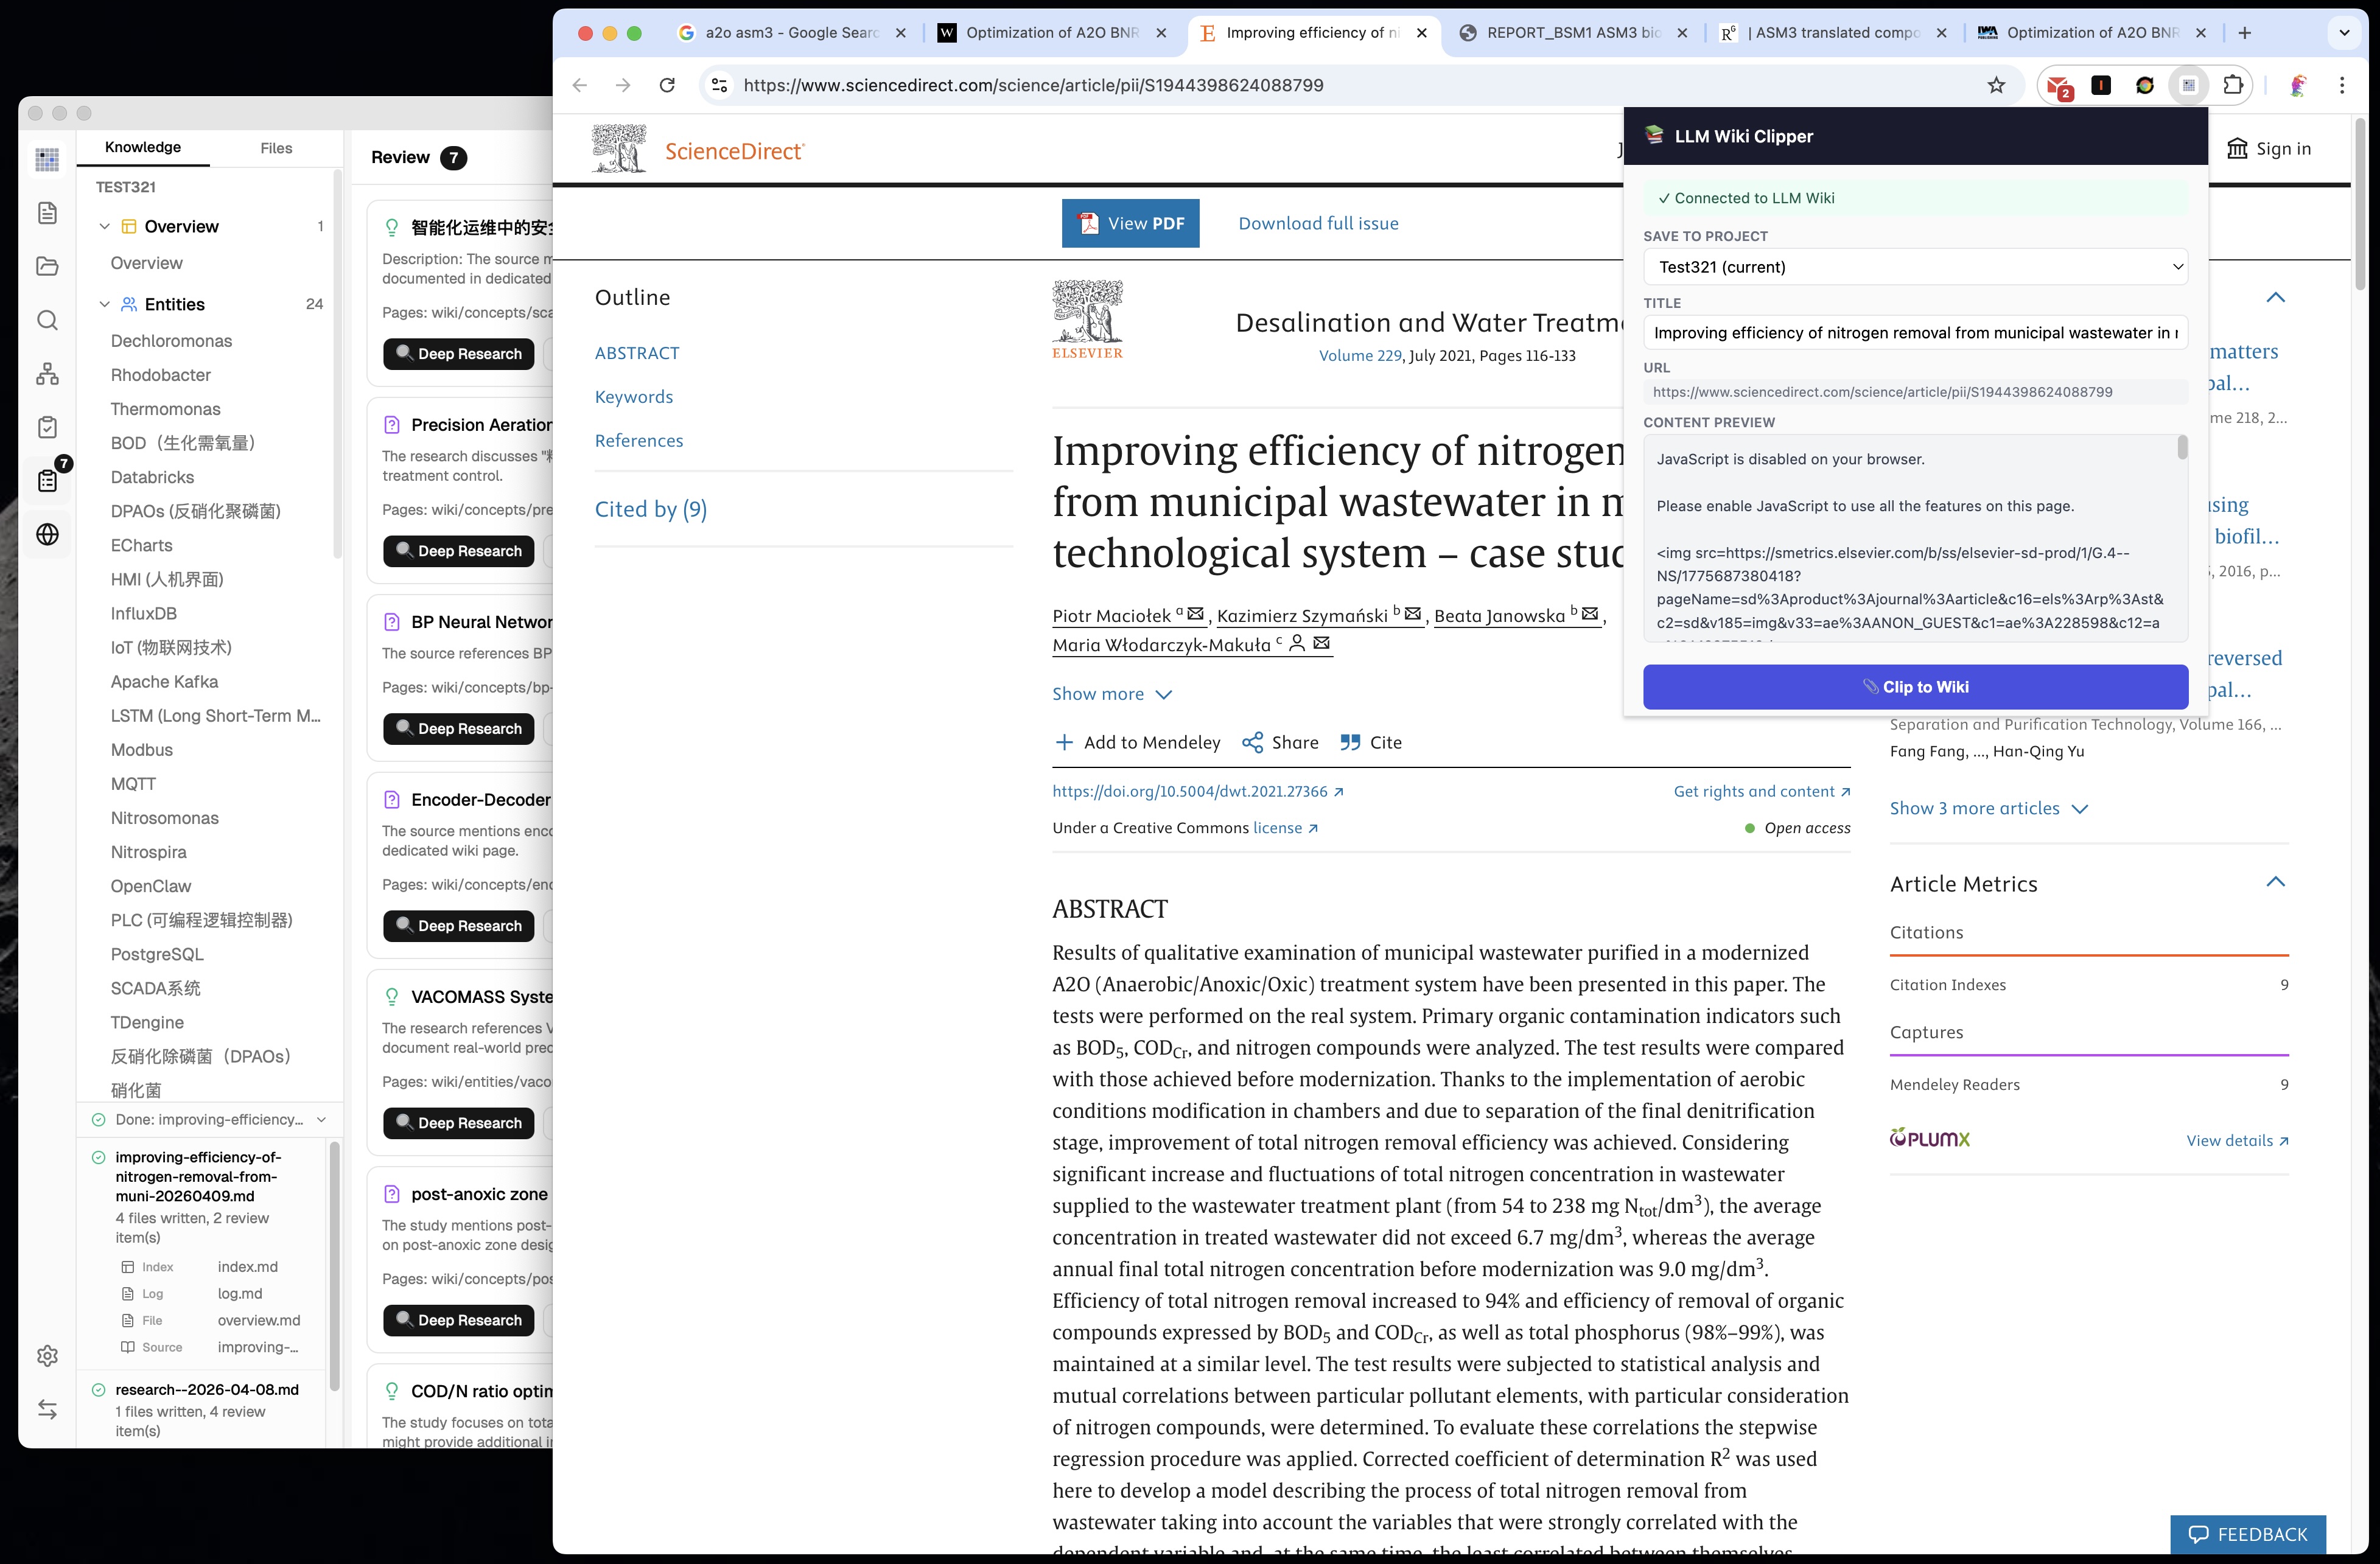
14. 浏览器扩展(网页剪藏) 原始设计提到了 Obsidian Web Clipper。我们构建了专用 Chrome 扩展 (Manifest V3):
Mozilla Readability.js 精确提取文章内容(去除广告、导航、侧边栏)Turndown.js 将 HTML 转换为 Markdown,支持表格项目选择器 —— 选择剪藏到哪个 Wiki(支持多项目)本地 HTTP API (端口 19827,tiny_http)—— 扩展 ↔ 应用通信自动摄入 —— 剪藏内容自动触发两步摄入流程剪藏监听 —— 每 3 秒轮询新剪藏,自动处理离线预览 —— 即使应用未运行也能显示提取的内容
15. 多格式文档支持 原始设计聚焦于纯文本/Markdown。我们支持保留文档语义的结构化提取:
MinerU 是可选功能。复杂 PDF 可使用 MinerU 云端、官方 Local API 或本地 Pipeline 模式;本地模式无需上传文件,提取的图片会保存到项目管理的 wiki/media 目录。若 MinerU 失败,LLM Wiki 会回退到内置解析器。
16. 文件删除级联清理
删除资料文件时同时移除其 Wiki 摘要页面
三重匹配 查找相关 Wiki 页面:frontmatter sources[] 字段、资料摘要页面名称、frontmatter 章节引用共享实体保护 —— 链接到多个资料的实体/概念页面仅从其 sources[] 数组中移除被删除的资料,而非删除整个页面索引清理 —— 被移除的页面从 index.md 中清除Wiki 链接清理 —— 指向已删除页面的失效 [[wikilinks]] 从其余 Wiki 页面中移除
17. 可配置上下文窗口 原始设计中没有。用户可配置 LLM 接收多少上下文:
4K 到 1M tokens 滑块 —— 适配不同 LLM 的能力比例预算分配 —— 更大的窗口按比例获得更多 Wiki 内容60/20/5/15 分配 —— Wiki 页面 / 聊天历史 / 索引 / 系统提示
18. 跨平台兼容 原始设计与平台无关(抽象模式)。我们处理了具体的跨平台问题:
路径规范化 —— 统一的 normalizePath() 在 22+ 个文件中使用,反斜杠 → 正斜杠Unicode 安全字符串处理 —— 基于字符而非字节的切片(防止中文文件名导致崩溃)macOS 关闭隐藏 —— 关闭按钮隐藏窗口(程序后台运行),点击 Dock 图标恢复,Cmd+Q 退出Windows/Linux 关闭确认 —— 关闭时弹出确认对话框,防止误操作导致数据丢失Tauri v2 —— macOS、Windows、Linux 原生桌面GitHub Actions CI/CD —— 自动构建 macOS(ARM + Intel)、Windows(.msi)、Linux(.deb / .AppImage)
19. 其他新增
国际化 —— 中英文界面(react-i18next)设置持久化 —— LLM 提供商、API 密钥、模型、上下文大小、语言通过 Tauri Store 保存Obsidian 配置 —— 自动生成 .obsidian/ 目录及推荐设置Markdown 渲染 —— 带边框的 GFM 表格、代码块、聊天和预览中的 wikilink 处理多 LLM 提供商 —— OpenAI、Anthropic、Google、Ollama、自定义 —— 各有特定的流式传输和请求头可配置 LLM 超时 —— 可针对较慢的本地模型和长任务调整请求超时可配置 Firecrawl —— 支持可选 API Key 和自定义 Base URL,可连接托管或自部署服务可折叠文件侧栏 —— 可收起 Knowledge/Files 导航并保存折叠状态项目维护 —— 支持 ZIP 导入导出迁移和确定性重建 wiki/index.mddataVersion 信号 —— 图谱和 UI 在 Wiki 内容变更时自动刷新
技术栈
安装
预编译二进制文件
macOS :.dmg(Apple Silicon + Intel)Windows :.msiLinux :.deb / .AppImage
从源码构建 # 前置条件:Node.js 20+, Rust 1.88+, protoc
# macOS: brew install protobuf
# Linux: sudo apt install protobuf-compiler
# Windows:choco install protoc
git clone https://github.com/nashsu/llm_wiki.git
cd llm_wiki
npm install
npm --prefix mcp-server ci && npm run mcp:build # mcp-server/dist 会作为 Tauri 资源打包
npm run tauri dev # 开发模式
npm run tauri build # 生产构建
Chrome 扩展
打开 chrome://extensions
启用「开发者模式」
点击「加载已解压的扩展程序」
选择 extension/ 目录
使用 Alt+Shift+L(macOS 为 Command+Shift+L)直接剪藏当前页面;可在 chrome://extensions/shortcuts 中自定义快捷键
快速开始
启动应用 → 创建新项目(选择模板)
进入 设置 → 配置 LLM 提供商(API 密钥 + 模型)
可选:在 设置 中配置网络搜索 Provider 和 source 文件夹自动监听
进入 资料源 → 导入文档(PDF、DOCX、MD 等)
观察 活动面板 —— LLM 自动构建 Wiki 页面
使用 聊天 查询你的知识库
浏览 知识图谱 查看关联
查看 审核 处理需要你关注的项目
定期运行 Lint 维护 Wiki 健康度
本地 HTTP API + MCP Server + AI Agent Skill LLM Wiki 内置一个本地 HTTP API(监听 http://127.0.0.1:19828,Token 鉴权,仅本机可达),任何外部工具——包括 Claude Code 、Codex 这类 AI Agent,或者任意能发 HTTP 请求的脚本——都可以直接查询你的知识库:
GET /api/v1/health —— 服务状态(无需鉴权)GET /api/v1/projects —— 项目列表GET /api/v1/projects/{id}/files / files/content —— 读取文件树与内容POST /api/v1/projects/{id}/search —— Hybrid 混合检索 (关键词 + 向量),返回 mode、tokenHits、vectorHits,每条结果带 vectorScorePOST /api/v1/projects/{id}/chat —— 非流式 Rust 后端 Agent 聊天接口,返回助手消息、引用、用量和工具事件;支持 Wiki/Source/Web/AnyTXT 检索,mode: "deep" 会扩展证据收集范围GET /api/v1/projects/{id}/graph —— Wikilinks 知识图谱POST /api/v1/projects/{id}/sources/rescan —— 触发后端重新扫描POST /api/v1/projects/{id}/pages/embed —— 为外部创建或更新的单个 wiki/*.md 页面建立向量索引,无需重建整个向量数据库 在 设置 → API + MCP 中开启 API、生成 Token,并按需选择是否允许本机无鉴权访问。
对于兼容 MCP 的客户端,LLM Wiki 还内置了 mcp-server/。执行 npm run mcp:build 构建后,设置 → API + MCP 会展示一份可复制的 MCP 客户端配置,并自动填入当前机器上的真实入口路径。MCP 工具复用同一套 API 能力,因此 Agent 可以直接列出项目、读取文件、执行 Hybrid 检索、查看图谱、触发资料源重新扫描,并调用同一套 Rust 后端 Agent 聊天接口,不需要再手写 HTTP 调用。
一条命令把 AI Agent 接进你的知识库 LLM Wiki 配套的 agent skill 单独维护在另一个仓库。把它装进 Claude Code / Codex / 任意兼容 skills 的 runtime:
npx skills add https://github.com/nashsu/llm_wiki_skill.git --skill llm-wiki
安装完成后,Agent 就能响应 "我的 LLM Wiki 里关于 X 是怎么说的"、"在我的知识库里搜 Y"、"展示我 wiki 图谱里 Z 的邻居"、"重新索引我的资料源" 等请求——直接调用本机运行的 App,默认只读,引用 wiki 页面路径方便你在 App 内核对。
项目结构 my-wiki/
├── purpose.md # 目标、关键问题、研究范围
├── schema.md # Wiki 结构规则、页面类型
├── raw/
│ ├── sources/ # 上传的文档(不可变)
│ └── assets/ # 本地图片
├── wiki/
│ ├── index.md # 内容目录
│ ├── log.md # 操作历史
│ ├── overview.md # 全局概要(自动更新)
│ ├── entities/ # 人物、组织、产品
│ ├── concepts/ # 理论、方法、技术
│ ├── sources/ # 资料摘要
│ ├── queries/ # 保存的聊天回答 + 研究
│ ├── synthesis/ # 跨资料分析
│ └── comparisons/ # 并列对比
├── .obsidian/ # Obsidian 仓库配置(自动生成)
└── .llm-wiki/ # 应用配置、聊天历史、审核项
Star History
许可证 本项目基于 GNU 通用公共许可证 v3.0 授权 —— 详见 LICENSE 。
09.08