跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签2视频配音2开源1扩散模型1流式生成1声音克隆1视频生成1数字人1文本转语音1音频驱动1语音识别1字幕生成1AI音频处理1

项目搜索结果

找到 2 个项目

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

InfiniteTalk README 配图
内容创作GitHub 项目

InfiniteTalk

音频驱动的无限长说话视频生成框架

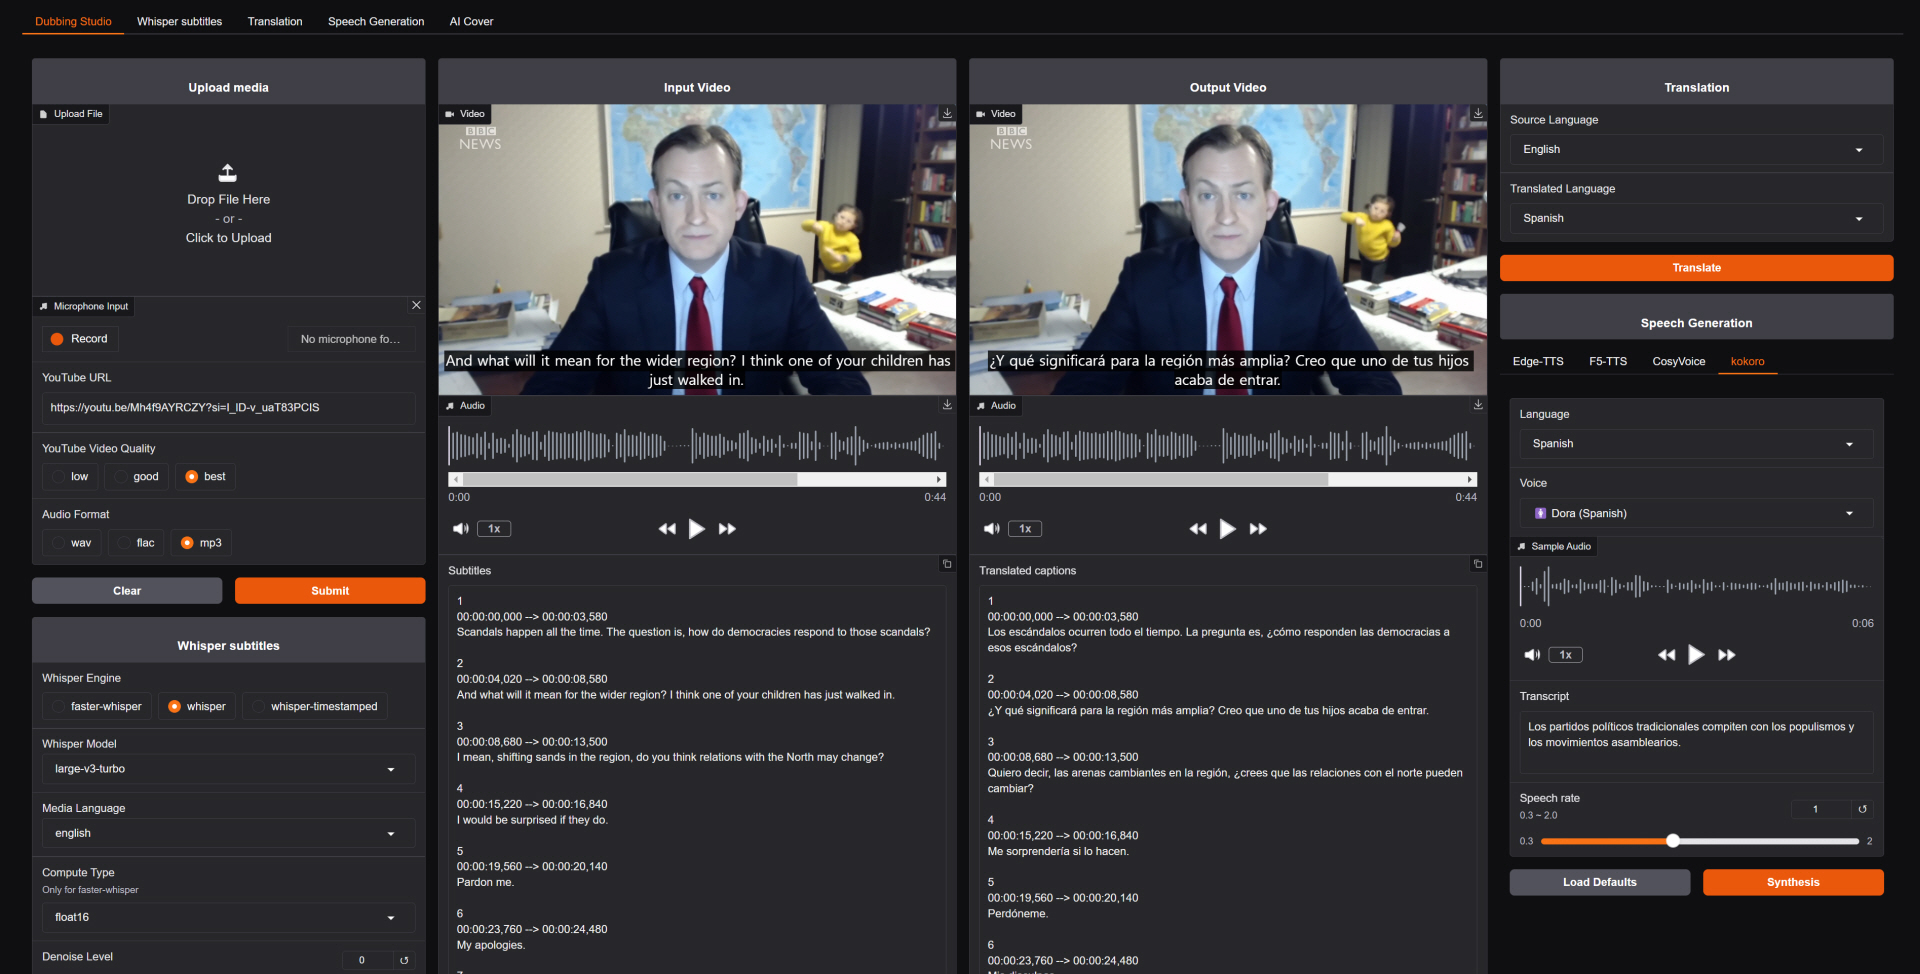
InfiniteTalk 是美团 MeiGen-AI 团队于 2025 年 8 月开源的音频驱动无限长说话视频生成框架,全称 "Audio-driven Video Generation for Sparse-Frame Video Dubbing"。它提出了一种新型视频配音范式——"稀疏帧视频配音",通过保留原始视频的关键参考帧,在维持身份信息、标志性手势和摄像机轨迹的同时,对全身运动进行音频同步的编辑。给定一段源视频和目标音频,可生成与音频精确口型同步、头部/身体/表情联动的全新视频;给定一张人物图片和音频,可从零生成无限长的说话人视频。支持 480P 和 720P 分辨率,默认最大 1000 帧/40 秒,可流式扩展。底层基于扩散模型构建,使用 Wan2.1-I2V-14B 作为视频生成基座,音频编码器采用 Wav2Vec2。项目以 Apache-2.0 许可证开源。

扩散模型流式生成视频配音
09.08
Voice-Pro README 配图
内容创作GitHub 项目

Voice-Pro

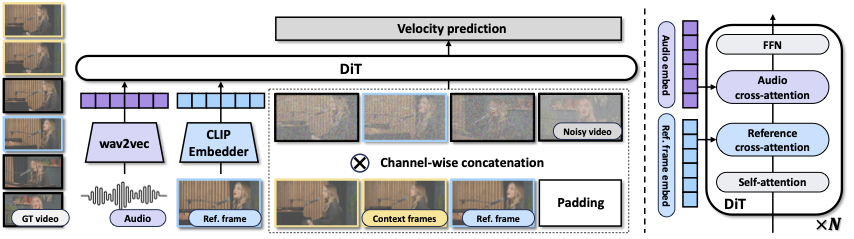
一站式 AI 语音工作台,从视频下载到多语言配音全流程自动化

Voice-Pro 是一款面向创作者和开发者的 AI 音频全流程处理工具,由韩国创业公司 ABUS 开发,基于 Gradio WebUI 构建。它将视频下载、音频分离、语音识别、多语言翻译、文本转语音(TTS)和零样本声音克隆集成到一个统一的 Web 界面中,定位为 ElevenLabs 的开源替代方案。核心价值在于将传统需要 5-8 个工具配合的流程(下载、分离、识别、翻译、配音、字幕)串联成一条自动化管道,用户只需输入视频链接,即可获得多语言配音视频和字幕。工具支持四种 Whisper 变体用于语音识别,三种零样本声音克隆引擎(F5-TTS、E2-TTS、CosyVoice),以及 Edge-TTS、kokoro 等多语言 TTS。完全开源免费,本地运行,数据不出机器。需要 NVIDIA GPU(最低 4GB 显存,推荐 8GB+),首次部署需下载模型,耗时较长。

开源声音克隆视频配音
09.08