video-use
让 LLM 通过文本转录而非逐帧图像来理解和编辑视频的开源工具
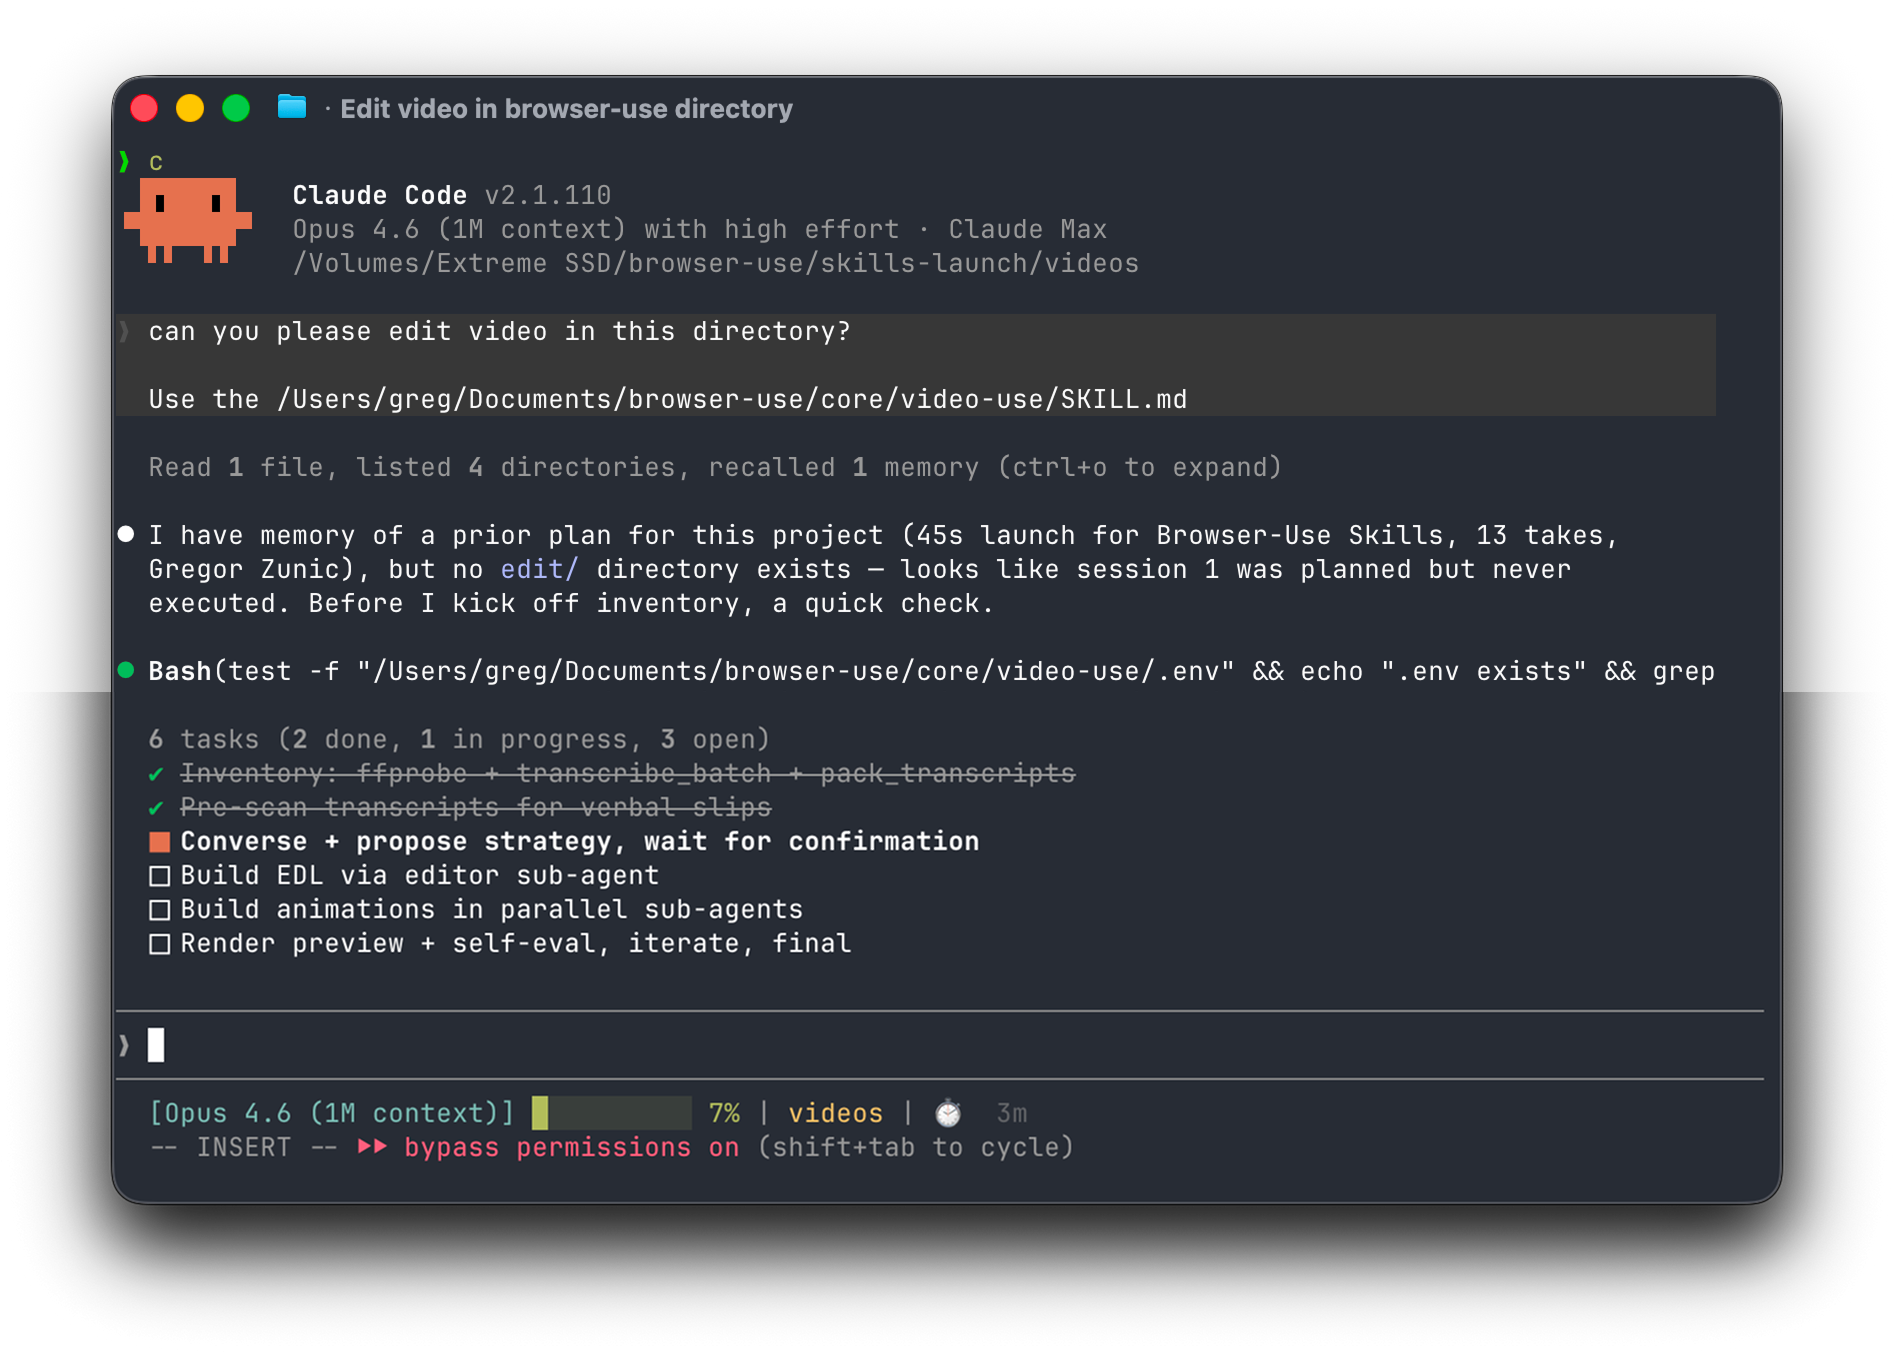
video-use 是由 browser-use 团队开源的 LLM 驱动视频编辑工具,专为 Claude Code 设计。其核心理念是让 LLM "读"视频而不是"看"视频,通过音频转录和按需可视化,将原始视频素材压缩为约 12KB 的文本摘要,再由 Claude Code 进行对话式剪辑决策。该工具主要解决传统视频编辑流程中人工操作链条长、视频对 LLM 不可读、填充词检测依赖人工或粗粒度工具、跨镜头一致性难以保证以及动画/字幕叠加工程复杂度高等痛点。其工作流程包括素材盘点、预扫描问题、对话交互、策略确认、执行、渲染和自评估。项目包含 12 条硬规则以确保生产正确性,并支持通过并行子 Agent 生成动画。该工具适用于口播视频、教程、采访等"说话为主"的内容,不适用于音乐 MV、体育赛事剪辑、电影级特效合成等场景。
09.08