项目概览
video-use 是由 browser-use 团队开源的 LLM 驱动视频编辑工具,专为 Claude Code 设计。其核心理念是让 LLM "读"视频而不是"看"视频,通过音频转录和按需可视化,将原始视频素材压缩为约 12KB 的文本摘要,再由 Claude Code 进行对话式剪辑决策。该工具主要解决传统视频编辑流程中人工操作链条长、视频对 LLM 不可读、填充词检测依赖人工或粗粒度工具、跨镜头一致性难以保证以及动画/字幕叠加工程复杂度高等痛点。其工作流程包括素材盘点、预扫描问题、对话交互、策略确认、执行、渲染和自评估。项目包含 12 条硬规则以确保生产正确性,并支持通过并行子 Agent 生成动画。该工具适用于口播视频、教程、采访等"说话为主"的内容,不适用于音乐 MV、体育赛事剪辑、电影级特效合成等场景。
解决什么问题
传统视频编辑流程高度依赖人工操作和视觉判断,存在多个结构性痛点。首先,视频对 LLM 来说是"不可读"的,一段 10 分钟 1080p 视频约 18,000 帧,若每帧用 1,500 token 描述,总计约 2700 万 token 的噪音,远超任何模型的上下文窗口。其次,人工操作链条太长,一次简单的"去填充词 + 加字幕"需要浏览、标记、剪切、预览、微调、调色、烧字幕、导出等多个环节。第三,填充词检测依赖"听",传统做法要么靠人工逐段听,要么用 Whisper 等工具做粗粒度转录,但 Whisper 的 SRT 模式会丢失亚秒级间隙数据,且会"归一化"填充词,导致编辑信号丢失。第四,跨镜头一致性难以保证,多个片段拼接时,调色一致性、音频过渡平滑度、字幕对齐都需要精细调整。第五,动画/字幕叠加的工程复杂度高,ffmpeg 的 filtergraph 链条复杂,任何一个细节出错都会导致"静默失败"。
工作方式
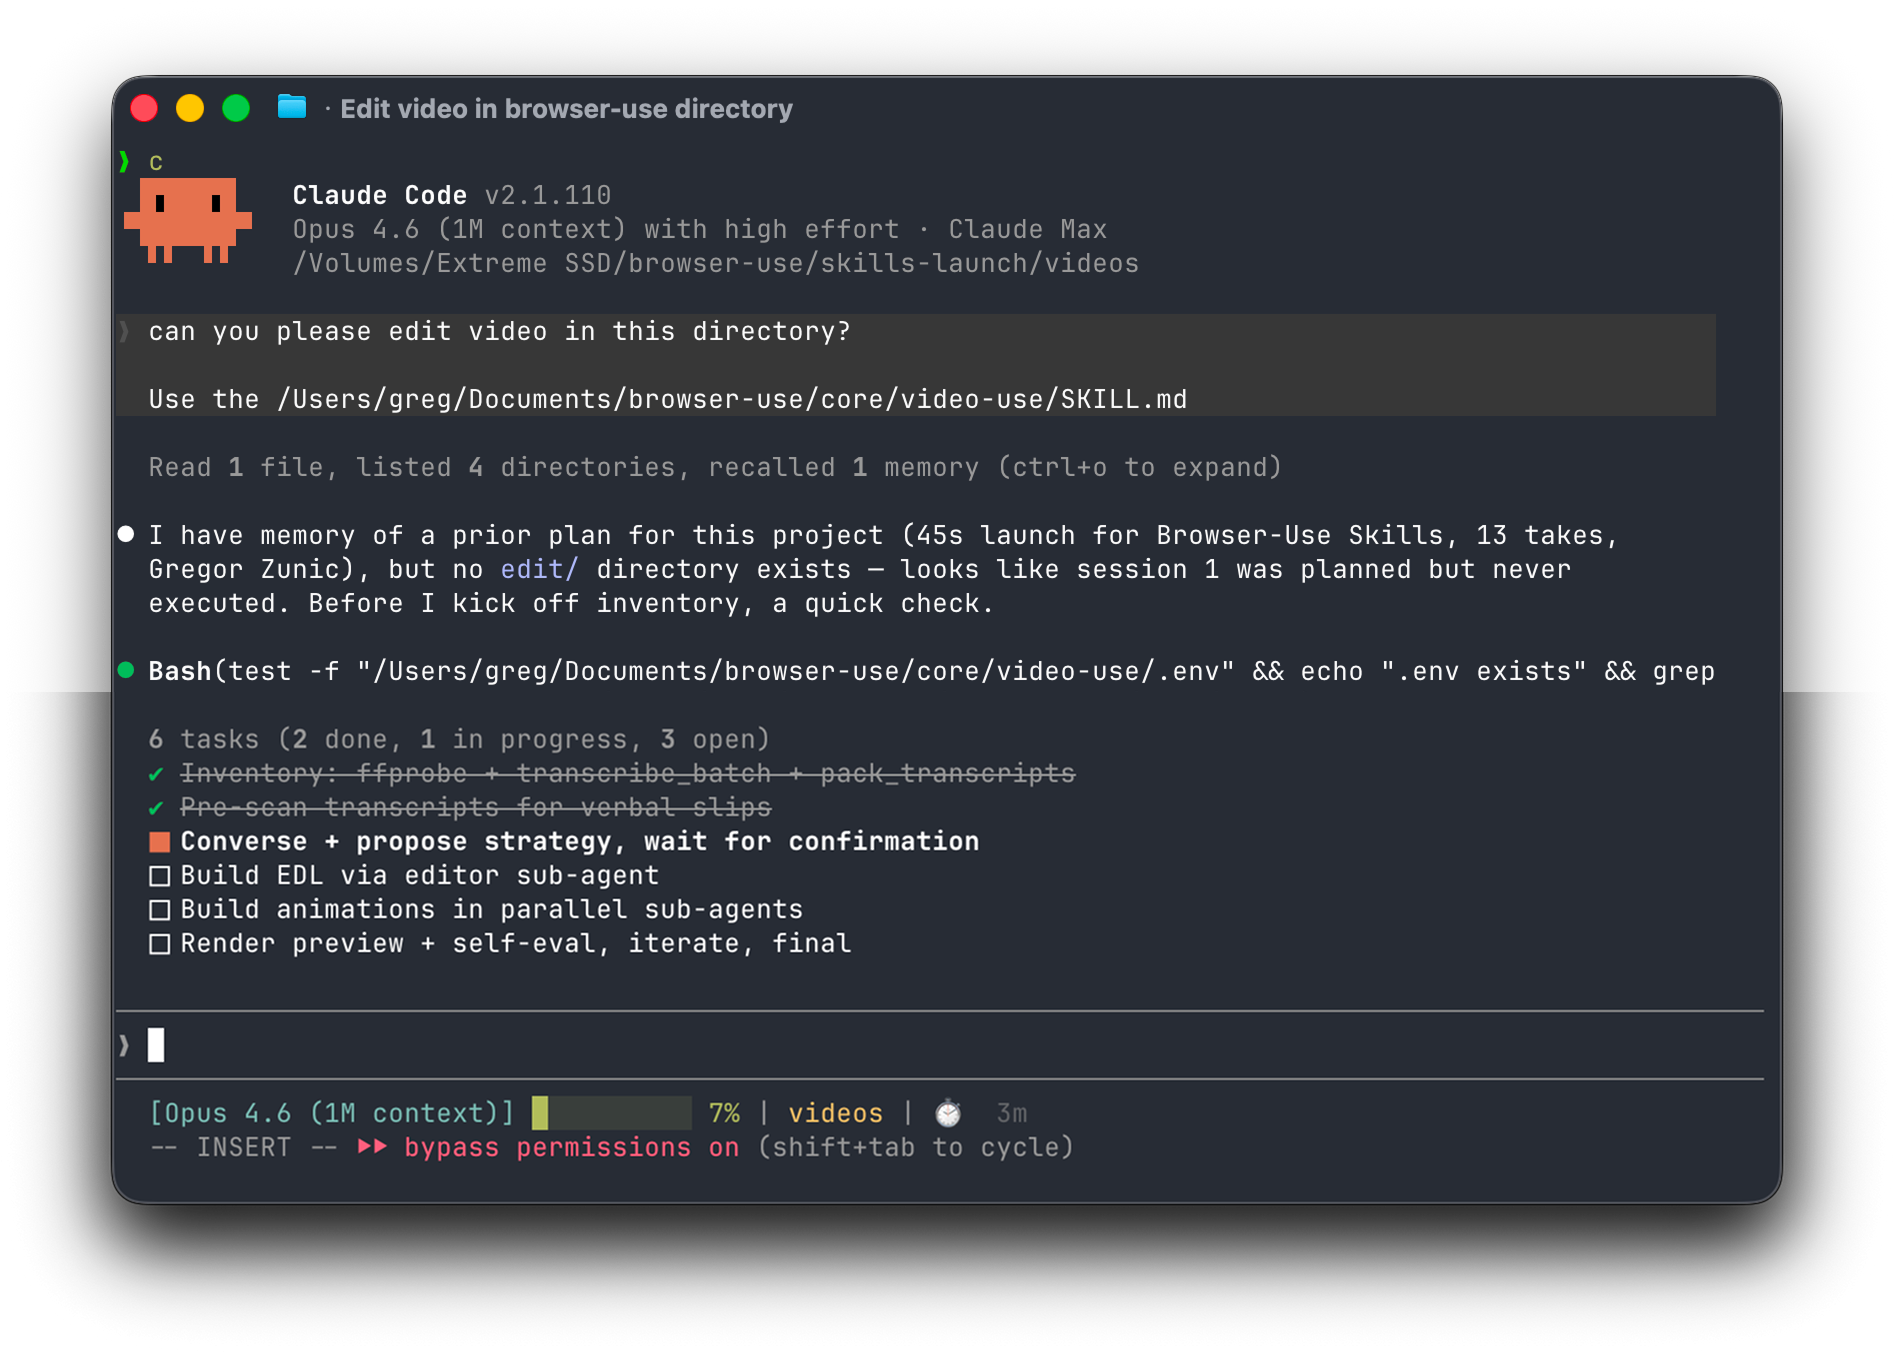
video-use 的核心创新在于给 LLM 提供了一个结构化的视频表示,而非原始帧数据,采用双层信息架构。Layer 1 是音频转录(始终加载),通过 ElevenLabs Scribe API 对每个原始素材进行一次转录,获得词级时间戳、说话人分离和音频事件标记,所有素材打包成一个 takes_packed.md,约 12KB,作为 LLM 的主阅读面。Layer 2 是视觉合成图(按需加载),timeline_view 工具可以为任意时间范围生成一张 PNG 图,包含胶片条、音频波形、词标签和静默间隙的剪切候选标记,只在需要决策时才调用。工作流程包括:素材盘点(ffprobe 检测源文件、transcribe_batch.py 4 worker 并行转录、pack_transcripts.py 生成 takes_packed.md)、预扫描问题(标记口误、错话)、对话交互(用自然语言描述内容并基于素材问问题)、策略确认(输出 4-8 句策略描述,等待用户确认后才执行)、执行(生成 edl.json、并行子 Agent 构建动画、逐段应用调色)、渲染和自评估(对渲染输出的每个切点 ±1.5s 窗口检查视觉不连续、音频波形尖峰、字幕遮挡、叠加层错位,最多 3 轮)。
核心能力
- 文本 + 按需可视化,不逐帧倾倒
- 音频优先,视觉跟随,剪切候选来自语音边界和静默间隙
- Ask → confirm → execute → self-eval → persist 流程
- 零内容类型假设,不预设视频类型
- 条硬规则保证生产正确性
- 自评估循环,每个切点都检查
- 会话记忆通过 project.md 持久化
- 动画通过并行子 Agent 生成
- 支持自定义调色 filter
- 完全开源,无 vendor lock-in
使用前需要了解
- AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
- 根据报告,video-use 适合口播视频(去填充词 + 加字幕)、多次拍摄选最佳 take、教程/课程视频剪辑、采访/播客后期、自动调色 + 字幕烧录等场景。不适合电影级特效合成、音乐 MV(节奏高度依赖视觉韵律)、体育赛事剪辑、需要大量 3D 特效的场景、对画面精度要求极高的广告片。其局限包括:不处理实时视频(只处理已有素材文件)、不处理音频混音(专注于剪切和字幕)、不处理 3D(纯 2D 处理)、输出格式有限(支持常见格式,但不支持特殊编解码器)。此外,转录依赖 ElevenLabs Scribe API,需要付费账号;目前仅支持 Claude Code 的 Skill 机制;项目仅 7 个 commit,还在早期阶段。报告未说明具体的开源许可协议。