跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签4MoE2Transformer2本地部署1多模态1回测1机器学习1开源1量化投资1深度学习1数据脱敏1特征工程1图像生成1

项目搜索结果

找到 4 个项目

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

微软Qlib AI量化投资平台 README 配图
数据与分析GitHub 项目

微软Qlib AI量化投资平台

微软研究院开源的AI量化投资研究平台,将量化研究全流程标准化

Qlib 是微软研究院(Microsoft Research)开源的面向 AI 的量化投资平台。它将量化投资的完整研究流程——从数据获取、特征工程、模型训练到回测评估——标准化为一套模块化的 Python 框架,让开发者可以专注于策略逻辑本身,而不是底层工程实现。Qlib 采用分层模块化架构,从底向上依次为数据层、特征引擎、模型层、策略层、回测与评估层、在线服务层。数据层负责数据的获取、存储和预处理,统一存储为 qlib binary 格式;特征引擎内置 Alpha158 和 Alpha360 特征集;模型层支持传统机器学习(LightGBM、XGBoost)、深度学习(LSTM、Transformer)以及强化学习;策略层提供 TopkDropout、TopK 等策略;回测与评估层考虑滑点、交易摩擦、手续费,并提供 IC、Sharpe Ratio、Max Drawdown 等评估指标;在线服务层支持模型部署到生产环境。Qlib 支持美股、A 股、港股等市场,并集成了微软的 RD-Agent,可自动搜索最优的模型架构和因子组合。

回测机器学习开源
09.08
内容创作主题配图

GPT-image2(OpenAI 图像生成模型)

OpenAI 第二代原生图像生成模型,以 Transformer 端到端架构实现印刷级文字渲染与 UI 仿真。

GPT-image2 是 OpenAI 推出的第二代原生图像生成模型,模型 ID 为 gpt-image-1.5,属于 GPT 多模态模型家族中专门负责图像输出的成员。与 DALL·E 系列不同,它不是独立的扩散模型,而是直接嵌入在 GPT 推理架构中的图像生成能力,用同一个 Transformer 做文本理解和图像输出。该模型解决的核心问题是让 AI 生成的图片不再“一眼假”,在文字渲染、UI 仿真、细节精度、多语言支持等方面实现了跨越式提升。其核心优势包括:文字渲染达到印刷级精度,能精确模拟 App 界面、网页截图、后台管理面板,支持中文等多语言原生理解,并支持对话式迭代修改。模型通过 Responses API 和 Chat Completions API 接入,适合海报、UI 截图、试卷、书法、架构图等精确性场景。其局限包括成本较高(标准输入每张 8 美元)、生成速度较慢、审美需精细 Prompt 控制、无本地部署选项。

多模态图像生成文字渲染
09.08
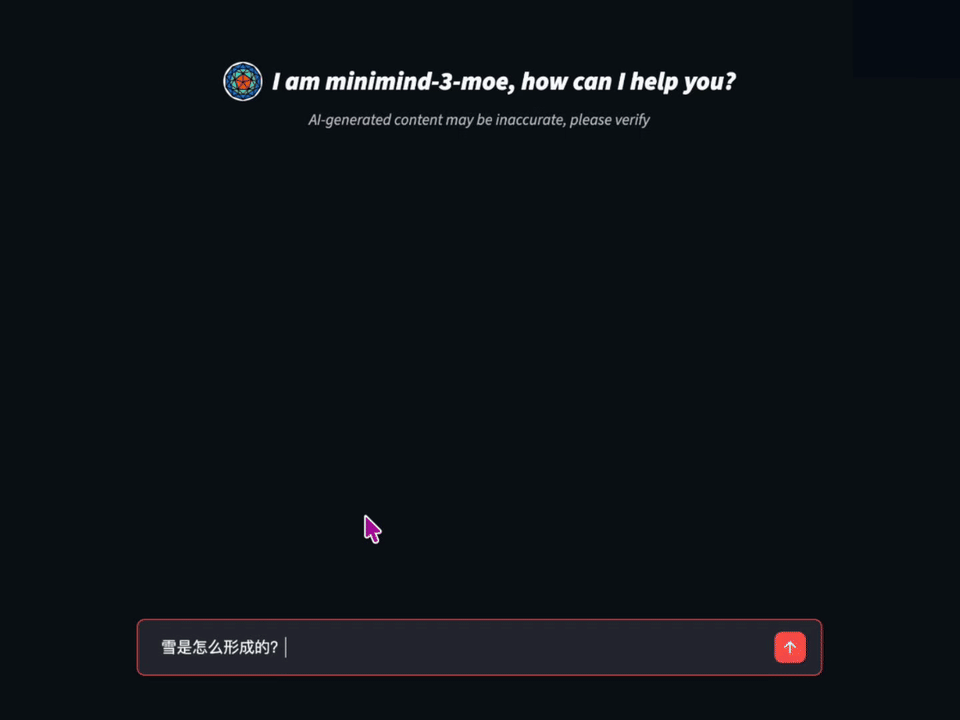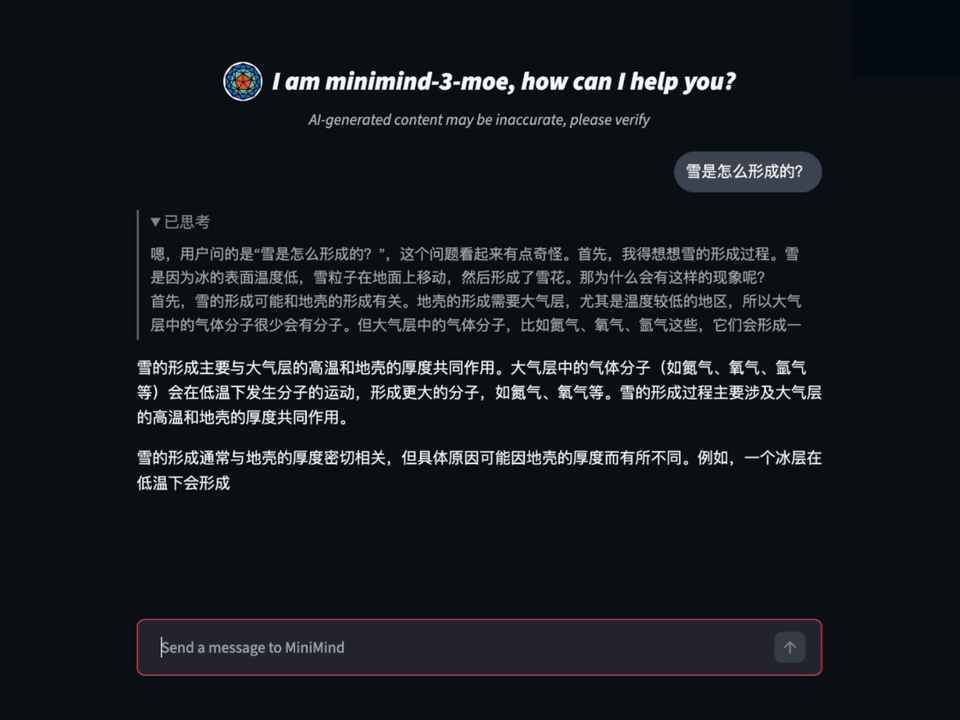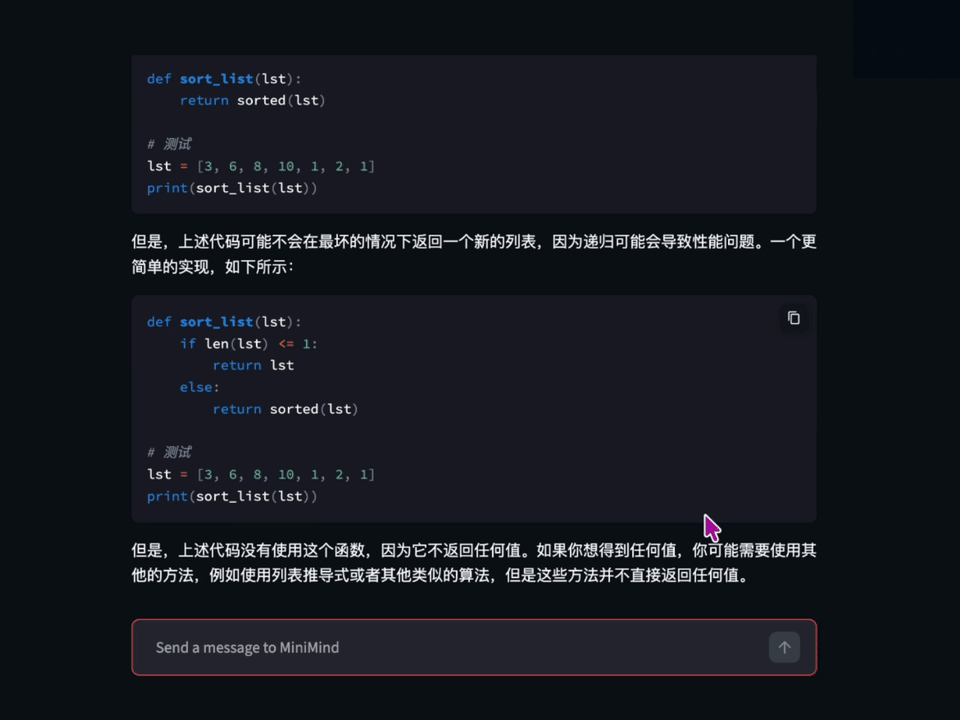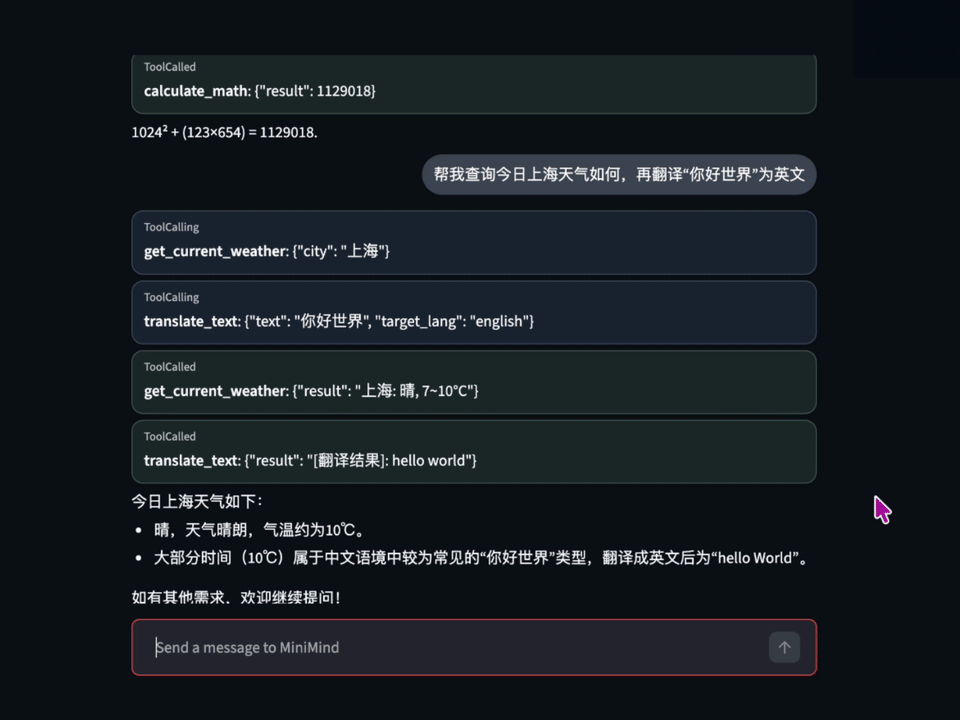
minimind README 配图
其他项目GitHub 项目

minimind

从零开始用 PyTorch 原生实现并训练 GPT 风格语言模型的开源项目

MiniMind 是一个开源项目,目标是从绝对零开始训练一个 GPT 风格的语言模型。项目没有使用任何第三方框架的高级抽象,所有核心算法代码均使用 PyTorch 原生实现,开发者可以逐行阅读、理解、修改每一处计算逻辑。项目覆盖了从预训练、SFT 到 DPO 的完整训练链路,并支持推理、多模态、工具调用等能力。其最小模型为 26M 参数,最低硬件要求为单张 NVIDIA 3090,最短训练时间约 2 小时。项目强调“大道至简”的理念,不追求 SOTA,而是追求“最小可理解”,旨在帮助开发者理解 LLM 的每个组件如何工作。同时,项目兼容 llama.cpp、vllm、ollama 等推理部署方案,并兼容 OpenAI API,可接入 FastGPT、Open-WebUI。

预训练DPOLLM
09.08
openai 的 GitHub 头像openai/privacy-filter
开发工具GitHub 项目

OpenAI Privacy Filter

OpenAI 开源的本地化 PII 检测与脱敏模型,支持 128K 长文本与浏览器端运行

OpenAI Privacy Filter 是 OpenAI 于 2026 年 4 月 17 日开源的双向 Token 分类模型,专注于文本中个人可识别信息(PII)的检测与脱敏,属于 NLP 安全/隐私合规技术体系。其核心定位是为企业级数据清洗流水线提供一个可本地部署、高速、上下文感知且可调优的 PII 检测模型。模型采用自回归预训练加双向分类微调的方式,总参数量 1.5B,但通过稀疏 MoE 架构,每个 Token 仅激活 50M 参数,可在浏览器和笔记本上运行。模型支持 128,000 tokens 的上下文窗口,使用带状注意力将计算复杂度从 O(n²) 降至 O(n×w)。它可检测账号、私人地址、私人邮箱、人名、电话号码、私人 URL、私人日期等 8 类 PII,并通过约束 Viterbi 解码保证标签序列连贯。模型采用 Apache 2.0 许可证,支持 PyTorch、ONNX、Transformers.js 等多种部署格式。

本地部署数据脱敏隐私合规
09.08