跳到主要内容
微软Qlib AI量化投资平台 · prolist
查看仓库原始简介 Qlib is an AI-oriented Quant investment platform that aims to use AI tech to empower Quant Research, from exploring ideas to implementing productions. Qlib supports diverse ML modeling paradigms, including supervised learning, market dynamics modeling, and RL, and is now equipped with https://github.com/microsoft/RD-Agent to automate R&D process.
来自项目 README 项目解读 README
项目解读由 AI 根据历史资料整理,尚未经人工复核。仓库资料更新于 2026-09-08,与历史解读分开保留。
项目概览 Qlib 是微软研究院(Microsoft Research)开源的面向 AI 的量化投资平台。它将量化投资的完整研究流程——从数据获取、特征工程、模型训练到回测评估——标准化为一套模块化的 Python 框架,让开发者可以专注于策略逻辑本身,而不是底层工程实现。Qlib 采用分层模块化架构,从底向上依次为数据层、特征引擎、模型层、策略层、回测与评估层、在线服务层。数据层负责数据的获取、存储和预处理,统一存储为 qlib binary 格式;特征引擎内置 Alpha158 和 Alpha360 特征集;模型层支持传统机器学习(LightGBM、XGBoost)、深度学习(LSTM、Transformer)以及强化学习;策略层提供 TopkDropout、TopK 等策略;回测与评估层考虑滑点、交易摩擦、手续费,并提供 IC、Sharpe Ratio、Max Drawdown 等评估指标;在线服务层支持模型部署到生产环境。Qlib 支持美股、A 股、港股等市场,并集成了微软的 RD-Agent,可自动搜索最优的模型架构和因子组合。
解决什么问题 量化研究的核心链条很长:数据获取 → 清洗 → 特征计算 → 模型训练 → 回测 → 评估。每个环节都有大量工程工作,Qlib 把这条链路彻底标准化,让研究者专注于"用什么模型、什么特征、什么策略"。传统量化研究存在重复造轮子、缺乏标准化、实验效率低、工程与研究的冲突、回测不严谨等核心痛点。微软研究院在量化投资领域有多年积累,他们将内部使用的量化基础设施整理后开源,Qlib 的设计理念来自生产环境的实际需求,而非学术 Demo。
工作方式 Qlib 采用分层模块化架构,从底向上依次为:数据层(Data Layer)负责数据的获取、存储和预处理,数据统一存储为 qlib binary 格式,支持 Yahoo Finance、CSI(中证)、自定义数据源;特征引擎(Feature Engine)内置 Alpha158 和 Alpha360 特征集,支持自定义特征;模型层(Model Layer)支持传统 ML(LightGBM、XGBoost、Linear Model)、深度学习(LSTM、Transformer、GRU、TCN)、强化学习(DRL 策略),并支持 PyTorch/TensorFlow 的任意模型接入;策略层(Portfolio/Strategy Layer)提供 TopkDropout、TopK 策略,可编写信号到仓位的映射逻辑;回测与评估层(Backtesting & Evaluation)提供专业级回测引擎,考虑滑点、交易摩擦、手续费,评估指标包括 IC、Rank IC、Sharpe Ratio、Max Drawdown、年化收益率;在线服务层(Online Serving)将训练好的模型部署到生产环境。Qlib 的核心执行单元是 Workflow,它将六层串联成一个完整的执行流水线:Data Handler → Dataset → Model → Strategy → Backtest。
核心能力
端到端标准化:从数据到回测的全链路标准化,减少重复工程工作
AI 原生设计:原生支持 ML/DL/RL 多种建模范式
内置 Alpha158(158 个因子)和 Alpha360(360 个因子)标准因子集
丰富的预置模型:LightGBM、LSTM、Transformer、TST 等开箱即用
专业级回测引擎:考虑滑点、手续费、涨跌停限制
多市场支持:A 股、美股、港股等
支持自定义模型:可接入 PyTorch/TensorFlow 任意模型
支持自定义特征:通过 DataFrame 表达式定义因子
集成 RD-Agent:支持自动化量化研究,自动搜索模型架构和因子组合
支持在线部署:训练好的模型可直接用于在线预测
使用前需要了解
AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
Qlib 是研究平台,不是交易系统,不包含下单、风控、仓位管理等实盘交易功能。回测结果和实盘收益之间有巨大差距(滑点、冲击成本、流动性等)。AI 模型在量化领域极易过拟合,需要严格的样本外测试。数据质量决定策略上限。Qlib 本身不提供实时数据源。学习曲线较陡,概念多(DataHandler、Dataset、Model、Strategy、Backtest),新手入门需要时间。数据准备复杂,需要自己准备和转换数据。部分模块文档不够详细,需要阅读源码。深度学习模型需要 GPU 加速,否则训练很慢。使用云 API 时,市场数据可能涉及隐私问题。不建议用于:只想做简单的技术指标策略回测(用 Backtrader 更轻量)、需要实盘交易执行、完全没有 Python 和机器学习基础、需要实时行情数据源的情况。
简体中文 · AI 译文 原文
AI 中文译文,非官方翻译;安装命令与技术细节请对照原文。
@misc{li2025rdagentquant,
    title={R\&D-Agent-Quant: A Multi-Agent Framework for Data-Centric Factors and Model Joint Optimization},
    author={Yuante Li and Xu Yang and Xiao Yang and Minrui Xu and Xisen Wang and Weiqing Liu and Jiang Bian},
    year={2025},
    eprint={2505.15155},
    archivePrefix={arXiv},
    primaryClass={cs.AI}
}
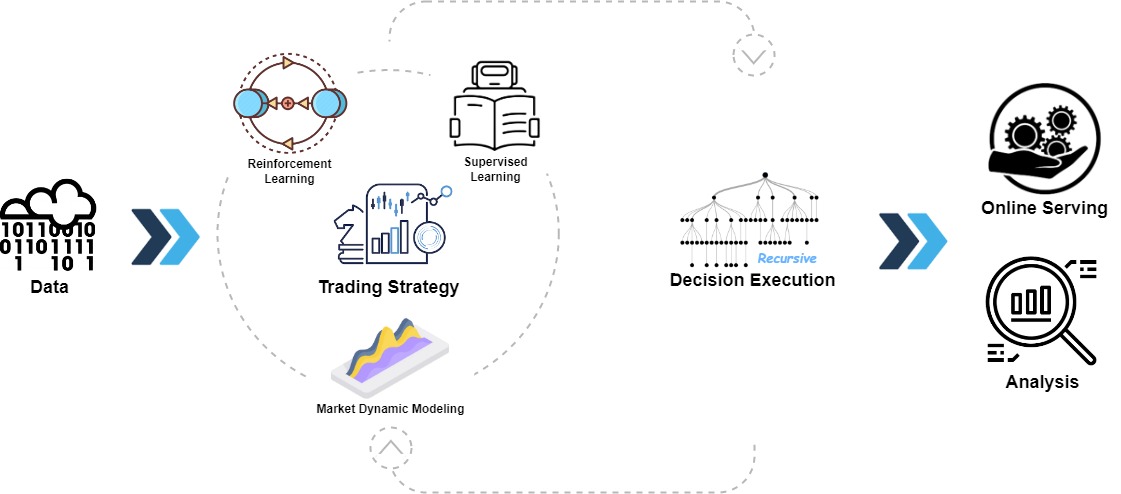
Qlib 是一个开源、面向 AI 的量化投资平台,旨在利用 AI 技术在量化投资中实现潜力、赋能研究并创造价值,从探索想法到实现生产。Qlib 支持多种机器学习建模范式,包括监督学习、市场动态建模和强化学习。
越来越多的不同范式的 SOTA 量化研究工作和论文正在 Qlib 中发布,以协同解决量化投资中的关键挑战。例如,1)使用监督学习从丰富且异构的金融数据中挖掘市场复杂的非线性模式,2)使用自适应概念漂移技术对金融市场的动态特性进行建模,3)使用强化学习对连续投资决策进行建模,并协助投资者优化其交易策略。
计划 正在开发中的新功能(按预计发布时间排序)。
您对这些功能的反馈非常重要。
Qlib 框架 Qlib 的高层框架如上所示(当深入研究细节时,用户可以找到 Qlib 设计的详细框架 )。
这些组件被设计为松耦合模块,每个组件都可以独立使用。
快速开始
使用 Qlib 构建一个完整的量化研究工作流并尝试您的想法非常容易。
尽管使用公开数据 和简单模型 ,机器学习技术在实际量化投资中效果非常好 。
这里有一个快速的**演示 **展示了如何安装 Qlib, and run LightGBM with qrun。但是 ,请确保您已经按照说明 准备好了数据。
安装
建议使用 Conda 来管理您的 Python 环境。在某些情况下,在 conda 环境之外使用 Python 可能会导致缺少头文件,从而导致某些包的安装失败。
请注意,在 Python 3.6 中安装 cython 时,从源码安装 Qlib from source. If users use Python 3.6 on their machines, it is recommended to upgrade Python to version 3.8 or higher, or use conda's Python to install Qlib 会引发一些错误。
使用 pip 安装 用户可以通过以下命令轻松地使用 pip 安装 Qlib。
注意 :pip 将安装最新的稳定版 qlib。但是,qlib 的主分支正在积极开发中。如果您想测试主分支中的最新脚本或函数,请使用以下方法安装 qlib。
从源码安装 此外,用户可以根据以下步骤从源代码安装最新的开发版 Qlib:
在从源码安装 Qlib 之前,用户需要先安装一些依赖项:
pip install numpy
pip install --upgrade cython
克隆仓库并按如下方式安装 Qlib。
git clone https://github.com/microsoft/qlib.git && cd qlib
pip install .  # `pip install -e .[dev]` is recommended for development. check details in docs/developer/code_standard_and_dev_guide.rst
提示 :如果你在环境中安装 Qlib 或运行示例时失败,对比你的步骤与 CI 工作流 可能有助于你找到问题。
Mac 用户提示 :如果你使用的是搭载 M1 芯片的 Mac,在构建 LightGBM 的 wheel 时可能会遇到问题,这是由于缺少 OpenMP 的依赖。为解决此问题,请先使用 brew install libomp and then run pip install . 安装 openmp,以便成功构建。
数据准备 ❗ 由于更严格的数据安全政策,官方数据集暂时不可用。你可以尝试社区贡献的 此数据源 。
以下是一个下载最新数据的示例。
wget https://github.com/chenditc/investment_data/releases/latest/download/qlib_bin.tar.gz
mkdir -p ~/.qlib/qlib_data/cn_data
tar -zxvf qlib_bin.tar.gz -C ~/.qlib/qlib_data/cn_data --strip-components=1
rm -f qlib_bin.tar.gz
使用模块获取 # get 1d data
python -m qlib.cli.data qlib_data --target_dir ~/.qlib/qlib_data/cn_data --region cn
# get 1min data
python -m qlib.cli.data qlib_data --target_dir ~/.qlib/qlib_data/cn_data_1min --region cn --interval 1min
从源码获取 # get 1d data
python scripts/get_data.py qlib_data --target_dir ~/.qlib/qlib_data/cn_data --region cn
# get 1min data
python scripts/get_data.py qlib_data --target_dir ~/.qlib/qlib_data/cn_data_1min --region cn --interval 1min
该数据集由 爬虫脚本 收集的公开数据创建,这些脚本已发布在
同一仓库中。
用户可以使用它创建相同的数据集。数据集说明
自动更新日频数据(来自 yahoo finance)
如果用户只想在历史数据上尝试模型和策略,此步骤为 可选 。
建议用户手动更新一次数据(--trading_date 2021-05-25),然后设置为自动更新。
注意 :用户不能基于 Qlib 提供的离线数据进行增量更新(部分字段已被移除以减小数据大小)。用户应使用 yahoo 收集器 从头下载 Yahoo 数据,然后进行增量更新。
更多信息请参考:yahoo 收集器
检查数据健康状态
我们提供了一个脚本来检查数据的健康状态,你可以运行以下命令来检查数据是否健康。
python scripts/check_data_health.py check_data --qlib_dir ~/.qlib/qlib_data/cn_data
当然,你也可以添加一些参数来调整测试结果,例如这样。
python scripts/check_data_health.py check_data --qlib_dir ~/.qlib/qlib_data/cn_data --missing_data_num 30055 --large_step_threshold_volume 94485 --large_step_threshold_price 20
如果你想了解更多关于 check_data_health的信息,请参考 文档 .
Docker 镜像
从 docker hub 仓库拉取镜像
docker pull pyqlib/qlib_image_stable:stable
启动一个新的 Docker 容器
docker run -it --name <container name> -v <Mounted local directory>:/app pyqlib/qlib_image_stable:stable
此时你已进入 docker 环境,可以运行 qlib 脚本。示例:
>>> python scripts/get_data.py qlib_data --name qlib_data_simple --target_dir ~/.qlib/qlib_data/cn_data --interval 1d --region cn
>>> python qlib/cli/run.py examples/benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
退出容器
>>> exit
重启容器
docker start -i -a <container name>
停止容器
docker stop <container name>
删除容器
docker rm <container name>
如果你想了解更多信息,请参考 文档 。
自动量化研究工作流 Qlib 提供了一个名为 qrun 的工具,可自动运行整个工作流(包括构建数据集、训练模型、回测和评估)。你可以按照以下步骤启动自动量化研究工作流并获得图形化报告分析:
量化研究工作流:使用 lightgbm 工作流配置([workflow_config_lightgbm_Alpha158.yaml]( qrun ,如下所示。examples/benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml)运行
  cd examples  # Avoid running program under the directory contains `qlib`
  qrun benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
如果用户想在调试模式下使用 qrun ,请使用以下命令:
python -m pdb qlib/cli/run.py examples/benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
qrun 的结果如下,更多关于结果的解释请参考 文档 。
'The following are analysis results of the excess return without cost.'
                       risk
mean               0.000708
std                0.005626
annualized_return  0.178316
information_ratio  1.996555
max_drawdown      -0.081806
'The following are analysis results of the excess return with cost.'
                       risk
mean               0.000512
std                0.005626
annualized_return  0.128982
information_ratio  1.444287
max_drawdown      -0.091078
这里有关于 qrun 和 工作流 的详细文档。
图形化报告分析:首先,运行 python -m pip install .[analysis] 安装所需依赖。然后使用 examples/workflow_by_code.ipynb 以获取图形化报告。
预测信号(模型预测)分析
投资组合分析
回测收益
上述结果的 解释
通过代码构建自定义量化研究工作流 自动工作流可能不适合所有量化研究人员的研究流程。为支持灵活的量研究工作流,Qlib 还提供了模块化接口,允许研究人员通过代码构建自己的工作流。此处 是一个通过代码实现自定义量化研究工作流的演示。
量化研究中的主要挑战与解决方案 量化投资是一个非常独特的场景,有许多关键挑战需要解决。
目前,Qlib 为其中一些问题提供了解决方案。
预测:发现有价值的信号/模式 准确预测股价趋势是构建盈利投资组合非常重要的部分。
然而,金融市场中大量格式多样的数据使得构建预测模型具有挑战性。
越来越多的 SOTA 量化研究工作/论文,专注于构建预测模型以挖掘复杂金融数据中的有价值信号/模式,已在 Qlib
每个模型在 Alpha158 和 Alpha360 数据集上的表现可以在此处 查看。
运行单个模型 上述所有模型均可通过 Qlib 运行。用户可以通过 benchmarks 文件夹找到我们提供的配置文件以及模型的详细信息。更多信息可在上述模型文件中获取。
Qlib 提供了三种不同的方式来运行单个模型,用户可以选择最适合自己情况的方式:
用户可以使用上述工具 qrun 根据配置文件运行模型的工作流。
用户可以基于 workflow_by_code 文件夹中列出的示例 创建 examples python 脚本。
用户可以使用run_all_model.py](examples/run_all_model.py文件夹中列出的脚本[ examples )来运行模型。以下是具体 shell 命令的示例: python run_all_model.py run --models=lightgbm,其中 --models 参数可以接受上述任意数量的模型(可用模型可在 benchmarks 中找到)。更多使用案例,请参阅该文件的 docstrings 。
注意 :每个基线有不同的环境依赖,请确保您的 python 版本符合要求(例如,由于 tensorflow==1.15.0的限制,TFT 仅支持 Python 3.6~3.7)
运行多个模型 Qlib 还提供了一个脚本 run_all_model.py注意 :该脚本目前仅支持 Linux 。其他操作系统将在未来得到支持。此外,它也不支持并行多次运行同一模型,这个问题也将在未来的开发中修复。)
该脚本会为每个模型创建一个独立的虚拟环境,并在训练后删除这些环境。因此,只会生成并存储实验结果,如 IC 和 backtest 结果。
python run_all_model.py run 10
破坏性变更 在 pandas, group_key 中,它是 groupby 方法的参数之一。从 pandas的 1.5 版本到 2.0 版本, group_key 的默认值已从 no default 更改为 True,这将导致 qlib 在运行期间报错。因此我们设置了 group_key=False,但这并不能保证某些程序能正确运行,包括:
qlib\examples\rl_order_execution\scripts\gen_training_orders.py
qlib\examples\benchmarks\TRA\src\dataset.MTSDatasetH.py
qlib\examples\benchmarks\TFT\tft.py
由于金融市场环境的非平稳性,数据分布在不同时期可能会发生变化,这使得基于训练数据构建的模型在未来测试数据上的性能下降。
因此,使预测模型/策略适应市场动态对模型/策略的性能非常重要。
强化学习:建模连续决策 Qlib 现在支持强化学习,这是一个旨在建模连续投资决策的功能。该功能通过与环境交互学习以最大化某种累积奖励的概念,帮助投资者优化其交易策略。
以下是基于 Qlib 构建的解决方案列表,按场景分类。
此处 是该场景的介绍。以下所有方法都在此处 进行了比较。
量化数据集动物园 数据集在量化中扮演着非常重要的角色。以下是基于 Qlib构建的数据集列表:
此处 是使用 Qlib构建数据集的教程。
非常欢迎您提交构建新量化数据集的 PR。
学习框架 Qlib 具有高度可定制性,其许多组件都是可学习的。
可学习组件是 Forecast Model 和 Trading Agent的实例。它们基于 Learning Framework 层进行学习,然后应用于 Workflow 层中的多个场景。
学习框架也利用了 Workflow 层(例如共享 Information Extractor、基于 Execution Env创建环境)。
对于监督学习,详细文档见此处 。
对于强化学习,详细文档见此处 。Qlib 的强化学习框架利用 Execution Env 在 Workflow 层创建环境。值得注意的是,也支持 NestedExecutor 。这使用户能够同时优化不同级别的策略/模型/智能体(例如,为特定的投资组合管理策略优化订单执行策略)。
更多关于 Qlib 如果您想快速了解 qlib 最常用的组件,可以尝试此处 的 notebooks。
详细文档整理在docs 中。
构建 HTML 格式的文档需要Sphinx 和 readthedocs 主题。
cd docs/
conda install sphinx sphinx_rtd_theme -y
# Otherwise, you can install them with pip
# pip install sphinx sphinx_rtd_theme
make html
Qlib 正在积极持续开发中。我们的计划在路线图中,该路线图作为github 项目 进行管理。
离线模式和在线模式 Qlib 的数据服务器可以部署为 Offline 模式或 Online 模式。默认模式为离线模式。
Qlib 数据服务器的性能 数据处理性能对于像 AI 技术这样的数据驱动方法至关重要。作为一个面向 AI 的平台,Qlib 提供了数据存储和数据处理的解决方案。为了展示 Qlib 数据服务器的性能,我们将其与其他几种数据存储解决方案进行了比较。
我们通过完成相同的任务来评估几种存储解决方案的性能,该任务从股票市场(2007 年至 2020 年每天 800 只股票)的基本 OHLCV 日线数据创建一个数据集(14 个特征/因子)。该任务涉及数据查询和处理。
+(-)E 表示有(无) ExpressionCache+(-)D 表示有(无) DatasetCache 大多数通用数据库加载数据耗时过长。在查看底层实现后,我们发现数据在通用数据库解决方案中经过了太多接口层和不必要的格式转换。
这些开销大大减慢了数据加载过程。
Qlib 数据以紧凑格式存储,便于组合成数组以进行科学计算。
相关报告
联系我们
如果您有任何问题,请在此处 创建 issue 或在gitter 中发送消息。
如果您想为 Qlib做出贡献,请创建拉取请求 。
对于其他事宜,欢迎通过电子邮件联系我们(qlib@microsoft.com )。
我们正在招募新成员(包括全职员工和实习生),欢迎投递简历!
贡献 在我们于 2020 年 9 月在 Github 上将 Qlib 作为开源项目发布之前,Qlib 是我们组内的一个内部项目。不幸的是,内部提交历史没有被保留。我们组内许多成员也为 Qlib 做出了大量贡献,包括 Ruihua Wang、Yinda Zhang、Haisu Yu、Shuyu Wang、Bochen Pang 和Dong Zhou 。特别感谢Dong Zhou ,因为他是 Qlib 初始版本的作者。
指南 做出贡献并非难事。解决问题(也许只是回答问题列表 或gitter 中提出的问题)、修复/提交 bug、改进文档甚至修正拼写错误都是对 Qlib 的重要贡献。
例如,如果您想为 Qlib 的文档/代码做出贡献,您可以按照下图中的步骤操作。
你可以在 Qlib 中找到一些不完美的实现,通过 rg 'TODO|FIXME' qlib
如果你希望成为 Qlib 的维护者之一,贡献更多(例如帮助合并 PR、分类问题),请通过电子邮件联系我们(qlib@microsoft.com )。我们很乐意帮助你提升权限。
许可证 当你提交拉取请求时,CLA 机器人会自动判断你是否需要提供
CLA,并适当装饰 PR(例如,状态检查、评论)。只需按照机器人提供的说明操作。你只需在使用我们 CLA 的所有仓库中执行一次。
09.08