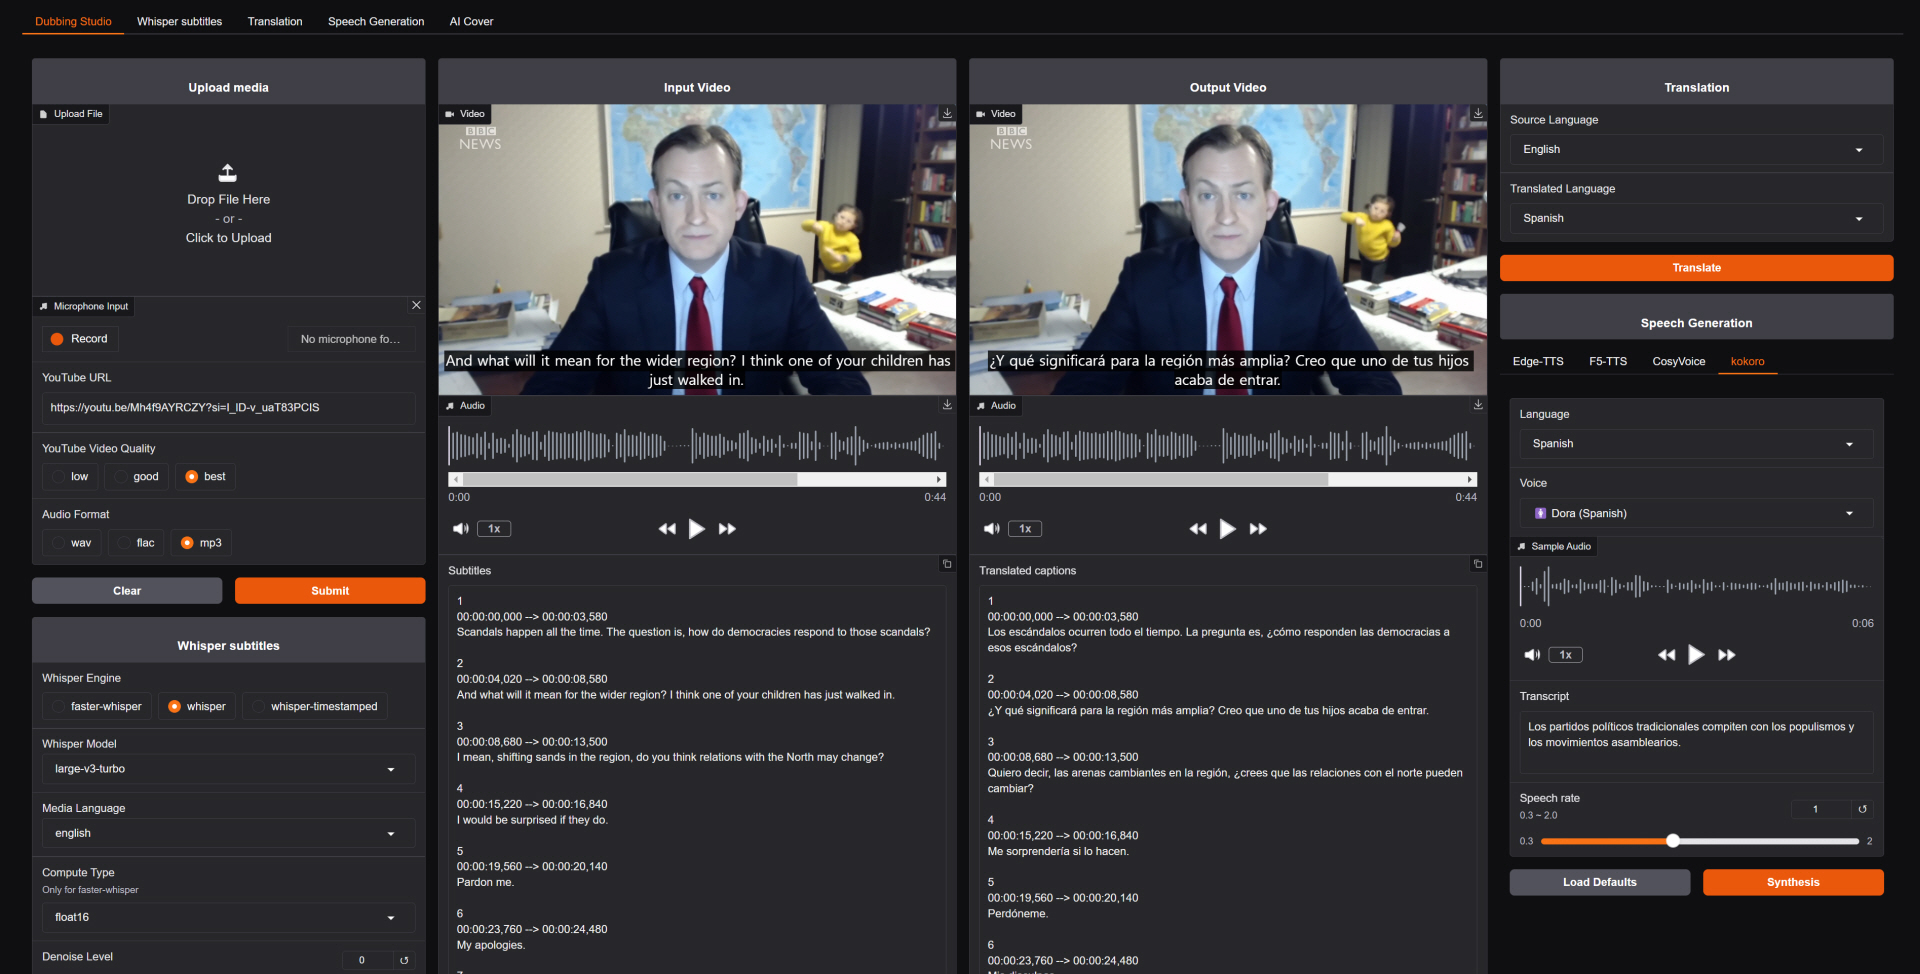
Voice-Pro
一站式 AI 语音工作台,从视频下载到多语言配音全流程自动化
Voice-Pro 是一款面向创作者和开发者的 AI 音频全流程处理工具,由韩国创业公司 ABUS 开发,基于 Gradio WebUI 构建。它将视频下载、音频分离、语音识别、多语言翻译、文本转语音(TTS)和零样本声音克隆集成到一个统一的 Web 界面中,定位为 ElevenLabs 的开源替代方案。核心价值在于将传统需要 5-8 个工具配合的流程(下载、分离、识别、翻译、配音、字幕)串联成一条自动化管道,用户只需输入视频链接,即可获得多语言配音视频和字幕。工具支持四种 Whisper 变体用于语音识别,三种零样本声音克隆引擎(F5-TTS、E2-TTS、CosyVoice),以及 Edge-TTS、kokoro 等多语言 TTS。完全开源免费,本地运行,数据不出机器。需要 NVIDIA GPU(最低 4GB 显存,推荐 8GB+),首次部署需下载模型,耗时较长。
09.08