InfiniteTalk
音频驱动的无限长说话视频生成框架
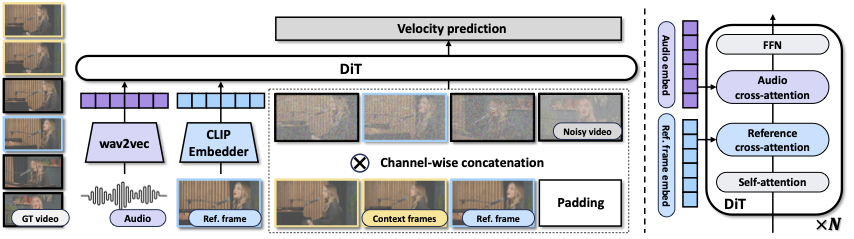
InfiniteTalk 是美团 MeiGen-AI 团队于 2025 年 8 月开源的音频驱动无限长说话视频生成框架,全称 "Audio-driven Video Generation for Sparse-Frame Video Dubbing"。它提出了一种新型视频配音范式——"稀疏帧视频配音",通过保留原始视频的关键参考帧,在维持身份信息、标志性手势和摄像机轨迹的同时,对全身运动进行音频同步的编辑。给定一段源视频和目标音频,可生成与音频精确口型同步、头部/身体/表情联动的全新视频;给定一张人物图片和音频,可从零生成无限长的说话人视频。支持 480P 和 720P 分辨率,默认最大 1000 帧/40 秒,可流式扩展。底层基于扩散模型构建,使用 Wan2.1-I2V-14B 作为视频生成基座,音频编码器采用 Wav2Vec2。项目以 Apache-2.0 许可证开源。
09.08