跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签7TTS4声音克隆3语音合成3LLM3开源2Python21M上下文1本地优先1大语言模型1端侧推理1短视频1多模型路由1

项目搜索结果

找到 7 个项目

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

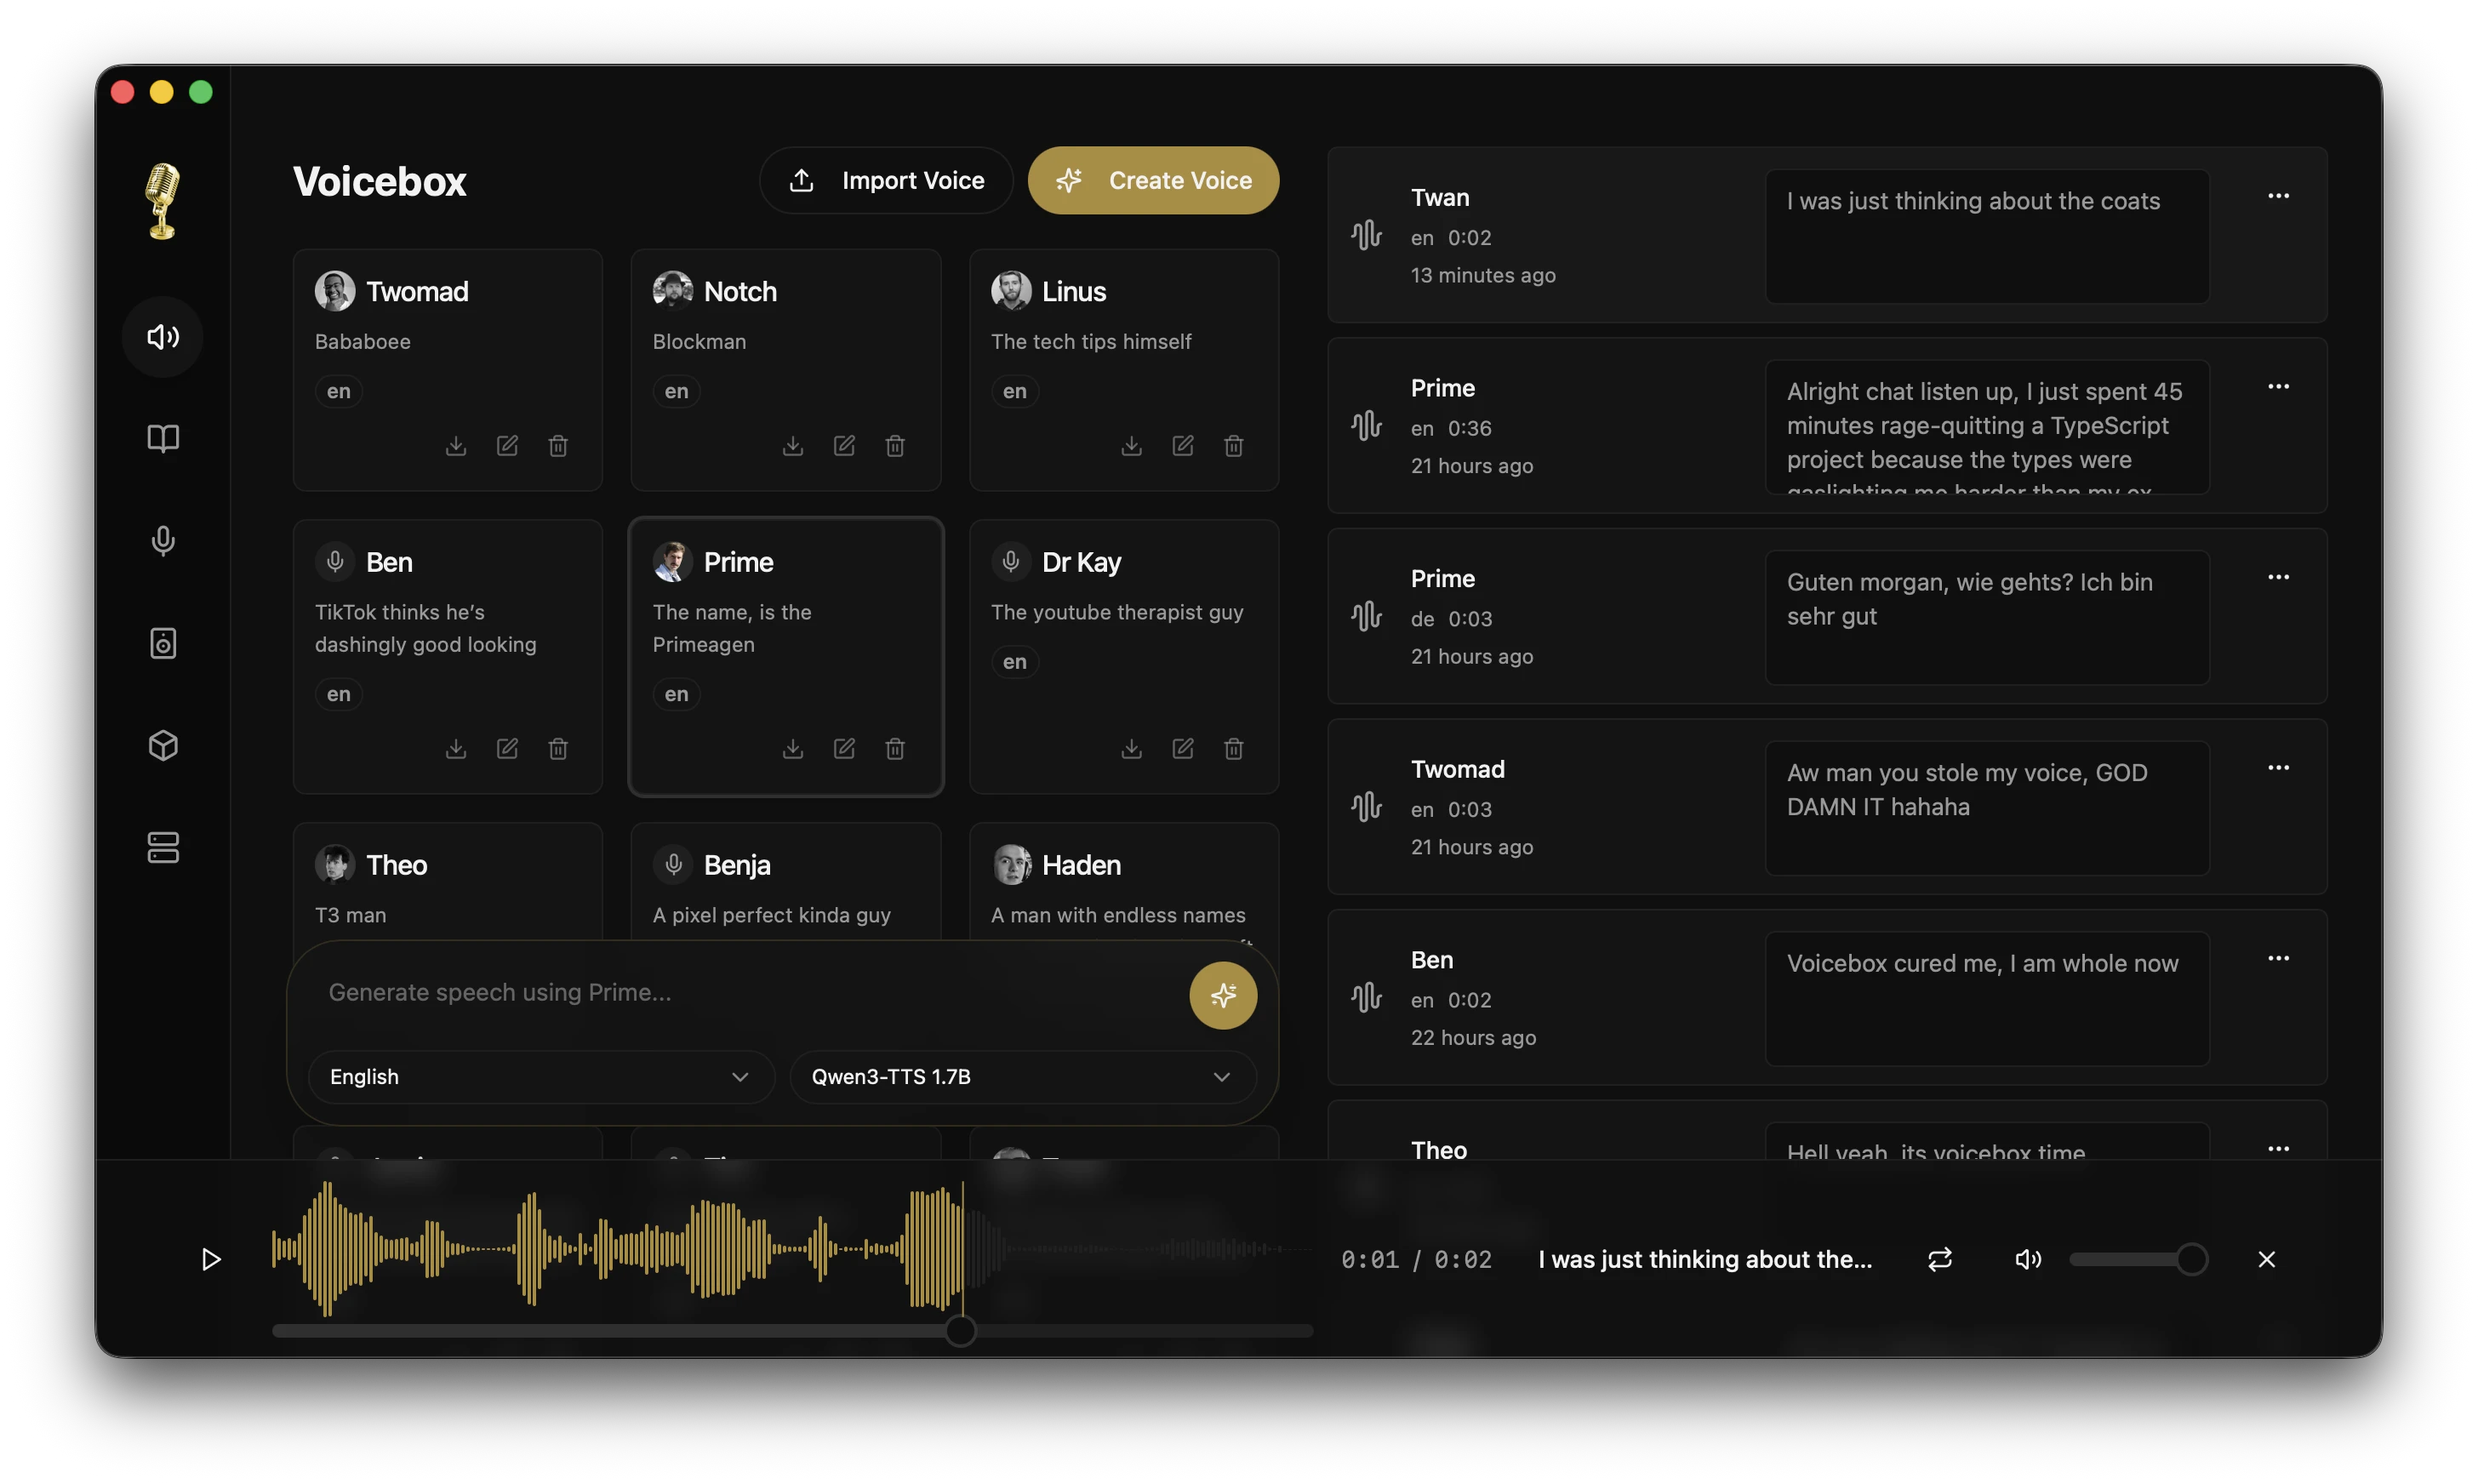
Voicebox README 配图
内容创作GitHub 项目

Voicebox

本地优先的开源语音合成工作站,集成多引擎声音克隆、情感标签、后处理音效与多轨编辑

Voicebox 是由 Jamie Pine 开发的开源语音合成工作室,定位为 ElevenLabs 的免费本地替代方案。它是一个完整的桌面应用,集声音克隆、语音生成、后处理特效、多轨编辑于一体,所有模型和数据完全在本地运行。项目采用 Tauri (Rust) 桌面框架,前端使用 React + TypeScript,后端为 Python (FastAPI),音效处理由 Spotify pedalboard 驱动。内置 5 个 TTS 引擎,支持 23 种语言,最大文本长度 50,000 字符,并提供完整 REST API 供外部集成。核心能力包括多引擎声音克隆、情感表达控制(如 [laugh]、[sigh] 等副语言学标签)、8 种后处理音效、多轨时间轴编辑(Stories Editor)以及长文本自动分段与交叉淡入淡出拼接。项目采用 MIT 协议完全开源,支持 CUDA、ROCm、MLX、DirectML、XPU 及 CPU 等多种 GPU 后端。

本地优先声音克隆FastAPI
09.08
内容创作主题配图

AI短视频全流程自动化工具链

从创意到发布的全流程自动化短视频生产工具链

AI短视频全流程自动化工具链是一组开源项目按“生成→剪辑→翻译→发布”顺序串联形成的工作流体系,利用大语言模型、语音识别、语音合成、机器翻译和浏览器自动化等技术,将短视频内容创作的全生命周期从“人工逐环节操作”升级为“一键自动化流水线”。工具链由四个核心项目组成:MoneyPrinterTurbo负责视频生成,FunClip负责智能视频剪辑,KrillinAI负责视频翻译配音,social-auto-upload负责多平台一键发布。它属于“AI辅助内容创作”技术体系,核心价值是把一个短视频从“创意到上线”的全流程压缩到分钟级别,并且一个人就能完成传统需要文案、剪辑师、翻译、运营四个人协作的工作。传统短视频制作周期通常需要1-3天,该工具链可大幅缩短制作时间。

短视频浏览器自动化自动化
09.08
AI 智能体主题配图

Xiaomi MiMo 大模型

小米自研的 Agent 基础模型,面向“完成任务”而非“回答问题”设计

Xiaomi MiMo(Mind in Motion)是小米集团自研的大语言模型产品线,面向 Agent 时代设计,覆盖文本生成、全模态理解、语音合成三大能力域。它被定位为一套完整的智能体基础模型体系,设计目标是“完成任务”而非仅仅是“回答问题”。MiMo 解决的核心问题是让 AI 从“能对话”进化到“能干活”,能够稳定完成近千轮工具调用的长程任务,自主诊断和恢复错误,并同时处理文本、图像、音频、视频等多种模态信息。截至 2026 年 4 月,MiMo 系列已迭代至 V2.5 版本,包含旗舰推理模型 MiMo-V2.5-Pro、全模态 Agent 模型 MiMo-V2.5、语音合成模型 MiMo-V2.5-TTS、语音识别模型 MiMo-V2.5-ASR 以及轻量快速模型 MiMo-V2-Flash。其核心架构创新包括混合注意力机制和全模态统一架构,并强调 Token 效率优化。

1M上下文大语言模型混合注意力
09.08
CosyVoice README 配图
内容创作GitHub 项目

CosyVoice

多语种语音生成模型,支持3秒声音克隆与流式合成

CosyVoice 是阿里巴巴达摩院 FunAudioLLM 团队开发的多语种大语音生成模型,提供推理、训练和部署的全栈能力。其核心能力包括仅需 3 秒参考音频即可实现零样本声音克隆,覆盖 9 种常见语言和 18 种以上中文方言,并支持跨语种克隆。模型采用 LLM 生成语义 Token 与 Flow Matching 渲染声波的双阶段架构,CosyVoice 2.0 起支持双向流式合成,延迟低至 150ms。CosyVoice 3.0 引入多任务 Tokenizer 和可微分奖励模型后训练,训练数据扩展至 100 万小时。项目采用 Apache-2.0 许可证,支持本地部署,提供 Docker、FastAPI、gRPC、vLLM、TensorRT-LLM 等多种部署方式。

多语种流式合成深度学习
09.08
其他项目主题配图

Supertonic vs MOSS-TTS-Nano 开源轻量级 TTS 深度对比

对比两款开源轻量级 TTS:Supertonic 跨平台部署,MOSS-TTS-Nano 零样本声音克隆

本文档对比两款开源轻量级 TTS 系统:Supertonic 与 MOSS-TTS-Nano。Supertonic 由 Supertone Inc. 开发,基于 ONNX Runtime 完全本地运行,约 99M 参数,支持 31 种语言,提供 11 种语言 SDK,采用 Flow Matching 与语音自编码器架构,代码 MIT 许可,模型 OpenRAIL-M。MOSS-TTS-Nano 由 MOSI.AI 和复旦大学 OpenMOSS 团队开发,仅 0.1B 参数,基于 Audio Tokenizer + LLM 纯自回归架构,支持实时流式推理,可在 4 核 CPU 上运行,支持零样本声音克隆,输出 48kHz 立体声,Apache-2.0 许可。两者均解决传统 TTS 的部署、质量、工程与生态痛点,但侧重点不同:Supertonic 适合跨平台部署与极低资源设备,MOSS-TTS-Nano 适合声音克隆与中文 TTS。文档还包含架构原理、系统架构、关键流程、应用场景、优缺点与选型建议。

端侧推理声音克隆语音合成
09.08
内容创作主题配图

AI短剧开源工作流

用LLM、文生图、文生视频与TTS串联成自动化流水线,实现从剧本到成片的批量短剧生产

AI短剧开源工作流是一类利用大语言模型(LLM)、AI图像生成、AI视频生成、TTS语音合成等技术,实现从剧本或小说文本到完整短剧视频全自动化生产的开源工具链。其核心思想是将影视生产的每个环节模型化,用LLM做编剧和导演、用文生图做美术、用文生视频做摄影、用TTS做配音,再通过Agent工作流将所有环节串联成一条自动化流水线。报告覆盖三个代表性开源项目:moyin-creator(魔因漫创)为桌面端生产级工具,深度绑定Seedance 2.0,采用6层身份锚点保证角色一致性;waoowaoo为Web端工业级AI影视平台,专攻网文转视频;huobao-drama(火宝短剧)为极简一站式平台,内置5个Mastra AI Agent,支持一句话生成完整短剧。这些项目覆盖了剧本解析、角色生成、场景生成、分镜制作、视频生成、配音合成、成片导出的核心链路,旨在将传统短剧3-6个月的生产周期压缩到数小时甚至数分钟。

工作流角色一致性开源
09.08
Hermes Agent 高阶工具配置 README 配图
AI 智能体GitHub 项目

Hermes Agent 高阶工具配置

一个整合终端操作、代码编辑、浏览器控制、记忆系统与语音交互的开源 AI Agent 框架。

Hermes Agent 是由 Nous Research 开发的开源 AI Agent 框架,定位为自我进化的个人 AI 助手。它整合终端操作、代码编辑、浏览器控制、记忆系统、语音交互于一体,通过 Skill 系统实现无限扩展能力。其核心差异在于内置学习循环,能从经验中创建和改进 Skill,并跨会话构建对用户的深度理解。 该框架采用 CLI 与 GUI 双形态,支持 MCP 协议,不绑定单一 LLM,可灵活切换模型提供商,并支持跨平台部署。其能力分为身份与记忆、感知、表达、效率与成本、生态扩展五大层。记忆系统包含会话内、跨会话和知识图谱三层架构。感知能力涵盖网页抓取、搜索、浏览器自动化等。表达层支持语音合成、语音识别和图片生成。效率层提供 Token 监控、压缩和智能路由工具。生态方面拥有 380+ 社区 Skill。 报告指出其优点包括全能性、丰富的 Skill 生态、强大的记忆系统和零成本可行性,但也存在学习曲线陡、生态碎片化、文档不完善等缺点。

多模型路由记忆系统开源
09.08