跳到主要内容
prolist.
发现项目AI 收集我的项目我的模型
正在确认账号…
prolist.

发现有价值的项目,留下有依据的判断。

项目专题关于我的收藏
© 2026 prolist项目知识,由人判断。

IDEAS CONNECT PROJECTS

沿着兴趣,发现项目。

从一个标签出发,打开一份值得研究的档案。

收集项目线索
筛选与排序 · 已应用
地图列表
不限标签23提示词工程13AI图像生成7开源6图像生成5内容创作4信息图4GPT-Image 24提示词3AI Agent3TypeScript3多语言2模板化2

项目搜索结果

找到 23 个项目

清除筛选

以下内容已由 AI 根据历史资料整理,供本地测试,未经人工复核。

HyperFrames 提示词工程 README Logoheygen-com/hyperframes
内容创作GitHub 项目

HyperFrames 提示词工程

用自然语言指挥 AI Agent 编写 HTML 视频的声明式合成框架

HyperFrames 是由 HeyGen 开源的一款 HTML-to-Video 渲染框架,核心理念是“Write HTML. Render video. Built for agents”。它让 AI Agent(如 Claude Code、Cursor、Codex)能够用纯 HTML + GSAP 动画来“编写”视频,再通过无头浏览器确定性渲染为 MP4/WebM 视频文件。框架不是视频编辑器,而是声明式视频合成框架,用户写 HTML,输出视频。其设计哲学是 Agent-First,通过三个 Slash Command(/hyperframes、/hyperframes-cli、/gsap)将框架知识注入 Agent 上下文,并通过自然语言词汇表(如“smooth”、“bouncy”、“dramatic”)直接映射到 GSAP easing 函数,实现意图到代码的精准映射。框架支持冷启动(从零描述)和暖启动(喂素材转化)两种 Prompt 形态,并强调小步精准修改的迭代原则。

开源视频合成提示词工程
09.08
内容创作主题配图

GPT-Image 2 品牌包装系统提示词

一套通过约2000字模块化提示词,为任意品牌与品类生成品牌提案级包装系统展示图的方法论。

这是一套专为 ChatGPT Image 2.0 设计的品牌包装系统展示图提示词工程方法论,由 @MrLarus 实战验证。其核心是一套约 2000 字的中文提示词模板,用户只需替换【品牌名称】和【品牌类目】两个变量,即可生成包含手提袋、礼盒、单品盒、瓶罐容器、标签贴纸、产品本体等多种包装载体,且所有元素共享统一品牌视觉识别系统的展示海报。该方法论通过十层模块化控制架构,分别约束画幅、品牌系统完整性、品类适配、元素数量、视觉一致性、配色机制、构图、视觉风格、光影和最终效果。其核心设计思想包括系统感优先、受控发散配色、克制即高级、品类驱动、提案感优先和三段式构图。报告显示,该方法已在美妆、轻食、烘焙、茶饮四个不同品类品牌上生成高质量输出。该方法论适用于品牌提案、电商视觉升级、创业团队 MVP 视觉、设计灵感探索和设计教育等场景,但报告也明确指出其局限,包括品牌深度不足、Logo 真实性有限、输出为位图不可直接用于印刷、存在版权风险以及品类覆盖有限。

模板化品牌包装设计品牌视觉系统
09.08
PromptLens README 配图
内容创作GitHub 项目

PromptLens

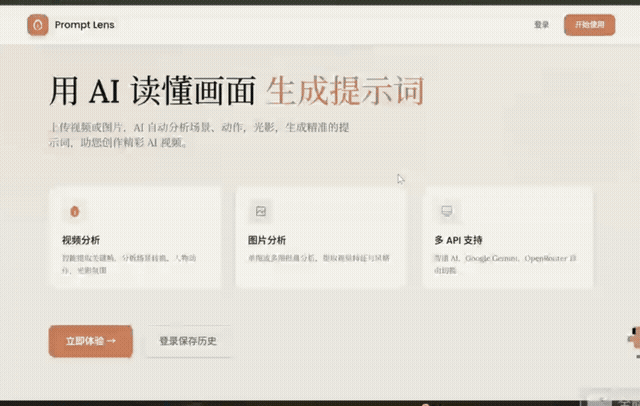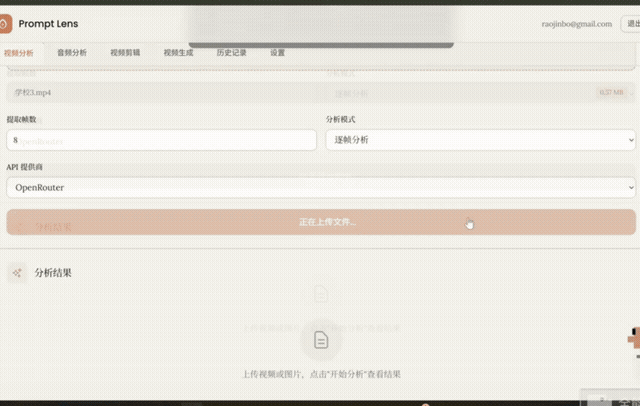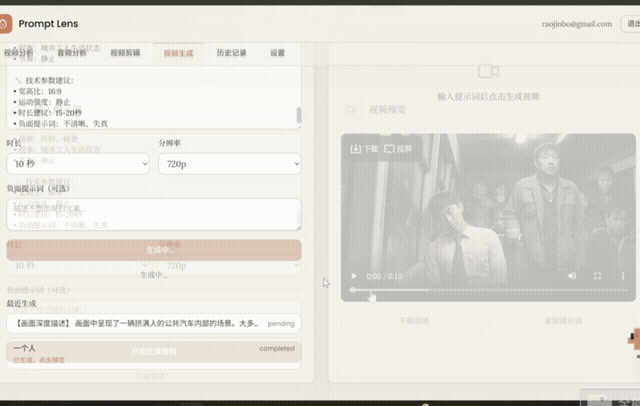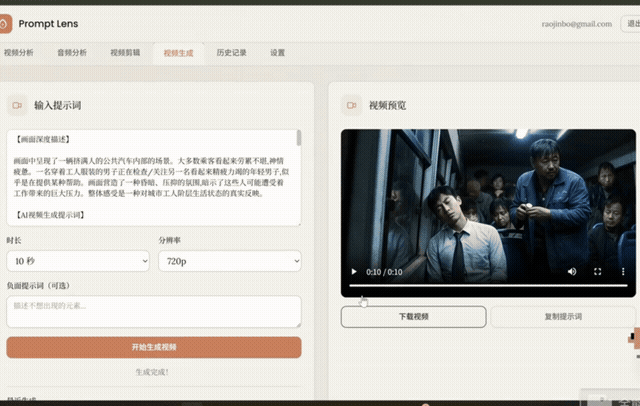
开源 AI 视频提示词反推分析工具,自动提取关键帧并生成结构化提示词

PromptLens 是一款开源的 AI 视频提示词反推分析工具,提供完整的 Web 应用体验。其核心能力是上传 AI 生成的视频或图片,自动提取关键帧,通过多模态大模型(如智谱 GLM-4V、Google Gemini、OpenRouter)分析画面内容,反向推导出可能使用的提示词,并输出结构化的、可直接复用的英文提示词。项目采用 Next.js 15 + React 19 全栈技术,使用 Supabase PostgreSQL 存储数据,Cloudflare R2 存储媒体文件,FFmpeg 进行视频帧提取,支持 better-auth 的 Google/GitHub 登录。除画面分析外,还支持通过 AssemblyAI 进行音频识别,提取视频中的语音旁白和台词。项目以 MIT 许可证开源,代码透明,可自由修改和商用。

多模态大模型开源提示词反推
09.08
内容创作主题配图

GPT-image2 社区提示词合集

社区实战验证的 GPT-image2 提示词速查手册

本合集基于社区创作者在 X 平台发布的「GPT-image2 最强玩法合集」,系统整理了 15 类经过社区实测的提示词场景,涵盖日历设计、代码海报、Logo 生成、书法复制、试卷生成、架构图绘制、UI 仿真、直播切片、MV 制作等。报告指出,GPT-image2 的核心突破在于原生文字渲染(中英日韩)和 UI 截图级逼真度,用户只需一句话中文提示词即可出图,无需学习复杂参数。合集还介绍了 URL 输入、多轮对话迭代、跨工具联动(如与 Seedance2 配合生成视频)等能力。报告同时说明,该文档是《GPT-image2 深度技术指南》的实战补充篇,侧重社区玩法而非模型原理与 API 工程。

内容管线提示词图像生成
09.08
AI 智能体主题配图

GPT Image 2 自动化生图套利实战

基于 GPT Image 2 与 MaxHermes 的自动化生图套利方法体系

本收藏记录了一套基于 OpenAI GPT Image 2 图像生成能力与 AI Agent(MaxHermes)自动化编排的商业化变现方法体系。核心思路是利用 GPT Image 2 的高质量生图能力,结合 MaxHermes 的自动化任务编排,将原本需要人工完成的生图任务变成 7×24 小时自动运行的流程。报告指出,该方法体系解决了“知道能赚钱但没时间做”的痛点,并提供了从低到高的六种变现路径,包括老照片修复、教育素材资料包、电商商品图、社媒起号、倒卖 API 和接单赚钱。报告还介绍了四层技术架构,包括图像生成能力、提示词工程、AI Agent 自动化编排和远程控制层,并说明了自进化 Skill、定时任务和微信控制等核心机制。报告同时指出了该方法的局限,如窗口期短、平台依赖、竞争加剧、质量不稳定和客户获取难等。

定时任务提示词工程图像生成
09.08
内容创作主题配图

AI形象照接单级模板提示词

一套分层锁定的AI生图提示词架构,将专业摄影参数硬性锁定,仅开放客户定制区,实现标准化接单交付。

AI形象照接单级模板提示词是一套结构化的AI生图提示词工程方法论,旨在将Midjourney、Flux、GPT Image等AI图像生成工具的输出质量从“塑料感”提升到商业影楼级写真水准,并实现标准化接单交付。其本质是分层锁死的提示词架构:将摄影参数(镜头、光位、胶片质感)硬性锁定,仅暴露客户定制区(动作、穿搭、修饰)作为可变变量。用户只需复制模板、填入客户需求、让LLM生成最终提示词,并配合客户原始照片垫图出图。该方法论解决了传统AI生图的六大痛点,包括“塑料微商味”、非标交付、摄影知识门槛、客户需求翻译困难、效率低下和AI发散不可控。核心思想是“锁定底层参数,只动客户变量”,通过三层分离架构(客户定制层、项目设定层、摄影锁定层)实现。报告还提供了五套风格模板(影楼级黑白写真、王家卫复古港风、法式冷金油画感、美漫赛博硬核风、时装型录Lookbook),以及标准接单出图流程、工具环境、常见问题排查和优缺点分析。

接单变现模板化商业摄影
09.08
内容创作主题配图

GPT-Image科学百科图解提示词

一套通过结构化提示词让AI自动生成百科级科学信息图的方法论

这是一套专为GPT-Image等多模态图像生成模型设计的高密度信息图提示词工程体系,通过结构化的视觉布局指令,让AI自动生成类似DK百科全书风格的专业科学图解。它并非软件或工具,而是一套提示词工程方法论,核心成果物是“单图即百科”的信息图:中央主体以逼真3D效果“跃出画面”,周围环绕6-8个知识模块,通过引导线、箭头、标注形成完整的知识网络。该体系解决了传统AI图像生成在知识密集型场景下的信息密度不足、布局不可控、文字渲染差、学科覆盖窄、专业度低等问题。其核心思想包括“太阳系布局”、战略性留白、引导线编织知识网络、中文书法体与手写注释的双层文字系统、三大领域模板化以及3:4竖版画幅与复古纸张质感。提示词结构拆解为7个控制层:角色定义、任务描述、领域选择、风格定义、视觉要求、模块结构、主题注入。用户只需修改主题名即可生成不同物种或人物的信息图。报告还提供了标准使用流程、批量生产流程、与竞品的对比、真实应用场景、工程落地步骤、优缺点与局限、常见误区及学习路径。

多模态AI科学教育内容创作
09.08
内容创作主题配图

GPT-Image 2 博物标本解剖风格提示词

用博物学视角与卡拉瓦乔光影,把食物变成博物馆级解剖标本的提示词技术

本项目是一套面向 GPT-Image 2 的提示词技术,由知识猫图解(@GeekCatX)创作,核心思路是以博物学大师发现野外标本的方式解剖食物,将剖开、展开、固定的处理步骤与博物馆珍贵藏品的展示框架结合,并以卡拉瓦乔为《国家地理》掌镜时的戏剧性明暗对比作为光影方向。提示词强调每个内部结构以自身材质真相发光,通过“截面锋利得近乎暴力、内部美丽得近乎神圣”的对立制造视觉张力。报告指出,该提示词约 80 字,适用于水果、坚果、蔬菜等内部结构丰富的对象,也可扩展至矿物、植物等非食物对象;其传播力在社交媒体上得到验证(原帖 274 转发、244 评论)。报告同时说明其局限:风格偏暗调侧光、仅适合可解剖展示的对象、大量使用可能引发审美疲劳,且部分食物或处理方式可能触发内容审核。

博物学卡拉瓦乔光影内容创作
09.08
内容创作主题配图

GPT-Image 2 技术蓝图信息图提示词

在真实产品照片上叠加工业级技术蓝图标注,一句话生成设计手册风格信息图

该收藏记录了一种利用 GPT-Image 2 模型生成产品技术解剖图的提示词技术,由 Bitturing 分享。其核心是在真实产品照片上叠加技术蓝图风格的标注层,包括白线、箭头、尺寸、标签以及零件、材料、尺寸和功能的小型示意图,并配有左上角写有"OBJECT"的草图框和 1:1 维度标注,呈现出类似工业设计手册的专业感。该技术旨在解决传统产品技术展示中摄影与设计分离、专业门槛高、效率低下和风格一致性难保证等问题。报告指出,该技术适用于电子产品、机械产品、运动装备、汽车等对象,其中内部结构复杂的产品效果最好。报告同时提醒,AI 生成的尺寸标注可能不准确,仅供参考,正式使用需人工核实。

技术蓝图内容创作提示词
09.08
内容创作主题配图

OpenNana 提示词图库

中文原生的 AI 图像提示词视觉化图库,收录 104+ 条精选案例覆盖多种主流模型

OpenNana 是一个 AI 图片提示词分享平台,核心产品是提示词图库,目前已收录 104+ 条精选提示词案例,覆盖 Nano Banana Pro、GPT Image-2(ChatGPT)、Grok、Seedance 2.0 等主流 AI 图像/视频生成模型。平台定位为 AI 图像创作者的灵感库和提示词参考站,提供浏览、搜索、收藏高质量提示词的功能。核心能力包括多模型覆盖、分类筛选(按模型、媒体类型、标签)、视觉化展示(每条提示词配有生成效果图)以及一站式体验(提供 AI 生图、AI 生视频、生成记录等工具)。平台采用三维分类体系:模型、媒体类型、标签,便于用户快速定位目标提示词。设计原则包括视觉优先、多模型平等、标签化组织、创作者溯源、平台一体化和持续更新。平台还内置 AI 生图工具,用户可一键生成图片。

视觉化展示提示词图库中文原生
09.08
内容创作主题配图

GPT-Image 2 实操案例与提示词工程指南

一份基于实操案例整理的 GPT-Image 2 提示词工程指南,覆盖 13 类应用场景与模板化用法。

本指南基于一份实操报告整理,围绕 OpenAI 于 2026 年 4 月推出的图像生成模型 GPT-Image 2 展开。报告指出,该模型并非传统文生图工具,而是集成了意图理解、知识补全、设计规划与精准渲染的 Agent 系统。指南重点介绍了其四大核心亮点:高质量中文渲染、自动补全缺失信息、支持极简提示词以及可对话式追问微调。内容主体为 13 个实操案例,覆盖图鉴拆解、古文书法、科普百科、电商详情、试卷生成、旅游攻略、人物关系图、密集中文排版等场景,每个案例均提供了对应的提示词模板与通用性说明。此外,指南还对比了 GPT-Image 2 与 Midjourney、DALL-E 3、Stable Diffusion 等工具的差异,并总结了优缺点、常见误区与学习路径。报告同时指出其局限,如不适合像素级精确排版、无法本地部署或批量调用,以及存在伦理风险。

提示词工程图像生成信息图
09.08
内容创作主题配图

YouMind GPT Image 2 提示词库

社区驱动的 GPT Image 2 提示词策展平台,提供已验证提示词与多语言支持

YouMind GPT Image 2 提示词库是一个由 YouMind 团队维护的社区驱动型 AI 图像提示词集合平台,覆盖 OpenAI GPT Image 2 模型。截至 2026 年 4 月 21 日,平台已收录 725+ 条提示词,并以每日更新的速度持续增长。平台提供 Web Gallery 和 GitHub 开源仓库两种使用方式,支持 16 种语言版本,采用 CC BY 4.0 开源协议。核心功能包括瀑布流布局、全文搜索、分类筛选、AI 一键生成以及社区投稿系统。平台从用途、风格、主体三个维度对提示词进行分类,共 44+ 个类别。此外,部分提示词支持 Raycast Snippets 集成,便于用户模板化使用。平台通过 GitHub Actions 每 12 小时自动同步更新,确保内容时效性。

多语言开源社区驱动
09.08
Huobao Drama 火宝短剧 README 配图
内容创作GitHub 项目

Huobao Drama 火宝短剧

一站式 AI 短剧自动化生产平台,从剧本到成片全流程编排

Huobao Drama(火宝短剧)是由南京 AI 火宝团队开发的一站式 AI 短剧自动化生产平台,实现从剧本生成、角色设计、分镜制作到视频合成的全流程自动化。项目以 TypeScript 全栈构建,后端采用 Hono + Drizzle ORM + Mastra AI Agent 框架,前端使用 Nuxt 3 + Vue 3,数据库选用 SQLite。其核心价值在于将短剧制作拆解为剧本改写、角色提取、分镜拆解、音色分配、提示词生成五步流水线,每一步由专门的 AI Agent 负责,通过结构化数据在步骤间传递上下文。平台不依赖单一厂商,通过多厂商适配层(OpenAI、Gemini、MiniMax、火山引擎、阿里、Chatfire)实现图片、视频、TTS 的灵活切换。最终视频合成依赖 FFmpeg,支持 Docker 单镜像部署。项目采用 CC BY-NC-SA 4.0 许可证,禁止商业用途。

自动化生产AI短剧Drizzle ORM
09.08
内容创作主题配图

GPT-Image 2 极简几何海报提示词

一段结构化提示词,让 AI 为任意产品快速生成极简几何装置风的商业级产品海报。

这是一套基于 ChatGPT Image 2.0 的提示词设计方法论,属于 AI 图像生成领域的 Prompt Engineering 范畴。其核心是通过一段精心设计的结构化提示词,让 AI 为任意产品一次性生成极简几何装置风的产品海报,达到商业级品牌 KV 级别的视觉效果。该方法旨在解决商业产品海报制作中“质量-成本-速度”的不可能三角,通过一段提示词加一张产品图,在几十秒内产出品牌级海报。提示词支持双模式输入:提供产品图时保留其核心外观特征与配色;仅输入产品名时,则自动生成符合产品定位的外观与包装设计。其底层依赖 OpenAI 的 GPT-Image 2.0 多模态图像生成模型,但提示词的设计逻辑可迁移至其他图像生成模型。

产品海报批量生产商业设计
09.08
内容创作主题配图

Creao 电商视觉设计系统

用结构化 Prompt 将 AI 变成 6 人设计团队,自动生成电商视觉方案

Creao 电商视觉设计系统是由 Berryxia.AI 开源的一套 AI 驱动的电商视觉设计 Prompt 工程体系。它不是传统软件或框架,而是一套结构化的系统提示词,通过模拟 6 个专业角色的协同工作,为任何产品类别生成完整的电商视觉设计包。系统输入仅需产品名称、类别、核心特性、目标用户、价格区间 5 个字段,输出 7 个核心设计模块,包括主视觉海报、卖点卡片、细节特写、场景卡片、规格说明、物流保障和行动召唤。其核心思想包括角色分工、模块化输出、信息层级驱动、场景化叙事、数据驱动优化和可扩展的品类适配。系统支持淘宝、京东、拼多多、小红书、抖音等多平台适配,并提供 A/B 测试框架。输出为文字方案,需配合设计工具或 AI 生图工具落地。

电商视觉设计多角色协同开源
09.08
内容创作主题配图

Seedance 2.0 提示词工程

用镜头语言导演 AI 视频:Seedance 2.0 提示词工程方法

Seedance 2.0 是字节跳动推出的 AI 视频生成模型,支持文字、图片、视频和音轨等多模态输入,在单次推理中生成音画同步的短视频。本条目整理了其提示词工程方法,核心是将“感受描述”翻译为“执行序列”,通过五层公式(主体、动作、镜头、风格、约束)构建提示词,并利用时间编码和参考文件实现精细控制。报告指出,主体描述需具体到年龄、发型、服装等属性;动作应分解为具体执行序列;镜头每代只放一个主运动;风格优先写光线和质感;约束词用于减少抖动、变形等 AI 痕迹。此外,时间编码支持按秒调度画面,参考文件(最多 9 图、3 视频、3 音轨)可提升一致性。报告还介绍了单变量迭代优化方法,并列举了 UGC、产品广告、短片等应用场景。

多模态内容创作视频生成
09.08
内容创作主题配图

AI小红书九宫格图文生成提示词工程

用LLM生成结构化提示词,再交给图像模型产出可切割发布的小红书九宫格大图

这是一套利用大语言模型自动生成高质量图片提示词,再交给AI图像生成工具产出可直接发布的小红书九宫格内容的工作流方法。核心不在于让AI直接画图,而在于让AI先设计完整的图文方案,包括视觉风格、排版结构、每格内容和配色方案,然后一次性生成一张可切割的九宫格大图。该方法由程序员Austin在2026年4月公开分享,帖子获得58赞、7转发、76条评论和4600+浏览。它属于AI辅助内容创作领域,是方法论、工作流与提示词模板的组合,不依赖特定平台,只要有LLM和图像生成工具就能使用。报告指出,传统流程制作一组九宫格可能需要2-4小时,而用AI工作流可以压缩到15-30分钟。

工作流九宫格提示词工程
09.08
AI 智能体主题配图

Claude Code 源码深度分析

深入解析 Claude Code 的工程体系:从动态提示词编排到工具治理与多 Agent 协作

本报告基于对 Claude Code 源码的深度分析,揭示了其作为 AI 编程助手的核心工程体系。报告指出,Claude Code 的价值不仅在于提示词,更在于一整套将行为制度、工具治理、Agent 分工、上下文经济学和生命周期管理连成闭环的系统。其动态 System Prompt 编排将静态“宪法”与动态“当期政策”分离,并通过缓存友好边界优化成本。工具调用经过完整的治理流水线,包括输入校验、权限检查、风险预判和 Hook 拦截。系统内置多个专职子 Agent,如 Explore、Plan、Verification,实现角色分离,避免利益冲突。此外,报告还介绍了 Skill、Plugin、MCP 三套扩展机制,以及上下文经济学中的缓存复用、按需加载等策略。报告也指出了其学习曲线陡峭、成本较高、依赖 Anthropic API 等局限性。

多Agent调度工具治理上下文管理
09.08
内容创作主题配图

GPT-Image-2 地景档案模型提示词

一套将地标建筑转化为博物馆展陈感档案模型视觉图的六层参数化提示词方法论

「地景档案模型 / Landscape Archive Model」是 @MrLarus 基于 OpenAI ChatGPT-Image-2.0 设计的一套地标建筑提示词方法论,将长城、珠峰、外滩、珠江等知名地标浓缩成具有博物馆展陈感的档案级实体模型视觉图。其核心是「参数化分层控制」,将提示词拆解为基础设定、画面结构、细节要求、说明系统、构图镜头、材质光影六个独立可调的控制层。该方法内置主题类型路由机制,可覆盖自然地貌、城市空间、混合景观三类主题;并遵循三层色彩纪律(主色调 70-80%、辅助色 15-25%、点缀色 3-5%),强调低饱和、克制的档案感。核心视觉概念是「三维生长」——立体主体从二维地图底板中自然生长出来,而非简单叠加。该方法天然支持系列化生成,固定基础参数只换主题即可产出风格统一的地标图集。

参数化模板地标可视化视觉风格控制
09.08
Hermes Agent 记忆系统 README 配图
AI 智能体GitHub 项目

Hermes Agent 记忆系统

开源 AI Agent 框架 Hermes Agent 内置的多层记忆架构,以缓存优先和冷热分离为核心设计。

Hermes Agent 记忆系统是开源 AI Agent 框架 Hermes Agent(由 Nous Research 开发)内置的多层记忆架构,由四套协同工作的记忆子系统组成。第一层为固化提示词记忆,将高频关键信息存入 MEMORY.md 和 USER.md 文件,合计约 1,300 Token,会话期间固化不变。第二层为会话搜索回溯,历史对话存储在 SQLite 数据库中,通过 FTS5 全文搜索按需检索,并使用辅助模型进行摘要。第三层为技能系统,用于记住如何做事的程序记忆,技能文件存储在 ~/.hermes/skills/ 目录。第四层为可选的 Honcho 用户建模,用于跨会话、跨平台的深层用户画像。该系统的核心设计思想是缓存优先,保持系统提示词前缀稳定以最大化利用 Prompt Caching,同时采用冷热分离策略,只保存用户偏好、环境事实、错误修正、稳定规范和学到的技能五类高价值信息。

分层记忆缓存优化记忆系统
09.08
EvoLinkAI 的 GitHub 头像EvoLinkAI/awesome-gpt-image-2-API-and-Prompts
内容创作GitHub 项目

awesome-gpt-image-2-prompts

GPT Image-2 提示词社区精选百科,收录 31+ 条真实案例与五大类别

awesome-gpt-image-2-prompts 是由 EvoLinkAI 团队维护的 GPT Image-2 提示词精选合辑,托管在 GitHub 上,采用 CC BY 4.0 协议开源。项目定位为 GPT Image-2 提示词的百科全书式参考库,收录人像摄影、海报插画、角色设计、UI 仿真、社区实验等五大类别的真实提示词与生成效果图。截至 2026.4.19,收录 31+ 条精选案例,来自 X/Twitter、创作者社区和公开演示。项目提供 11 种语言版本,持续更新。核心理念是"真实案例 > 理论指导",强调提示词原汁原味、图证合一、创作者溯源。项目还提炼了五种提示词写作模式,包括摄影参数式、设计需求式、规格清单式、场景仿真式和极简指令式,帮助用户理解和掌握 GPT Image-2 提示词的写法。

多语言精选合辑开源
09.08
内容创作主题配图

GPT-image-2 汉服拆解图提示词工程

一套面向 GPT-image-2 的提示词模板,用于生成博物馆图鉴级中文拆解信息图。

该项目是一套针对 OpenAI GPT-image-2(gpt-image-1.5 模型)设计的提示词工程方法论,核心是一段通用模板,通过替换【主题】变量,即可生成博物馆图鉴级别的中文拆解信息图。它主要解决传统 AI 图像生成在中文文化内容上的三大短板:结构准确性不足、中文文字渲染困难、图鉴专业感缺失。其实现方式是通过版式约束、风格锚定和结构分区三重机制,并依托模型的 VQ Token 统一空间、高分辨率输出和多轮对话迭代能力。提示词包含角色设定、内容要求、自主决策权、风格锚定、排除清单、版式约束和条件分支七个层次,并固定为顶部标题、左侧拆解、右上材质、右中纹样、底部流程的五区版式。该模板适用于传统服饰、器物、建筑、盔甲、凤冠等文化主题,但存在结构准确性不可控、非矢量图、历史准确性需验证等局限。

版式设计提示词工程文化内容
09.08
内容创作主题配图

NanoBanana Pro 提示词工程

系统化掌握 NanoBanana Pro 提示词工程,释放模型全部潜力

本收藏基于社区分享的 NanoBanana Pro 提示词指南整理,系统介绍了该高性能 AI 图像生成模型的提示词工程方法论。内容涵盖模型定位、核心优势、常见使用痛点、七层提示词结构、视觉词汇表、中文提示词优势、标准生成流程、对话式迭代优化方法、真实应用场景、工程落地模板、质量检查清单、优缺点与局限、常见误区及学习路径。指南强调通过“精确描述 + 结构化组织 + 排除干扰”实现高质量输出,并指出大多数用户仅使用了模型 1% 的能力。适用于希望提升 AI 图像生成质量、掌握结构化提示词技巧的创作者。

电商产品摄影国风创作人像摄影
09.08