一站式 AI 语音工作台,从视频下载到多语言配音全流程自动化
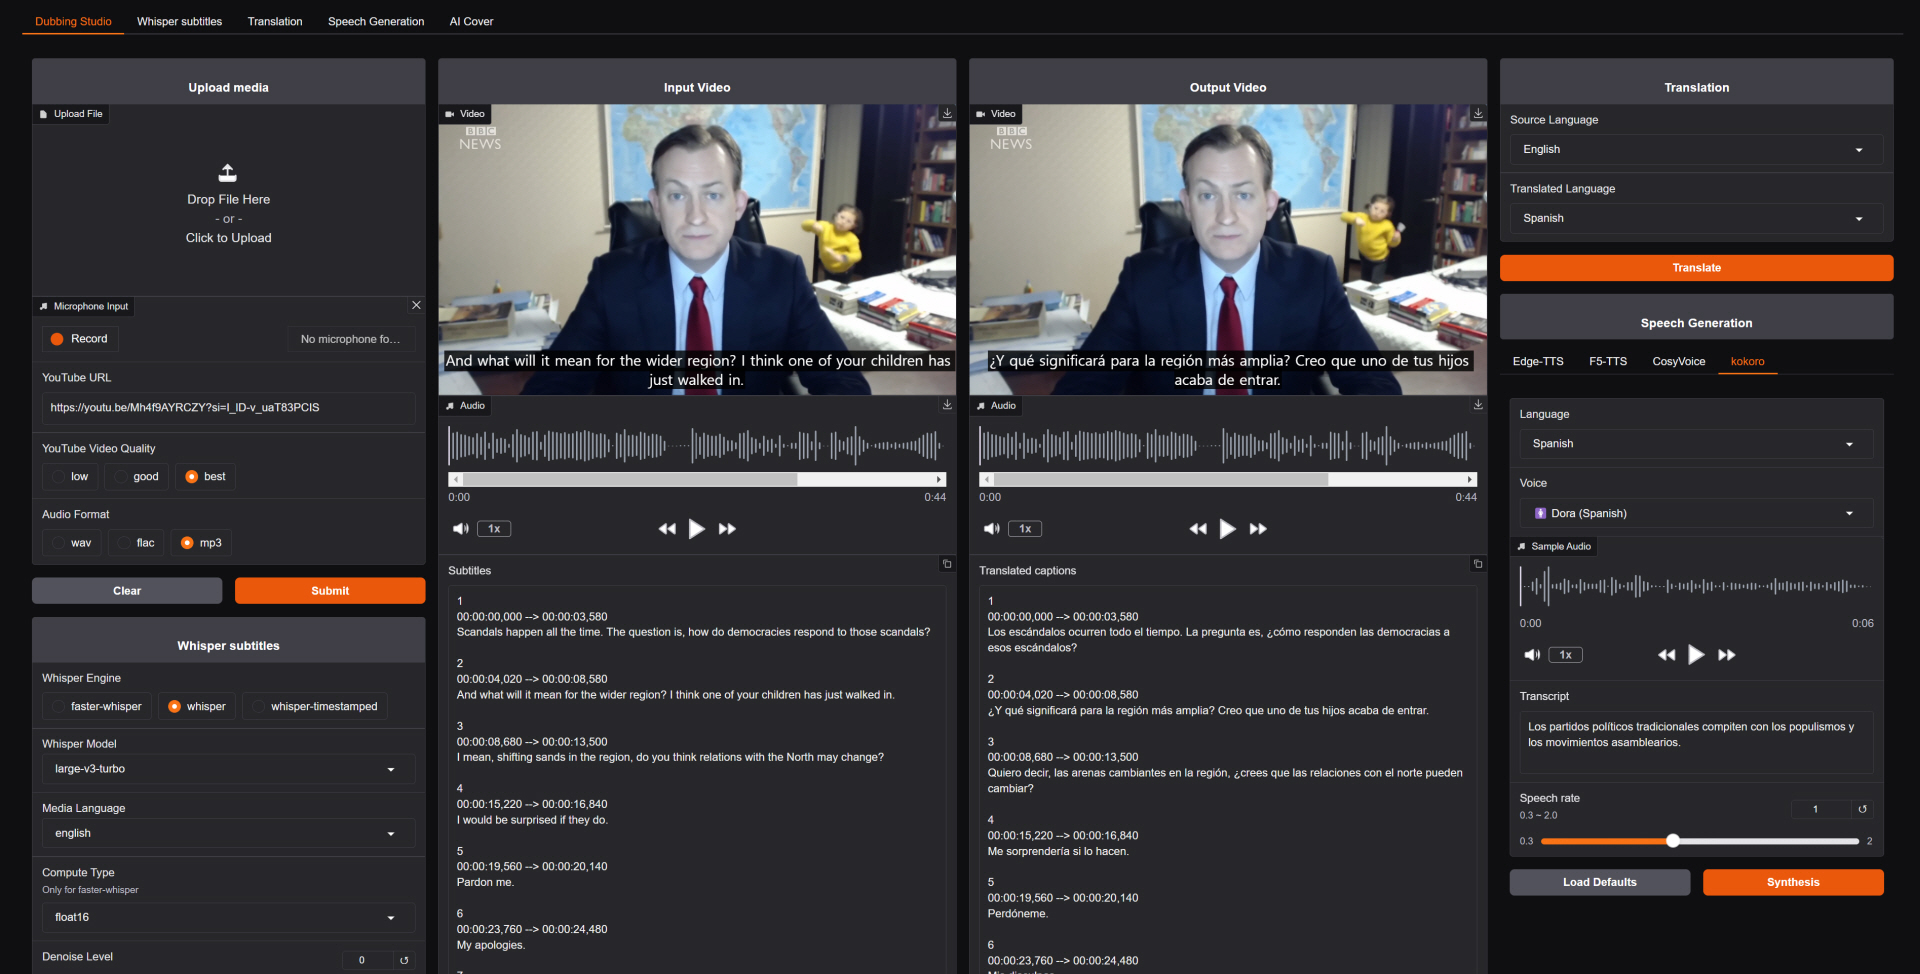
Voice-Pro 是一款面向创作者和开发者的 AI 音频全流程处理工具,由韩国创业公司 ABUS 开发,基于 Gradio WebUI 构建。它将视频下载、音频分离、语音识别、多语言翻译、文本转语音(TTS)和零样本声音克隆集成到一个统一的 Web 界面中,定位为 ElevenLabs 的开源替代方案。核心价值在于将传统需要 5-8 个工具配合的流程(下载、分离、识别、翻译、配音、字幕)串联成一条自动化管道,用户只需输入视频链接,即可获得多语言配音视频和字幕。工具支持四种 Whisper 变体用于语音识别,三种零样本声音克隆引擎(F5-TTS、E2-TTS、CosyVoice),以及 Edge-TTS、kokoro 等多语言 TTS。完全开源免费,本地运行,数据不出机器。需要 NVIDIA GPU(最低 4GB 显存,推荐 8GB+),首次部署需下载模型,耗时较长。
一套分层锁定的AI生图提示词架构,将专业摄影参数硬性锁定,仅开放客户定制区,实现标准化接单交付。
AI形象照接单级模板提示词是一套结构化的AI生图提示词工程方法论,旨在将Midjourney、Flux、GPT Image等AI图像生成工具的输出质量从“塑料感”提升到商业影楼级写真水准,并实现标准化接单交付。其本质是分层锁死的提示词架构:将摄影参数(镜头、光位、胶片质感)硬性锁定,仅暴露客户定制区(动作、穿搭、修饰)作为可变变量。用户只需复制模板、填入客户需求、让LLM生成最终提示词,并配合客户原始照片垫图出图。该方法论解决了传统AI生图的六大痛点,包括“塑料微商味”、非标交付、摄影知识门槛、客户需求翻译困难、效率低下和AI发散不可控。核心思想是“锁定底层参数,只动客户变量”,通过三层分离架构(客户定制层、项目设定层、摄影锁定层)实现。报告还提供了五套风格模板(影楼级黑白写真、王家卫复古港风、法式冷金油画感、美漫赛博硬核风、时装型录Lookbook),以及标准接单出图流程、工具环境、常见问题排查和优缺点分析。