历史技术报告
保留历史 AI 报告前三章的 Markdown 排版;以下说法未重新逐项核实,请结合原始来源阅读。
第一章:技术概述
什么是 LLM-Wiki
LLM-Wiki 是一套关于 AI Agent 如何建立和维护自己的知识体系 的最佳实践方法论,由卡比卡比(@jakevin7,OpenCLI 核心开发者,Apache Arrow/Doris PMC 成员)设计并开源。它将传统的人类知识库工具(如 Obsidian、Notion)重新定义为 Agent-native 工具——由 Agent 写、给 Agent 和人类读。
项目定位
- 所属体系:AI Agent × 知识管理 × Agent Team 架构
- 作者:jakevin7(卡比卡比),OpenCLI 项目核心贡献者
- 运行平台:已集成到 OpenCLI(16.6k Stars)的项目管理中
- 兼容性:知识产物兼容 Obsidian 格式,可直接用 Obsidian 查看
- 许可协议:开源(具体协议待确认)
核心主张
Vault 是 Agent 的外脑。 LLM-Wiki 把"知识库"从人类工具变成了 Agent-native 工具:由 Agent 写,给 Agent 和人类读。
解决的问题
传统知识管理工具是为人类设计的——人类手动整理笔记、手动建立链接、手动维护索引。但在 AI Agent 的工作流中,Agent 本身就是最大的知识生产者和消费者。LLM-Wiki 让 Agent 成为自己的知识管理员,实现知识库随使用自增长。
第二章:问题背景与痛点
传统 AI Agent 知识管理的五大痛点
当 Agent 变得越来越强大,它的"记忆力"却成了最大的瓶颈。1. Agent 没有"长期记忆"
大多数 AI Agent(包括 Claude Code、Cursor 等)的上下文窗口有限,对话结束后记忆就消失了。虽然有些工具提供了 memory 机制,但往往只是简单的 key-value 存储,缺乏结构化知识体系。
2. 人类知识库 ≠ Agent 知识库
Obsidian、Notion、飞书文档——这些工具的 UI 和交互是为人类设计的。Agent 无法高效使用它们来"思考"。Agent 需要的是:
- 可以被程序化读写的格式
- 支持自动链接和推理的结构
- 可以被搜索和查询的知识图谱
3. 知识碎片化
Agent 在工作中产生的知识散落在:
- 代码注释里
- commit message 里
- 对话历史里
- 临时文件里
- 各种工具的私有存储里
没有一个统一的"知识汇聚点"。
4. 知识不增值
传统知识库是静态的——写入后就不会再变化。但 Agent 的知识应该是活的:每次查询都可能产生新的综合(synthesis),新的综合应该写回知识库,让知识库越来越完整。
5. Agent Team 缺乏"集体记忆"
当多个 Agent 协作时,它们之间的知识传递靠的是 prompt 中的上下文传递,效率低且容易丢失。需要一个共享的、Agent 可读写的知识空间。
LLM-Wiki 本质上优化的链路
知识生产层:从"人类手动整理"优化为"Agent 自动摄入" 知识消费层:从"人类搜索"优化为"Agent 查询 + 自动综合" 知识增长层:从"静态文档"优化为"每次查询都可能增值"
第三章:核心思想
一句话本质
LLM-Wiki = Agent 的 Obsidian,但由 Agent 自己维护。 不是给人用的笔记工具,而是 Agent-native 的知识操作系统。
三大核心理念
1. Agent-native 知识库
传统知识库是人类写、人类读。LLM-Wiki 是Agent 写、Agent 和人类读。维护者是 Agent 本身,不是人类。GUI 只做展示用(初始阶段 Obsidian 已足够)。
2. 知识复利
每次查询都可能让知识库变得更完整。当 /query 的答案连接了 3 个以上页面、产生了新的综合(synthesis),就写回 wiki。这意味着知识库是自增长的——使用越多,越完整。
3. 三层知识隔离
sources/     ← 原始材料(不可修改)
wiki/        ← 提炼知识(Agent 维护)
wiki-log.md  ← 操作日志(审计追踪)
源文件永远不被修改,提炼知识与原始材料隔离,所有操作有日志可追溯。
类比理解
| 维度 | 传统知识库 | LLM-Wiki |
|---|---|---|
| 谁写 | 人类 | Agent |
| 谁维护 | 人类 | Agent(Wiki Agent) |
| 谁读 | 人类 | Agent + 人类 |
| 格式 | Markdown / 富文本 | Obsidian-flavored Markdown + 知识图谱 |
| 增长方式 | 人工添加 | 自动摄入 + 查询写回 |
| 适用场景 | 个人笔记 / 团队 Wiki | Agent Team 的集体外脑 |
项目概览
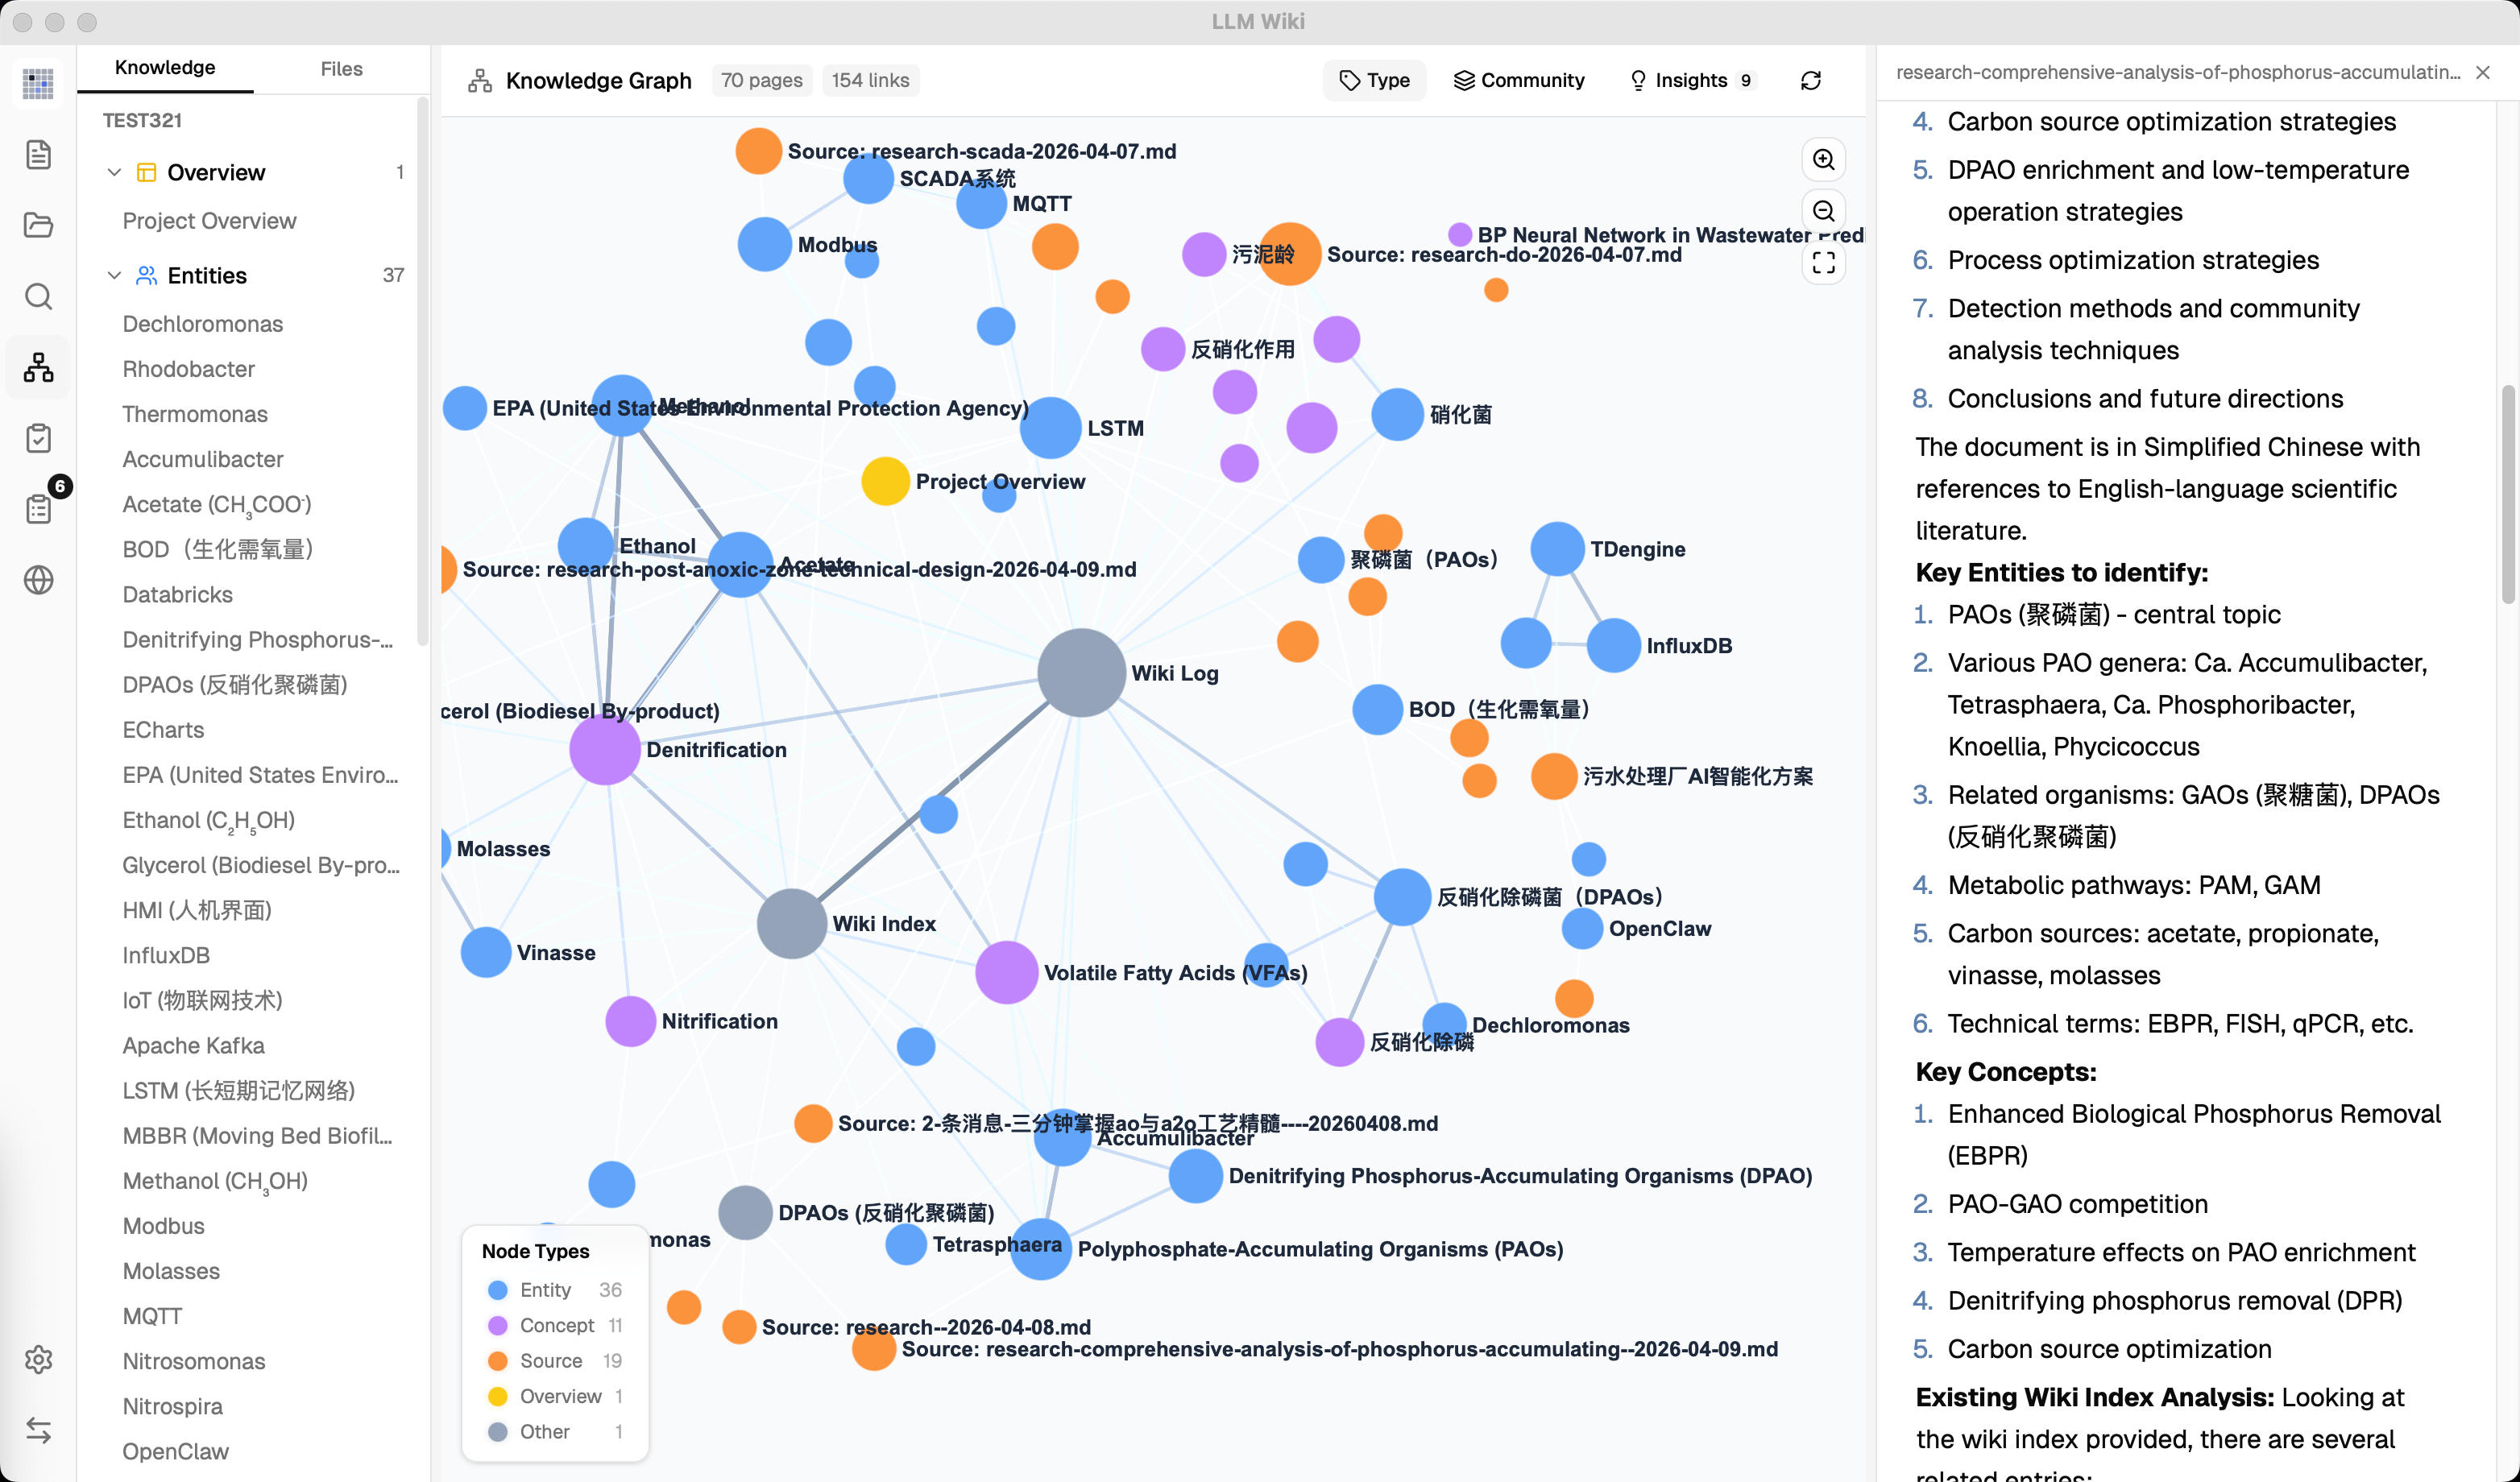
LLM-Wiki 是一套关于 AI Agent 如何建立和维护自身知识体系的最佳实践方法论,由卡比卡比(@jakevin7)设计并开源。其核心主张是“Vault 是 Agent 的外脑”,将传统知识库工具重新定义为 Agent-native 工具——由 Agent 写,给 Agent 和人类读。它通过 /ingest(知识摄入)、/query(知识查询与写回)、/lint(健康检查)、/research(外部研究)四个操作形成闭环,实现知识库随使用自增长。知识采用三层隔离:sources/ 存放不可修改的原始材料,wiki/ 存放 Agent 维护的提炼知识,wiki-log.md 记录操作日志。产物兼容 Obsidian 格式,可直接用 Obsidian 查看知识图谱。项目已集成到 OpenCLI 的项目管理中,其核心理念也可独立于 OpenCLI 实现。
使用前需要了解
- AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
- 报告明确说明 LLM-Wiki 不适合以下场景:一次性任务(知识不需要积累);纯人类团队的知识管理(没有 Agent 参与);需要实时协作的 Wiki(多人类同时编辑);高度机密的知识(不适合 Agent 自由访问);非文本知识为主(图片、视频等多媒体)。报告也指出其局限:文本知识为主,不适合管理多媒体知识;目前设计为单项目单 vault,跨项目知识共享需要额外设计;如果没有 Agent 维护,LLM-Wiki 就只是一个空的目录结构;Agent 写入的知识可能有幻觉或错误,需要 /lint 和人类审查。报告还提到,项目目前仅在 OpenCLI 社区有实际运行经验,尚未大规模验证;当 wiki 页面数达到数千级别时,检索效率可能成为瓶颈;初期不做 GUI,非技术用户上手有门槛。关于 GitHub 仓库,报告说明帖子提到 repo 链接在评论区(需登录查看),当前未能直接获取仓库代码。