从零开始用 PyTorch 原生实现并训练 GPT 风格语言模型的开源项目
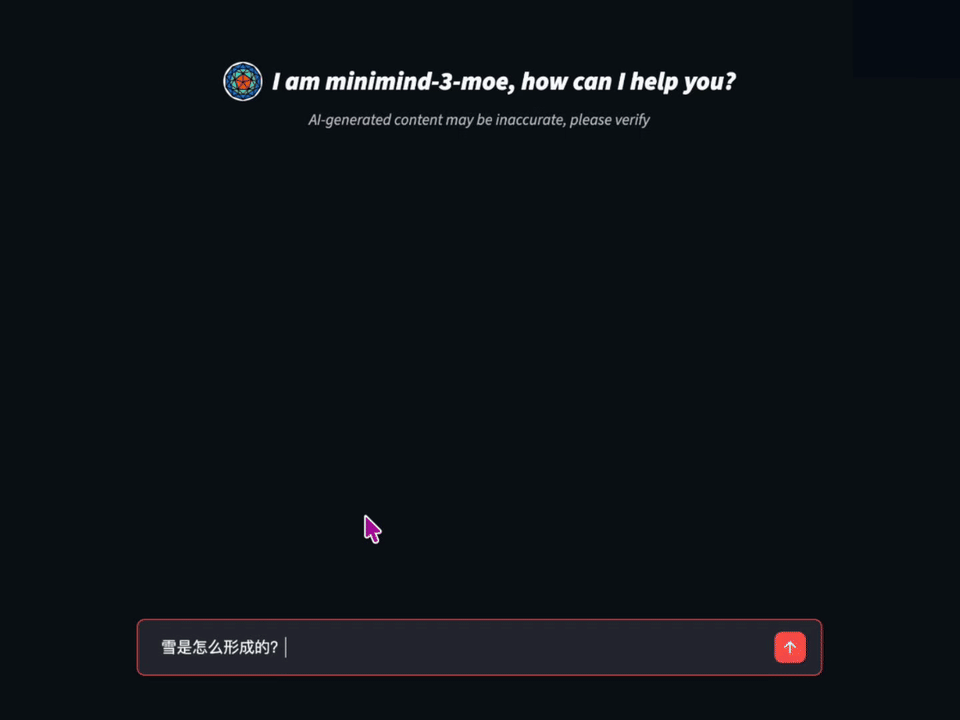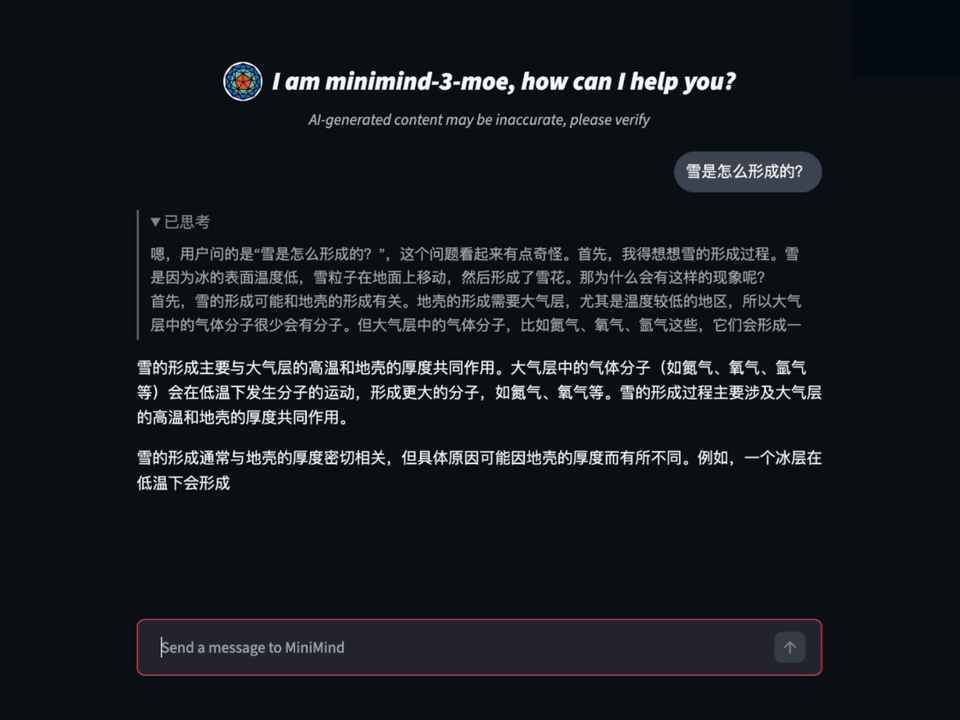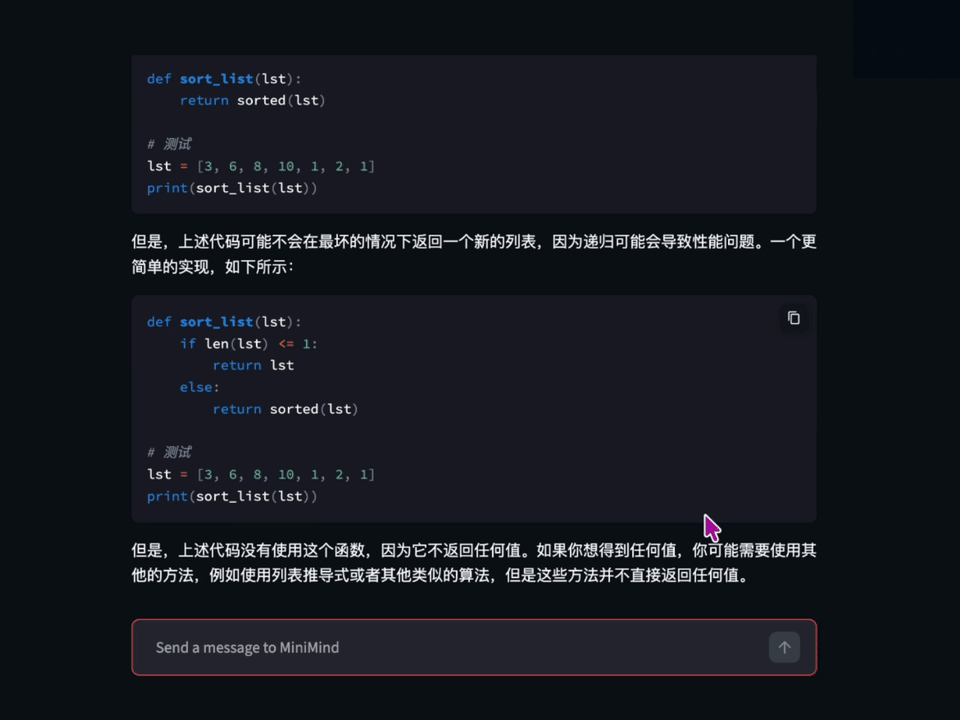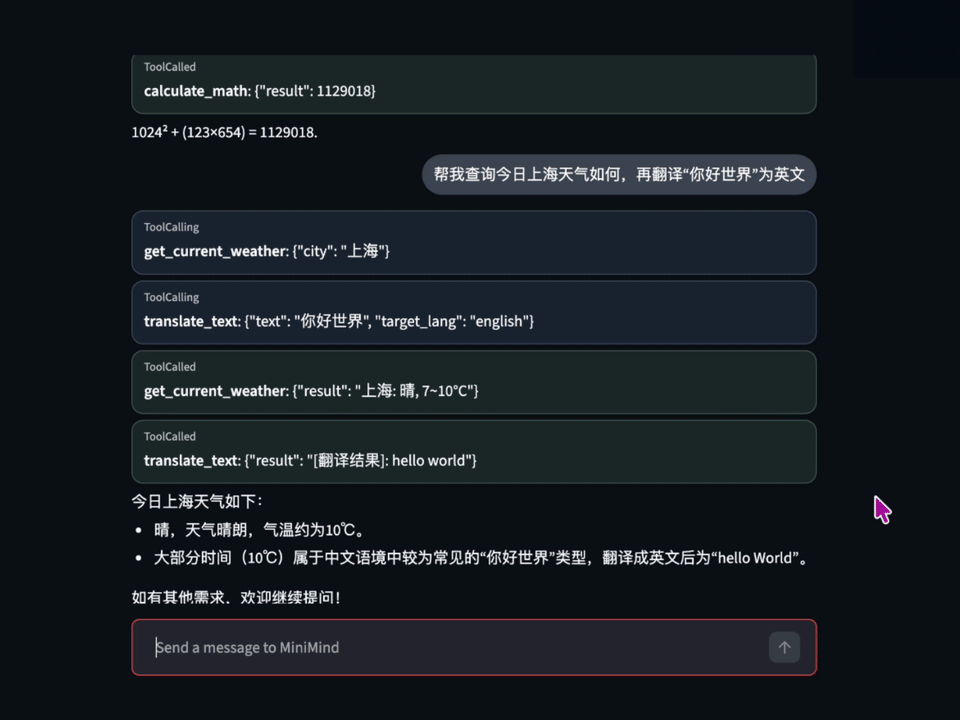
MiniMind 是一个开源项目,目标是从绝对零开始训练一个 GPT 风格的语言模型。项目没有使用任何第三方框架的高级抽象,所有核心算法代码均使用 PyTorch 原生实现,开发者可以逐行阅读、理解、修改每一处计算逻辑。项目覆盖了从预训练、SFT 到 DPO 的完整训练链路,并支持推理、多模态、工具调用等能力。其最小模型为 26M 参数,最低硬件要求为单张 NVIDIA 3090,最短训练时间约 2 小时。项目强调“大道至简”的理念,不追求 SOTA,而是追求“最小可理解”,旨在帮助开发者理解 LLM 的每个组件如何工作。同时,项目兼容 llama.cpp、vllm、ollama 等推理部署方案,并兼容 OpenAI API,可接入 FastGPT、Open-WebUI。
 openai/privacy-filter
OpenAI 开源的本地化 PII 检测与脱敏模型,支持 128K 长文本与浏览器端运行
OpenAI Privacy Filter 是 OpenAI 于 2026 年 4 月 17 日开源的双向 Token 分类模型,专注于文本中个人可识别信息(PII)的检测与脱敏,属于 NLP 安全/隐私合规技术体系。其核心定位是为企业级数据清洗流水线提供一个可本地部署、高速、上下文感知且可调优的 PII 检测模型。模型采用自回归预训练加双向分类微调的方式,总参数量 1.5B,但通过稀疏 MoE 架构,每个 Token 仅激活 50M 参数,可在浏览器和笔记本上运行。模型支持 128,000 tokens 的上下文窗口,使用带状注意力将计算复杂度从 O(n²) 降至 O(n×w)。它可检测账号、私人地址、私人邮箱、人名、电话号码、私人 URL、私人日期等 8 类 PII,并通过约束 Viterbi 解码保证标签序列连贯。模型采用 Apache 2.0 许可证,支持 PyTorch、ONNX、Transformers.js 等多种部署格式。