跳到主要内容
ATLAS (Adaptive Test-time Learning and Autonomous Specialization) · prolist
查看仓库原始简介 Adaptive Test-time Learning and Autonomous Specialization
来自项目 README 项目解读 README
项目解读由 AI 根据历史资料整理,尚未经人工复核。仓库资料更新于 2026-09-08,与历史解读分开保留。
项目概览 ATLAS(Adaptive Test-time Learning and Autonomous Specialization)是一个完全本地化、无需 API 的 AI 编程助手,由 Virginia Tech 商学院学生 Isaac Tigges 独立开发,采用 AGPL-3.0 开源许可。其核心思路是冻结小模型(如 Qwen3-14B),通过智能推理基础设施在推理阶段提升输出质量,而非微调模型。在 RTX 5060 Ti 16GB 显卡上,ATLAS 在 LiveCodeBench v5 上达到 74.6% pass@1-v(k=3) 的分数,接近 GPT-5 和 Claude 4.5 的水平。其 V3 Pipeline 包含三阶段:候选生成(PlanSearch、BudgetForcing、DivSampling)、Lens 路由评分和 PR-CoT 自验证迭代修复。ATLAS 支持 8 个工具调用,通过语法约束解码保证 JSON 输出格式正确,并采用 T1/T2 文件分级机制智能路由简单与复杂任务。主要优势是 100% 本地运行、零 API 成本(每任务约 $0.004 电费)和数据隐私,但需要 16GB VRAM 的 NVIDIA GPU,安装复杂且仅支持 Linux。
解决什么问题
API 模型成本高、有隐私风险、需要网络连接。
小模型直接使用效果差,Qwen3-14B 原始 pass@1 只有 54.9%。
编程场景需要结构化输出(JSON 工具调用),小模型格式不稳定。
微调成本高且不灵活,任务变化需要重新微调。
缺少自验证机制,错误代码直接进入最终输出。
工作方式
核心思想是“模型写代码,基础设施让它可靠”,不微调模型,而是通过工程手段弥补模型不足。
V3 Pipeline 三阶段架构:Phase 1 候选生成(PlanSearch 规划搜索、BudgetForcing 预算强制、DivSampling 多样性采样,生成 K=3 个候选方案);Phase 2 Lens 路由(使用能量模型对候选打分,分数 = C(x)/G(x),选出最高分方案);Phase 3 自验证迭代修复(PR-CoT 过程修复链,模型自己生成测试用例、分析失败原因、迭代修复)。
工具调用 Agent 循环:CLI 版本将 Pipeline 包装为交互式工具调用循环,支持 8 个工具(read_file、write_file、edit_file、delete_file、run_command、search_files、list_directory、plan_tasks)。
文件分层机制:T1 文件(配置文件、样板代码)直接写入,T2 文件(复杂逻辑功能文件)自动路由到 V3 Pipeline。
核心组件包括 llama-server(模型推理)、geometric-lens(能量模型评分)、v3-service(Pipeline 编排)、sandbox(安全执行环境)、atlas-proxy(本地代理)。
部署架构为 Docker Compose 单机部署,包含 5 个服务。
核心能力
% 本地运行,数据不离开机器,零隐私风险。
零 API 成本,纯电费运行,约 $0.004/任务。
离线可用,下载模型后完全不需要网络。
V3 Pipeline 创新,PlanSearch + PR-CoT 是原创的推理增强方案。
Grammar Constrained Decoding 保证 100% 合法的 JSON 工具调用输出。
自验证修复,85.7% 的失败任务可以通过 PR-CoT 救回。
开源(AGPL-3.0),完全可审计。
T1/T2 文件分级,简单文件直接写,复杂文件走完整 Pipeline。
使用前需要了解
AI 整理 · 本地测试,未经人工复核;依据历史报告节选,不代表当前产品状态。
需要 GPU,最低 16GB VRAM,没有 GPU 就完全不能用。
74.6% 是 pass@1-v(k=3),不是真正的单次生成准确率,不能直接和 API 模型的 pass@1 比较。
CLI 用的 9B 模型还没有跑过 LCB 正式测试。
推理速度慢,Grammar Constrained 约 51 tok/s,比 API 慢很多。
安装复杂,需要 Docker + nvidia-container-toolkit + Go,门槛不低。
目前只支持 Linux(RHEL/Ubuntu/Arch)。
简体中文 · AI 译文 原文
AI 中文译文,非官方翻译;安装命令与技术细节请对照原文。
由一个商学院学生独立开发,可持续性存疑。
不擅长复杂功能添加,L6 测试(给现有项目加 JWT 认证)只有 67% 通过率。
推理时间 trade-off,用更多时间换取更高准确率,不适合需要快速响应的场景。
9B 模型的推理能力上限决定了它能处理的任务复杂度。
Phase 2(Lens 路由)效果不明显,消融实验显示 Phase 2 没有带来额外提升。
PR-CoT 修复成功率是 85.7%(36/42),不是 100%,某些类型的错误(如架构级问题)无法处理。
不是编辑器插件,没有实时的代码补全、内联建议等 IDE 集成功能。
将算力花在关键处。 简单的编辑走更短的路径,而更困难的任务则获得更多候选、推理与验证。
运行您自己的模型。 在支持 NVIDIA、AMD、Apple Silicon、Vulkan 或 CPU 的硬件上使用兼容的 GGUF 模型。
保持本地控制。 ATLAS 不会故意将您的仓库或提示上传到托管模型或 ATLAS 运营的服务。沙盒命令默认具有出站网络访问权限;设置 ATLAS_SANDBOX_NET_INTERNAL=true 可禁用它。
拥有完整技术栈。 ATLAS 是开源且自托管的。它不需要托管模型或第三方模型提供商的 API 密钥;本地每次安装的服务令牌用于验证 ATLAS 服务。
📰 最新动态
2026-07-06 - V3.1.3 "Maia" 发布 2026-06-17 - V3.1.2 "Maia" 发布 2026-05-12 - V3.1.0 "Maia" 发布 2026-03-26 - Hacker News 首页 - 489 分,285 条评论2026-03-05 - V3.0 发布 方法论 )2026-02-18 - V2.0 发布
⭐ Star 历史 每周更新(周一,通过 GitHub Actions)。
🧱 ATLAS 的功能
atlas-tui atlas 即可启动。
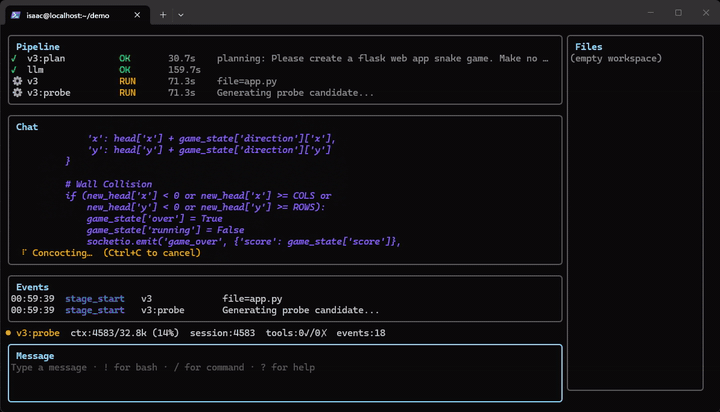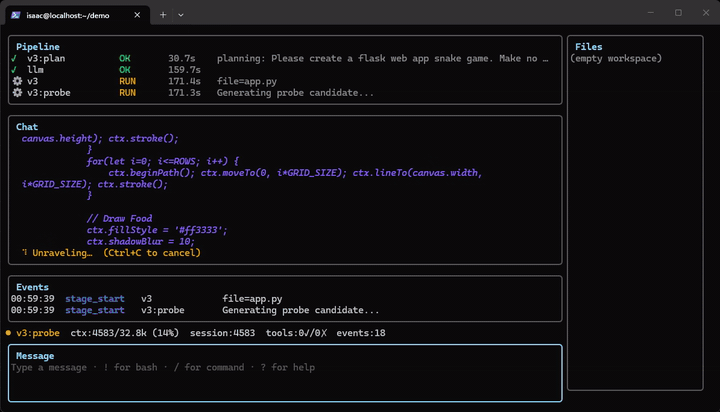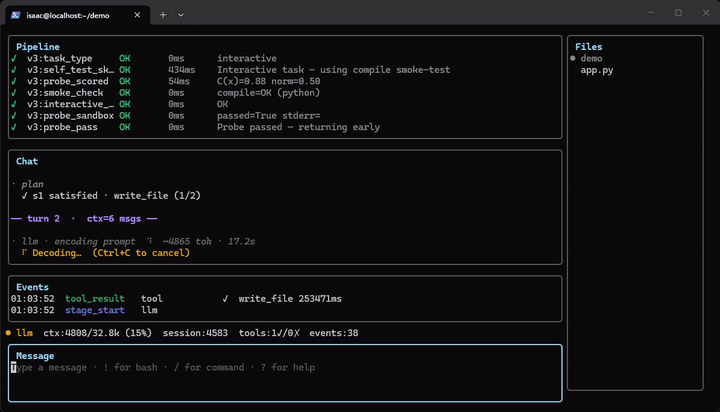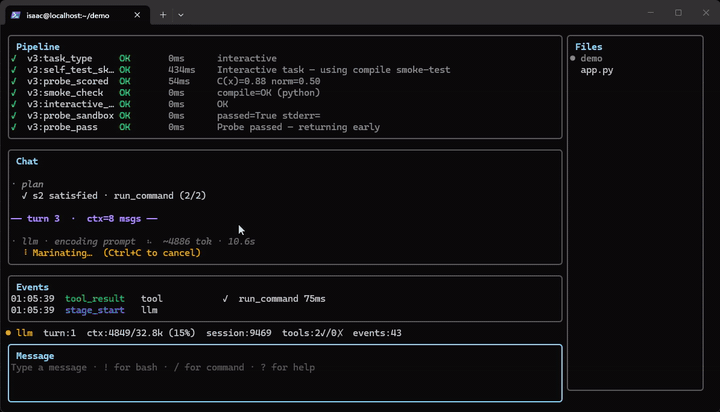
实时流水线视图 - 在侧边栏中观看 V3 阶段流式进行斜杠命令 - /add、/diff、/commit、/run 用于本地文件上下文与外部命令调用输入模式 - 聊天、!bash 和 /slash,带提示下拉菜单
atlas-proxy
工具调用路由 - 按复杂度层级对文件操作进行分类语法强制 - GBNF 模式强有力地引导输出符合预期的 JSON 结构,并在代理端对格式错误或截断的输出进行恢复BiasBusters - 四种组合缓解措施(描述、语法禁止、系统说明、ASA 引导),推动模型在结构性代码编辑时采用 structural_edit安全限制 - 轮次上限、token 预算、超时
V3 流水线
Geometric Lens 什么是“Geometric Lens”? )
C(x) 成本场 - 模型隐藏维度→512→128→1 的 MLP,用于评分候选质量G(x) 质量预测 - 用于选择的 XGBoost 集成逐步评分 - 对写入进行逐 token 的 C(x)/G(x) 评分,并通过每个模型校准的阈值驱动干预模式缓存 - 来自先前会话的经验,注入到新运行中
沙盒
多语言执行:Python、Rust、Go、C、Shell 等
评分前先进行编译与 lint 检查
运行生成的与现有的测试套件
llama-server
GPU 加速的量化推理(Q6_K / Q4_K_M)- NVIDIA CUDA、AMD ROCm、Apple Metal(macOS 混合)与 Vulkan;Intel SYCL 在路线图中
在 token 级别进行语法约束解码
自嵌入,因此 Lens 不需要第二个模型
🚀 快速开始 curl -fsSL https://raw.githubusercontent.com/itigges22/ATLAS/main/scripts/atlas-bootstrap.sh | bash
不想将动态脚本直接通过管道传给 bash?同样的安装程序,还有两种更谨慎的运行方式:
# Pinned to a release: script, checkout, and images all at the signed tag
curl -fsSL https://raw.githubusercontent.com/itigges22/ATLAS/v3.1.3/scripts/atlas-bootstrap.sh \
  | ATLAS_BOOTSTRAP_REF=v3.1.3 bash

# Review before running
curl -fsSL -o atlas-bootstrap.sh https://raw.githubusercontent.com/itigges22/ATLAS/main/scripts/atlas-bootstrap.sh
less atlas-bootstrap.sh
bash atlas-bootstrap.sh
该脚本会检测你的发行版(Ubuntu、Debian、RHEL、Fedora、Rocky、Alma)和 GPU 厂商(NVIDIA → nvidia-container-toolkit;AMD → ROCm 设备直通),安装相应的运行时,下载模型权重,构建 ASA 转向向量,并启动整个技术栈。预计需要 10-30 分钟;模型下载是主要瓶颈。
Apple Silicon 通过 macOS 混合 Metal 路径原生运行(原生 llama-server + Docker 用于其余部分 - 请参阅 SETUP_MACOS.md SETUP.md
⚠️ 已知限制
Linux Docker 技术栈,外加原生 macOS 路径。 目前存在 NVIDIA(支持)、AMD ROCm(社区测试)和 Vulkan(预览)Docker 路径;Apple Silicon(支持)通过原生 macOS 混合 Metal 路径运行(#32 )。Intel Arc / SYCL 在路线图中。级别定义:SUPPORT_MATRIX.md 。当前注册表模型尚未经过正式基准测试。 规范的 74.6% LiveCodeBench 分数来自冻结的 14B 参考构建。新的模型特定数据在 #28 中跟踪。参考方法和消融实验位于 docs/reports/V3_ABLATION_STUDY.mdHuggingFace 上。复杂功能添加可能不一致。 紧凑型模型有时会在编写代码前花费代理回合探索不熟悉的代码库。通过 V3.1.2 代理可靠性改进,可靠性已得到提升;新的模型特定数据在 #28 中跟踪。语法约束解码速度较慢。 在 llama-server 上约为 51 tok/s。
🗺️ 路线图 V3.1.3 "Maia" - 当前版本。在 V3.1.2 基础上进行生产平台改进:分阶段 atlas upgrade/rollback 并自动恢复,用 SQLite 状态存储替换 Redis(ADR 0007 ),签名工件清单,带跨服务关联 ID 的结构化 JSON 日志,交互式权限提示,会话恢复,类型化配置验证/迁移,以及两次对抗性错误修复扫描(确认修复 33 个问题)。
V3.1.2 "Maia" - 更广泛的硬件支持、自带模型训练,以及在 V3.1.0 基础(TUI、一键安装、流式 Lens + ASA)上的代理可靠性改进。
硬件支持:通过 llama.cpp 支持 AMD ROCm,包括 RDNA4 / RX 9070(gfx1200/gfx1201)(#26 );Apple Silicon 原生 macOS 混合 Metal 路径(#32 ,参见 SETUP_MACOS.md );Vulkan 通用回退,覆盖 AMD / Intel / Snapdragon / Apple-via-MoltenVK / CPU(#114 )。
自带模型:本地 Lens 训练流水线(atlas lens build / retrain,#100 )和 ASA 每模型校准一致性(atlas asa check/build/publish,#113 ) - 为额外的 GGUF 模型训练 Lens + ASA 工件,并附带随 lens 发布的每模型操作阈值。
循环内 lens 训练:在 TUI 中评分(/good · /bad · /review · /deny)→ 收集加权样本 → 在你自己的工作负载上运行 atlas lens retrain。
代理可靠性:工具结果可见性修复、读取去重、回溯 → 定向编辑、move_file、pip 安装 / 大小写不匹配引导、沙箱 shell 策略 + 主机级 cgroup 限制。
结构化调用图推理(#39 / #125 ,感谢 @yogthos );ARCHITECTURE.md 已翻译为 zh-CN / ja / ko(#25 )。
硬件:ARM64 多架构构建(#115 )、用于更大模型的多 GPU(#34 )、Intel oneAPI / SYCL(#27 )。
工具:VS Code / JetBrains 扩展(#35 )。
沙箱语言:Java / Kotlin(#29 )、Ruby / PHP(#30 )。
架构:模型无关平台(#66 )。
❤️ 支持 ATLAS
计算与硬件 - 更多 GPU 以加快基准测试迭代,访问维护者无法负担的架构(AMD ROCm、更高显存的显卡、用于更大模型实验的云租赁)。贡献者赏金 - 为投入实际时间参与实质性 PR 的外部贡献者提供有意义的报酬,使 ATLAS 能够以超越单人节奏的速度成长。研究 - 围绕架构持续开展学术合作,从未来的研讨会和会议投稿,到论文撰写和合作,以验证并扩展该方法。社区 - 持续支持 ATLAS 所运行的社区和平台,包括文档、面向用户的渠道以及教育内容,帮助 ATLAS 触达更多开发者,并更好地服务现有用户。
🤝 贡献 ATLAS 是开放开发的,欢迎贡献者和核心维护者。错误修复、加速器支持以及更大的子系统工作均受欢迎。
发现错误或遇到障碍?提交 Issue
📄 许可证 09.08